Appearance
名词解释
消息的概念
从广义角度来说,消息其实就是信息,但是和信息又有所不同。信息通常被定义为一组数据,而消息除了具有数据的特征之外,还有消息的来源与接收的概念。通常发送消息的一方称为消息的生产者,接收消息的一方称为消息的消费者。
为什么要设置生产者和消费者呢?这就是要说到消息的意义了。信息通常就是一组数据,但是消息由于有了生产者和消费者,就出现了消息中所包含的信息可以被二次解读,生产者发送消息,可以理解为生产者发送了一个信息,也可以理解为生产者发送了一个命令;消费者接收消息,可以理解为消费者得到了一个信息,也可以理解为消费者得到了一个命令。对比一下就会发现信息是一个基本数据,而命令则可以关联下一个行为动作,这样就可以理解为基于接收的消息相当于得到了一个行为动作,使用这些行为动作就可以组织成一个业务逻辑,进行进一步的操作。总的来说,消息其实也是一组信息,只是为其赋予了全新的含义,因为有了消息的流动,并且是有方向性的流动,带来了基于流动的行为产生的全新解读。开发者就可以基于消息的这种特殊解,将其换成代码中的指令。
对于消息的理解,初学者总认为消息内部的数据非常复杂,这是一个误区。比如发送了一个消息,要求接受者翻译发送过去的内容。初学者会认为消息中会包含被翻译的文字,已经本次操作要执行翻译操作而不是打印操作。其实这种现象有点过度解读了,发送的消息中仅仅包含被翻译的文字,但是可以通过控制不同的人接收此消息来确认要做的事情。例如发送被翻译的文字仅到A程序,而A程序只能进行翻译操作,这样就可以发送简单的信息完成复杂的业务了,是通过接收消息的主体不同,进而执行不同的操作,而不会在消息内部定义数据的操作行为,当然如果开发者希望消息中包含操作种类信息也是可以的,只是提出消息的内容可以更简单,更单一。
对于消息的生产者与消费者的工作模式,还可以将消息划分成两种模式,同步消费与异步消息
- 同步消息就是生产者发送完消息,等待消费者处理,消费者处理完将结果告知生产者,然后生产者继续向下执行业务。这种模式过于卡生产者的业务执行连续性,在现在的企业级开发中,上述这种业务场景通常不会采用消息的形式进行处理。
- 异步消息就是生产者发送完消息,无需等待消费者处理完毕,生产者继续向下执行其他动作。比如生产者发送了一个日志信息给日志系统,发送过去以后生产者就向下做其他事情了,无需关注日志系统的执行结果。日志系统根据接收到的日志信息继续进行业务执行,是单纯的记录日志,还是记录日志并报警,这些和生产者无关,这样生产者的业务执行效率就会大幅度提升。并且可以通过添加多个消费者来处理同一个生产者发送的消息来提高系统的高并发性,改善系统工作效率,提高用户体验。一旦某一个消费者由于各种问题宕机了,也不会对业务产生影响,提高了系统的高可用性。
中间件的概念
中间件:独立于系统之外的一个服务器。以上是几种常用中间件介绍:
- Tomcat 也叫web中间件,提供web服务。
- Redis 也叫中间件。提供缓存服务。
- JMS 中间件,提供的就是消息服务
消息队列中间件
消息队列中间件是分布式系统中重要的组件,主要解决应用耦合,异步消息,流量削锋等,实现高性能,高可用,可伸缩和最终一致架构。使用较多的消息队列有 ActiveMQ,RabbitMQ(常用),ZeroMQ,Kafka(最新),MetaMQ,RocketMQ(常用)。
通过消息中间件,减轻在大量并发访问时候服务器压力。主要是在分页式系统中,通过消息服务系统解决高并发访问的情况处理,提高系统处理效率。
消息处理技术标准规范
目前企业级开发中广泛使用的消息处理技术分以下几大类:
- JMS
- AMQP
- MQTT
- STOMP
以上均为规范,开发针对规范开发,运行时实现。这三类规范都是针对异步消息进行处理的,也符合消息的设计本质,处理异步的业务。
JMS
概述
JMS 即 Java 消息服务(Java Message Service)应用程序接口,是一个 Java 平台中提供关于面向消息中间件(MOM)的统一消息通信的标准 API,用于在两个应用程序之间,或分布式系统中发送消息,使分布式系统通信耦合度更低,消息服务更加可靠以及进行异步通信。
JMS 能够通过消息收发服务(有时称为消息中介程序或路由器)从一个 JMS 客户机向另一个 JMS 客户机发送消息。那么使用 Java 消息服务解决了什么问题?
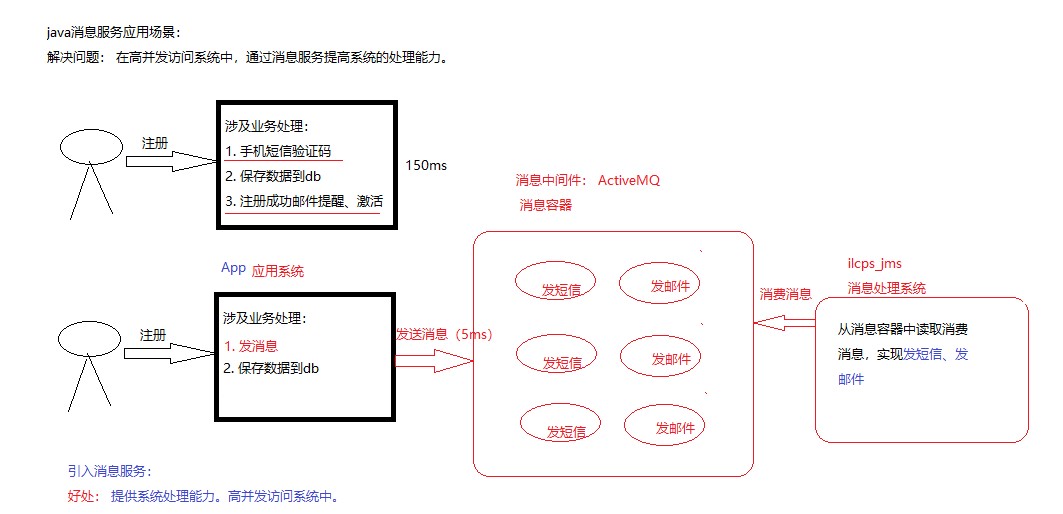
在 EJB 架构中,有消息 bean 可以无缝的与 JMS 消息服务集成。在 J2EE 架构模式中,有消息服务者模式,用于实现消息与应用直接的解耦。
JMS 消息种类
消息是 JMS 中的一种类型对象,由两部分组成:报头和消息主体。报头由路由信息以及有关该消息的元数据组成。消息主体则携带着应用程序的数据或有效负载。根据有效负载的类型来划分,根据消息中包含的数据种类划分,可以将消息划分成 6 种消息。
- TextMessage(简单文本)
- MapMessage(属性集合)
- BytesMessage(字节流)
- StreamMessage(原始值流)
- ObjectMessage(可序列化的对象)
- Message(无有效负载的消息,只有消息头和属性)
JMS 主张不同种类的消息,消费方式不同,可以根据使用需要选择不同种类的消息。整体上来说,JMS 严格按照 J2EE 的规范,定义若干个标准,每个标准下又提供一些 API。目前对 JMS 规范实现的消息中间件技术还是比较多,例如 ActiveMQ、Redis、HornetMQ。但是也有一些不太规范的实现,参考 JMS 的标准设计,但是又不完全满足其规范,例如:RabbitMQ、RocketMQ。
JMS 消息模型
在 JMS 标准中,有两种消息模型:
- P2P (Point to Point) 点对点模型(Queue队列模型)
- Publish/Subscribe(Pub/Sub) 发布/订阅模型(Topic主题模型)
P2P模型(点对点模型)
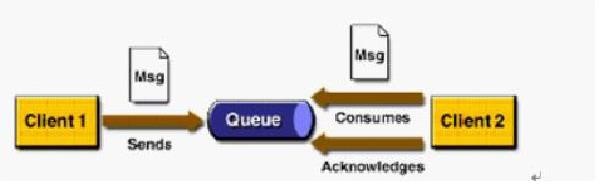
点对点模型:peer-2-peer,生产者会将消息发送到一个保存消息的容器中,通常使用队列模型,使用队列保存消息。一个队列的消息只能被一个消费者消费,或未被及时消费导致超时。这种模型下,生产者和消费者是一对一绑定的。
P2P 模型图
P2P 涉及概念
- 消息队列(Queue)
- 发送者(Sender)
- 接收者(Receiver),消费者
每个消息都被发送到一个特定的队列,接收者从队列中获取消息。队列保留着消息,直到他们被消费或超时。
P2P 的特点
- 每个消息只有一个消费者(Consumer)(即一旦被消费,消息就不再在消息队列中)
- 发送者和接收者之间在时间上没有依赖性,也就是说当发送者发送了消息之后,不管接收者有没有正在运行,它不会影响到消息被发送到队列
- 接收者在成功接收消息之后需向队列应答成功(自动应答机制)
- 如果希望发送的每个消息都会被成功处理的话,那么需要 P2P 模式。
Pub/Sub 模式
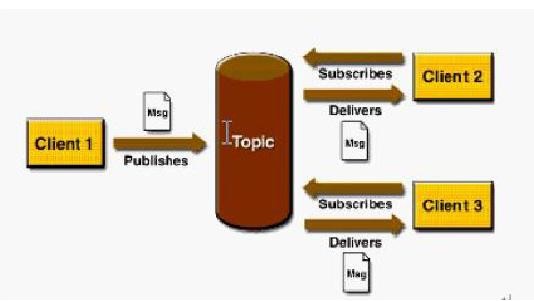
发布订阅模型:publish-subscribe,生产者将消息发送到一个保存消息的容器中,也是使用队列模型来保存。但是消息可以被多个消费者消费,生产者和消费者完全独立,相互不需要感知对方的存在。
Pub/Sub 模式图
涉及概念
- 主题(Topic)
- 发布者(Publisher)
- 订阅者(Subscriber)
多个发布者将消息发送到Topic,系统将这些消息传递给多个订阅者。
Pub/Sub 的特点
- 每个消息可以有多个消费者
- 发布者和订阅者之间有时间上的依赖性。针对某个主题(Topic)的订阅者,它必须创建一个订阅者之后,才能消费发布者的消息
- 为了消费消息,订阅者必须保持运行的状态
- 为了缓和这样严格的时间相关性,JMS允许订阅者创建一个可持久化的订阅。这样,即使订阅者没有被激活(运行),它也能接收到发布者的消息。
- 如果希望发送的消息可以不被做任何处理、以及只被一个消息者处或者被多个消费者处理的话,那么可以采用Pub/Sub模型。(群发)
消息消费
在 JMS 中,消息的产生和消费都是异步的。对于消费来说,JMS 的消息者可以通过两种方式来消费消息。
- 同步
- 订阅者或接收者通过
receive方法来接收消息,receive方法在接收到消息之前(或超时之前)将一直阻塞; - 消费者等待消费:如果队列/主题中没有消息,那就一直等待。知道有消息消费就结束。
- 订阅者或接收者通过
- 异步
- 订阅者或接收者可以注册为一个消息监听器。当消息到达之后,系统自动调用监听器的
onMessage方法。 - 消费者监听消息。
- 订阅者或接收者可以注册为一个消息监听器。当消息到达之后,系统自动调用监听器的
JNDI:java命名和目录接口是一种标准的Java命名系统接口。可以在网络上查找和访问服务。通过指定一个资源名称,该名称对应于数据库或命名服务中的一个记录,同时返回资源连接建立所必须的信息。
JNDI 在 JMS 中起到查找和访回发送目标或消息来源的作用。
AMQP
JMS 存在问题分析
JMS 为消息中间件提供了很强大的规范性支撑,但是使用的过程中就开始发现一些不足,比如 JMS 设置的极其复杂的多种类消息处理机制,由于 JMS 的设计是 J2EE 规范,是站在 Java 开发的角度思考问题。但是现实项目往往复杂度很高的。比如有一个 .NET 开发的系统 A,有一个 Java 开发的系统 B,现在要从 A 系统给 B 系统发业务消息,结果两边数据格式不统一而导致没法操作。JMS 虽然提供了 6 种数据种类,但一个都不能用。因为 A 系统的底层语言不是 Java 语言开发的,根本不支持那些对象。这就意味着如果想使用现有的业务系统 A 继续开发已经不可能了,必须推翻重新做使用 Java 语言开发的 A 系统。
因此为了支持消息数据类型跨平台的问题,于是 AMQP 孕育而生。
AMQP 概念
AMQP(advanced message queuing protocol):一种高级消息队列协议,也是消息代理规范。它旨在从协议层定义消息通信数据的标准格式,规范了网络交换的数据格式,兼容 JMS 操作。最早在 2003 年被提出,它的出现解决的是消息传递时使用的消息种类的问题,化繁为简,但是其并没有完全推翻 JMS 的操作 API,所以说 AMQP 仅仅是一种协议,规范了数据传输的格式而已。
AMQP 的优点:具有跨平台性,服务器供应商,生产者,消费者可以使用不同的语言来实现。
AMQP 消息种类
AMQP 消息种类只有一种:byte[]
AMQP 消息模型
AMQP 在 JMS 的消息模型基础上又进行了进一步的扩展,除了点对点和发布订阅的模型,开发了几种全新的消息模型,适应各种各样的消息发送。
- direct exchange
- fanout exchange
- topic exchange
- headers exchange
- system exchange
目前实现了 AMQP 协议的消息中间件技术也很多,而且都是较为流行的技术,例如:RabbitMQ、StormMQ、RocketMQ 等
AMQP 与 JMS 的区别
- JSM 是 Java 语言专属的消息服务标准,它是在 API 层定义标准,并且只能用于 Java 应用。
- AMQP 是在协议层定义的标准,是跨语言的。
MQTT
MQTT(Message Queueing Telemetry Transport)消息队列遥测传输,专为小设备设计,是物联网(IOT)生态系统中主要成分之一。
由于 JavaEE 企业级开发很少涉及,此处暂不研究
STOMP
STOMP,Streaming Text Orientated Message Protocol(面向流文本的消息协议),是一种 MOM 设计的简单文本协议。STOMP提供一个可互操作的连接格式,允许客户端与任意STOMP消息代理(Broker)进行交互。ActiveMQ是该协议的典型实现,RabbitMQ通过插件可以支持该协议。
MQ(消息队列)
什么是 MQ
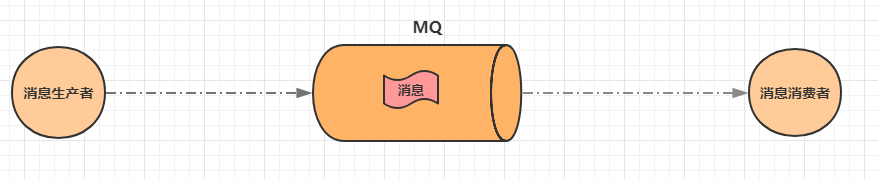
MQ(Message Queue)是一种跨进程的通信机制,用于传递消息。简单说,就是一个先进先出的数据结构。
MQ(消息队列)应用场景
消息队列在实际应用中常用的使用场景:
- 异步处理
- 应用解耦
- 流量削锋
- 消息通讯
异步解耦
- 异步:将不需要同步处理的并且耗时长的操作写入消息队列中,由消息队列通知消息接收方以异步的方式处理,提高了应用程序的响应时间。
- 解耦:MQ 相当于一个中介,生产方通过 MQ 与消费方交互,它将两个应用程序进行解耦合。
最常见的一个场景是用户注册后,需要发送注册邮件和短信通知,以告知用户注册成功。实际当数据写入注册系统后,注册系统就可以把其他的操作放入对应的消息队列 MQ 中然后马上返回用户结果,由消息队列 MQ 异步地进行这些操作。架构图如下:
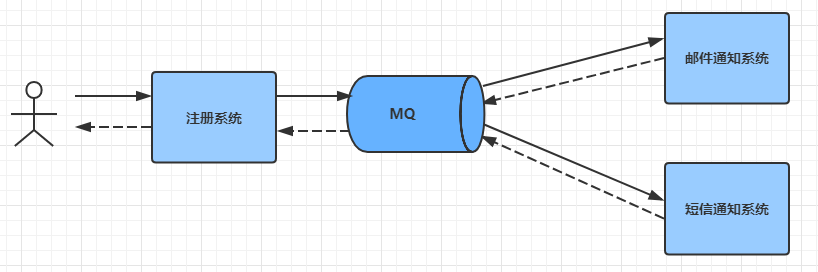
异步解耦是消息队列 MQ 的主要特点,其目的是减少请求响应时间和解耦。主要的使用场景就是将比较耗时而且不需要即时(同步)返回结果的操作作为消息放入消息队列。同时,由于使用了消息队列 MQ,只要保证消息格式不变,消息的发送方和接收方并不需要彼此联系,也不需要受对方的影响,即解耦合。
又比如,用户下单后,订单系统需要通知库存系统,假如库存系统无法访问,则订单减库存将失败,从而导致订单操作失败。订单系统与库存系统耦合,这个时候如果使用消息队列,可以返回给用户成功,先把消息持久化,等库存系统恢复后,就可以正常消费减去库存了。
流量削峰
流量削峰也是消息队列 MQ 的常用场景,一般在秒杀或团队抢购(高并发)活动中使用广泛。
假设在实际生产中有两个服务,分别是『秒杀处理系统』与『通知系统』,在秒杀或团队抢购活动中,由于用户请求量较大,导致流量暴增,可能会出现某个时间点流量高峰期。秒杀的应用在处理如此大量的访问流量后,下游的通知系统无法承载海量的调用量,甚至会导致系统崩溃等问题而发生漏通知的情况。如果服务器不采取任何措施,可能就是会因为请求过多导致应用服务器挂掉。
为解决这些问题,可在应用和下游通知系统之间加入消息队列 MQ。服务器接收到用户的请求后,首先写入消息队列,如果消息队列长度超过最大数量,则直接抛弃用户请求或跳转到错误页面。然后消费端慢慢的按照数据库能处理的并发量,从消息队列中慢慢拉取消息并处理。
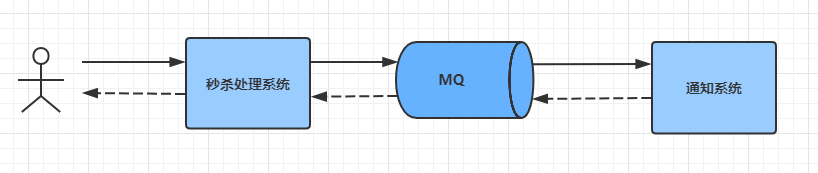
模型图说明:
- 可以控制活动的人数
- 可以缓解短时间内高流量压垮应用
- 用户的请求,服务器接收后,首先写入消息队列。假如消息队列长度超过最大数量,则直接抛弃用户请求或跳转到错误页面
- 秒杀业务根据消息队列中的请求信息,再做后续处理
秒杀处理流程如下所述:
- 用户发起海量秒杀请求到秒杀业务处理系统。
- 秒杀处理系统按照秒杀处理逻辑将满足秒杀条件的请求发送至消息队列 MQ。
- 下游的通知系统订阅消息队列 MQ 的秒杀相关消息,再将秒杀成功的消息发送到相应用户。
- 用户收到秒杀成功的通知。
日志处理
目志处理是指将消息队列用在目志处理中,比如 Kafka 的应用,解决大量日志传输的问题。架构简化如下:
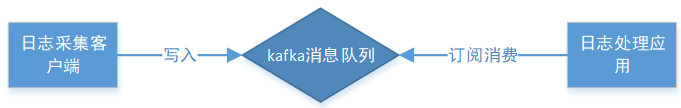
- 日志采集客户端,负责目志数据采集,定时写受写入 Kafka 队列
- Kafka 消息队列,负责目志数据的接收,存储和转发
- 日志处理应用:订阅并消费 kafka 队列中的目志数据
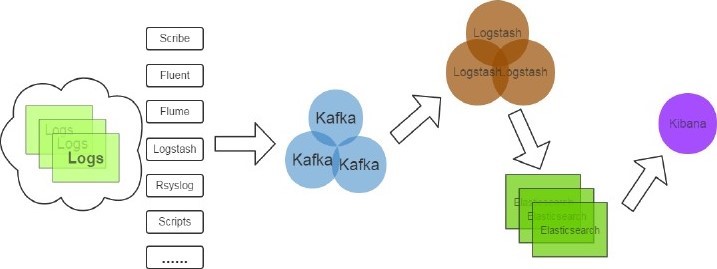
- Kafka:接收用户目志的消息队列
- Logstash:做目志解析,统一成JSON输出给Elasticsearch
- Elasticsearch:实时日志分析服务的核心技术,一个schemaless,实时的数据存储服务,通过index组织数据,兼具强大的搜索和统计功能
- Kibana:基于Elasticsearch的数据可视化组件,超强的数据可视化能力是众多公司选择ELK stack的重要原因
ELK 平台:
- E:Elasticsearch 搜索服务
- L:Logstash 日志解析
- Kibana:可视化视图组件
ELK 平台部署参考:《开源实时日志分析ELK平台部署.docx》
消息通讯
消息通讯是指,消息队列一般都内置了高效的通信机制,因此也可以用在纯的消息通讯。比如实现点对点消息队列,或者聊天室等。
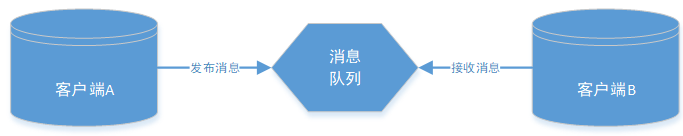
点对点通讯:客户端 A 和客户端 B 使用同一队列,进行消息通讯
聊天室通讯:客户端A,客户端B,客户端N订阅同一主题,进行消息发布和接收。实现类似聊天室效果。
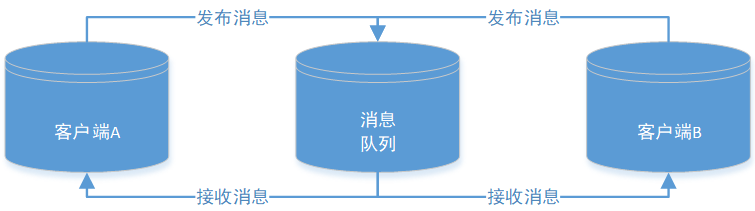
以上实际是消息队列的两种消息模式,点对点或发布订阅模式
消息队列的缺点
当系统引入消息队列后,会存在以下缺点:
- 系统可用性降低。引入消息队列之后,如果消息队列挂了,可能会影响到业务系统的可用性。
- 系统复杂性增加。加入了消息队列,增加要考虑很多方面的问题,比如:一致性问题、如何保证消息不被重复消费、如何保证消息可靠性传输等。
JMS 编程模型 API
ConnectionFactory
创建 connection 对象的工厂,针对两种不同的jms消息模型,分别有QueueConnectionFactory和TopicConnectionFactory两种。可以通过JNDI来查找ConnectionFactory对象。
Destination
Destination 的意思是消息生产者的消息发送目标或者说消息消费者的消息来源。对于消息生产者来说,它的 Destination 是某个队列(Queue)或某个主题(Topic),对于消息消费者来说,它的Destination 也是某个队列或主题(即消息来源)。
所以,Destination 实际上就是两种类型的对象Queue、Topic可以通过JNDI来查找 Destination。
Connection
Connection 表示在客户端和JMS系统之间建立的链接(对TCP/IP socket的包装)。
Connection 可以产生一个或多个Session,跟 ConnectionFactory 一样,Connection 也有两种类型:Queueconnection 和 TopicConnection
JMS的Connection参数说明
java
createSession(paramA, paramB);- paramA是设置事务的,paramA 取值有 : true or false 表示是否支持事务
- paramA设置为false时:paramB的值可为Session.AUTO_ACKNOWLEDGE,Session.CLIENT_ACKNOWLEDGE,DUPS_OK_ACKNOWLEDGE其中一个。
- paramA设置为true时:paramB的值忽略, acknowledgment mode被jms服务器设置为SESSION_TRANSACTED 。
- paramB设置acknowledgment mode paramB 取值有:Session.AUTO_ACKNOWLEDGE,Session.CLIENT_ACKNOWLEDGE,DUPS_OK_ACKNOWLEDGE,SESSION_TRANSACTED
- Session.AUTO_ACKNOWLEDGE为自动确认,客户端发送和接收消息不需要做额外的工作。
- Session.CLIENT_ACKNOWLEDGE为客户端确认。客户端接收到消息后,必须调用javax.jms.Message的acknowledge方法。jms服务器才会删除消息。
- DUPS_OK_ACKNOWLEDGE允许副本的确认模式。一旦接收方应用程序的方法调用从处理消息处返回,会话对象就会确认消息的接收;而且允许重复确认。在需要考虑资源使用时,这种模式非常有效。
session
session是操作消息的接口。可以通过session创建生产者、消费者、消息等。session提供了事务的功能。当需要使用session发送/接收多个消息时,可以将这些发送/接收动作放到一个事务中。同样,也分 QueueSession 和 TopicSession``
消息的生产者
消息生产者由session创建,并用于将消息发送到 Destination。同样,消息生产者分两种类型:QueueSender 和 TopicPublisher 可以调用消息生产者的方法(send或publish方法)发送消息。
消息消费者
消息消费者由session创建,用于接收被发送到Destination的消息。两种类型:QueueReceiver和TopicSubscriber可分别通过session的createReceiver(Queue)或createSubscriber(Topic)来创建。当然也可以session的creatDurableSubscriber方法来创建持久化的订阅者。
MessageListener
消息监听器。如果注册了消息监听器,一旦消息到达,将自动调用监听器的 onMessage 方法。EJB中的MDB(Message-Driven Bean)就是一种 MessageListener。
死信队列
死信队列的概念
死信队列(Dead Letter Queue,简称 DLQ)是消息队列中的一个特殊队列,通常用来存放那些无法被消费者所正确消费的消息。当消息在队列中滞留时间过长、重复消费次数超过限制等情况时,消息就会变成“死信”,这时就需要将其发送到死信队列中,以便后续进行处理。
死信队列的作用
- 避免消息丢失:当消息因为某些原因无法被正常消费时,通过将其发送到死信队列中,可以避免消息丢失,从而保证系统的可靠性。
- 辅助调试:当系统中存在大量的死信时,可以通过对死信进行分析,找出导致消息无法被消费的原因,从而进行针对性的调试。
- 数据统计:通过对死信进行统计,可以了解系统中存在的问题,进而优化系统的设计和架构。
Kafka 和 RabbitMQ 都支持死信队列的功能。
- 在 Kafka 中,死信队列通常使用 Kafka Streams 或者 Kafka Connect 实现;
- 在 RabbitMQ 中,死信队列则通过交换机、队列和路由键来实现。
各类消息中间件产品对比
常见的 MQ 产品
目前业界有很多 MQ 产品,比较出名的有:
- ZeroMQ:号称最快的消息队列系统,尤其针对大吞吐量的需求场景。扩展性好,开发比较灵活,采用C语言实现,实际上只是一个 socket 库的重新封装,如果做为消息队列使用,需要开发大量的代码。ZeroMQ 仅提供非持久性的队列,也就是说如果 down 机,数据将会丢失。
- RabbitMQ:使用 erlang 语言开发,性能较好,适合于企业级的开发。但是不利于做二次开发和维护。
- ActiveMQ:历史悠久的 Apache 开源项目。已经在很多产品中得到应用,实现了 JMS1.1 规范,可以和 spring-jms 轻松融合,实现了多种协议,支持持久化到数据库,对队列数较多的情况支持不好。
- RocketMQ:阿里巴巴的 MQ 中间件,由 Java 语言开发,性能非常好,能够撑住双十一的大流量,而且使用起来很简单。
- Kafka:Apache下的一个子项目,是一个高性能跨语言分布式 Publish/Subscribe 消息队列系统,相对于 ActiveMQ 是一个非常轻量级的消息系统,除了性能非常好之外,还是一个工作良好的分布式系统。
- MetaQ:全称 Metamorphosis,是一个高性能、高可用、可扩展的分布式消息中间件,思路起源于 LinkedIn 的 Kafka,但并不是 Kafka 的一个拷贝。MetaQ 具有消息存储顺序写、吞吐量大和支持本地和 XA 事务等特性,适用于大吞吐量、顺序消息、广播和日志数据传输等场景。
Kafka 和 RabbitMQ 区别
Kafka 和 RabbitMQ 都是消息中间件,用于解决分布式系统中的异步通信问题。
- 数据处理方式不同
- RabbitMQ 是一个经典的 AMQP 实现,它通过插件支持各种不同的协议,例如 XMPP、STOMP 等。RabbitMQ 使用基于 Push 的消息传递模型,这意味着消息生产者不断地将消息推送给 RabbitMQ 服务,RabbitMQ 服务再将消息推送给消息的消费者。
- Kafka 是一个高性能、低延迟的消息队列系统。Kafka 采用的是基于 Pull 的消息传递模型,消费者从 Kafka 服务器拉取数据,而不是由 Kafka 服务器将数据推送给消费者。
- 数据存储方式不同
- RabbitMQ 使用消息确认机制,确保每个消息都被消费。RabbitMQ 将消息存储在磁盘上,可以设置存储的持久性,以确保即使在服务器故障的情况下,也不会丢失消息。
- Kafka 将数据存储在内存中,可以根据需要将数据持久化到磁盘中。由于 Kafka 采用的是基于 Pull 的模型,所以消费者可以自由地重放以前的消息,而不必担心数据丢失的问题。
- 吞吐量
- Kafka 的吞吐量非常高,它可以处理每秒数百万条消息,这是由于 Kafka 将数据存储在内存中,可以进行批量处理。
- RabbitMQ 的吞吐量相对较低,但它具有良好的消息确认机制,可以确保消息的可靠性。
- 消息模型不同
- RabbitMQ 支持多种消息模型
- Kafka 主要围绕发布-订阅模型