Appearance
Seata 概述
Seata 是一款开源的分布式事务解决方案,致力于提供高性能和简单易用的分布式事务服务。Seata 将为用户提供了 AT、TCC、SAGA 和 XA 事务模式,为用户打造一站式的分布式解决方案。
发展历史
2019 年 1 月,阿里巴巴中间件团队发起了开源项目 Fescar(Fast & EaSy Commit And Rollback),其愿景是让分布式事务的使用像本地事务的使用一样,简单和高效,并逐步解决开发者们遇到的分布式事务方面的所有难题。后来更名为 Seata,意为:Simple Extensible AutonomousTransaction Architecture,是一套分布式事务解决方案。
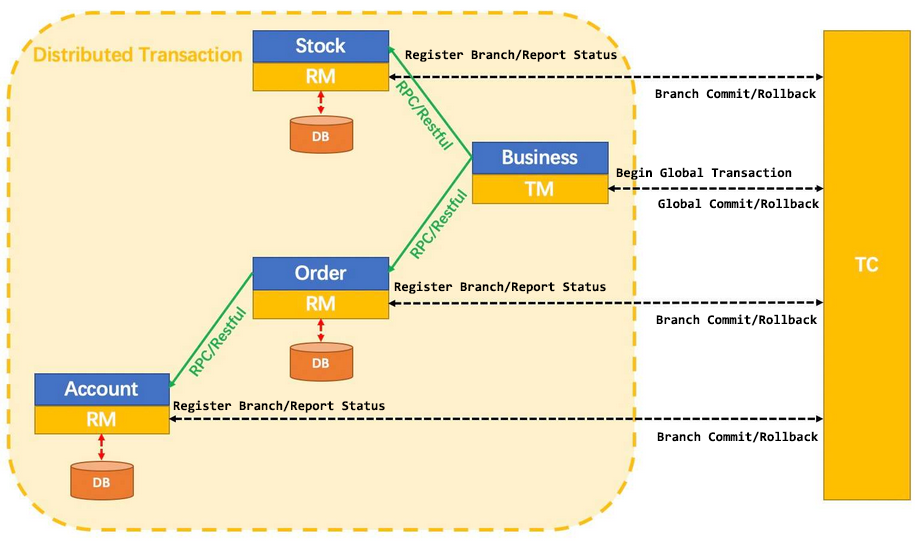
Seata 的设计目标是对业务无侵入,因此从业务无侵入的 2PC 方案着手,在传统 2PC 的基础上演进。它把一个分布式事务理解成一个包含了若干分支事务的全局事务。全局事务的职责是协调其下管辖的分支事务达成一致,要么一起成功提交,要么一起失败回滚。此外,通常分支事务本身就是一个关系数据库的本地事务。
Seata 三个重要组件
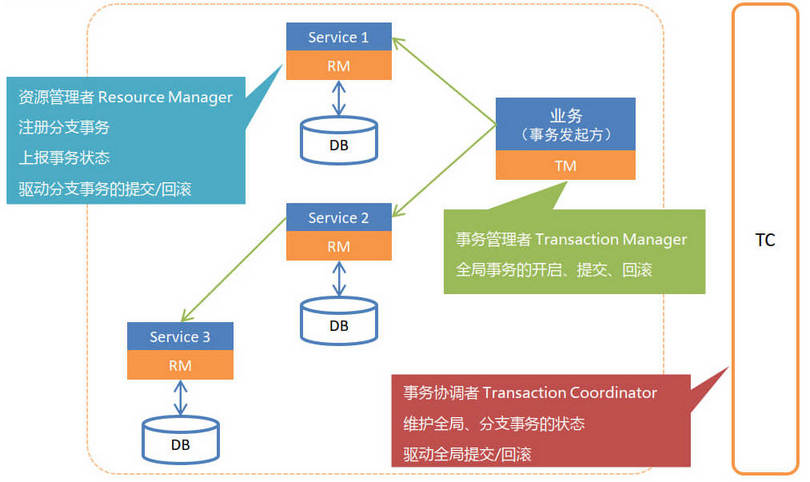
- TC (Transaction Coordinator) - 事务协调者:维护全局和分支事务的状态,驱动全局事务提交或回滚。
- TM (Transaction Manager) - 事务管理器:定义全局事务的范围:开始全局事务、提交或回滚全局事务。
- RM (Resource Manager) - 资源管理器:管理分支事务处理的资源,与 TC 交互以注册分支事务和报告分支事务的状态,并驱动分支事务提交或回滚。
Seata 的执行流程
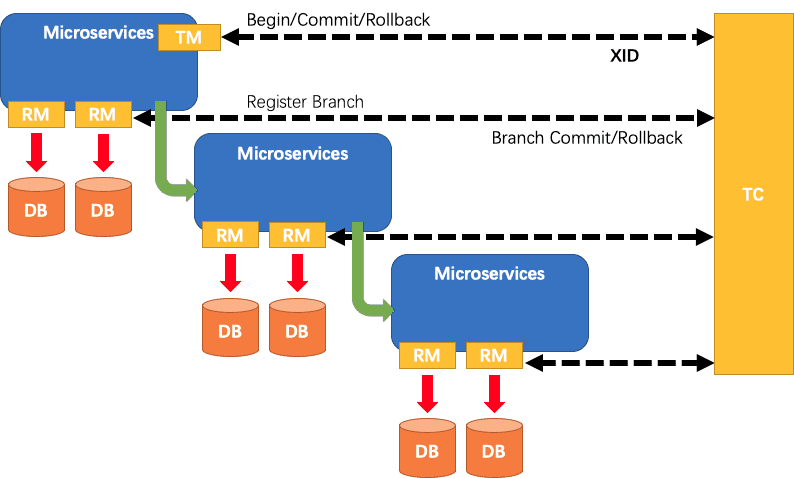
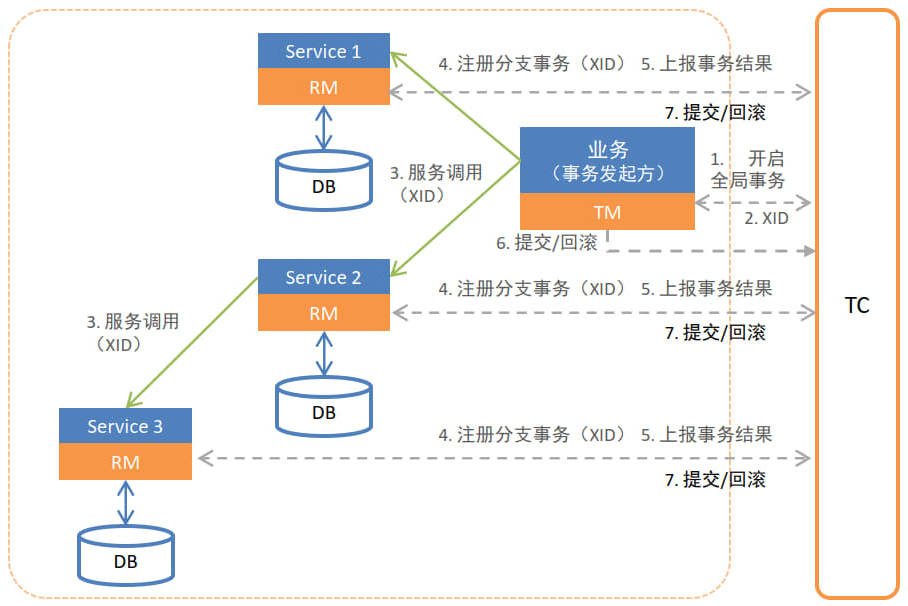
- A 服务的 TM 向 TC 申请开启一个全局事务,TC 就会创建一个全局事务并返回一个唯一的 XID
- A 服务的 RM 向 TC 注册分支事务,并及其纳入 XID 对应全局事务的管辖
- A 服务执行分支事务,向数据库做操作
- A 服务开始远程调用 B 服务,此时 XID 会在微服务的调用链上传播
- B 服务的 RM 向 TC 注册分支事务,并将其纳入 XID 对应的全局事务的管辖
- B 服务执行分支事务,向数据库做操作
- 全局事务调用链处理完毕,TM 根据有无异常向 TC 发起全局事务的提交或者回滚
- TC 协调其管辖之下的所有分支事务,决定是否回滚
Seata 实现 2PC 与传统 2PC 的差别
- 架构层次方面,传统 2PC 方案的 RM 实际上是在数据库层,RM 本质上就是数据库自身,通过 XA 协议实现,而 Seata 的 RM 是以 jar 包的形式作为中间件层部署在应用程序这一侧的。
- 两阶段提交方面,传统 2PC 无论第二阶段的决议是 commit 还是 rollback,事务性资源的锁都要保持到 Phase2 完成才释放。而 Seata 的做法是在 Phase1 就将本地事务提交,这样就可以省去 Phase2 持锁的时间,整体提高效率。
Seata AT 模式
模式实现前提
- 基于支持本地 ACID 事务的关系型数据库。
- Java 应用,通过 JDBC 访问数据库
整体机制
两阶段提交协议的演变:
- 一阶段:业务数据和回滚日志记录在同一个本地事务中提交,释放本地锁和连接资源。
- 二阶段:
- 提交异步化,非常快速地完成。
- 回滚通过一阶段的回滚日志进行反向补偿。
写隔离
一阶段本地事务提交前,需要确保先拿到全局锁。
- 拿不到全局锁,不能提交本地事务。
- 拿全局锁的尝试被限制在一定范围内,超出范围将放弃,并回滚本地事务,释放本地锁。
例如:两个全局事务 tx1 和 tx2,分别对 a 表的 m 字段进行更新操作,m 的初始值 1000。
tx1 先开始,开启本地事务,拿到本地锁,更新操作 m = 1000 - 100 = 900。本地事务提交前,先拿到该记录的全局锁,本地提交释放本地锁。tx2 后开始,开启本地事务,拿到本地锁,更新操作 m = 900 - 100 = 800。本地事务提交前,尝试拿该记录的全局锁,tx1 全局提交前,该记录的全局锁被 tx1 持有,tx2 需要重试等待全局锁。
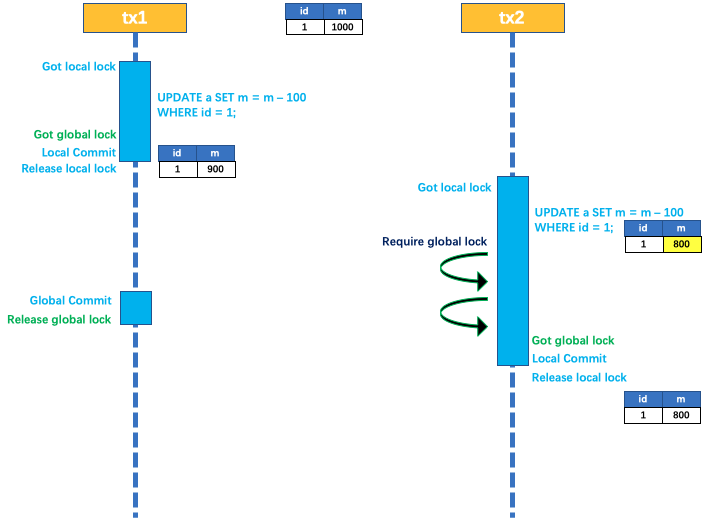
tx1 二阶段全局提交,释放全局锁。tx2 拿到全局锁提交本地事务。
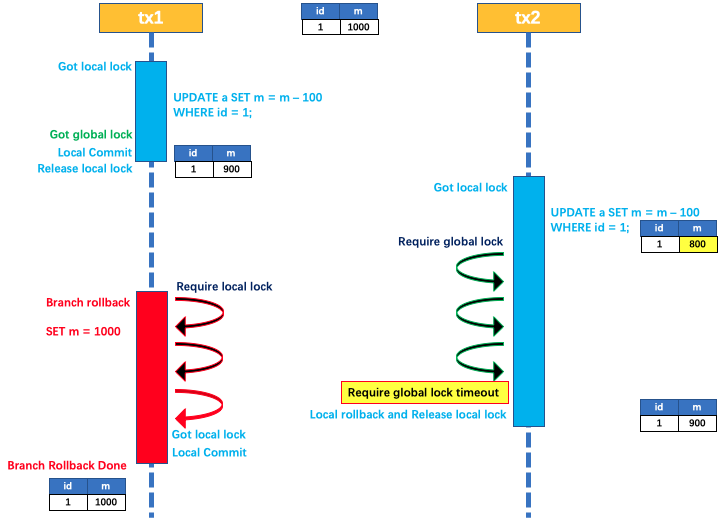
如果 tx1 的二阶段全局回滚,则 tx1 需要重新获取该数据的本地锁,进行反向补偿的更新操作,实现分支的回滚。此时,如果 tx2 仍在等待该数据的全局锁,同时持有本地锁,则 tx1 的分支回滚会失败。分支的回滚会一直重试,直到 tx2 的全局锁等锁超时,放弃全局锁并回滚本地事务释放本地锁,tx1 的分支回滚最终成功。
因为整个过程全局锁在 tx1 结束前一直是被 tx1 持有的,所以不会发生脏写的问题。
读隔离
在数据库本地事务隔离级别读已提交(Read Committed)或以上的基础上,Seata(AT 模式)的默认全局隔离级别是读未提交(Read Uncommitted)。
如果应用在特定场景下,必需要求全局的读已提交,目前 Seata 的方式是通过 SELECT FOR UPDATE 语句的代理。
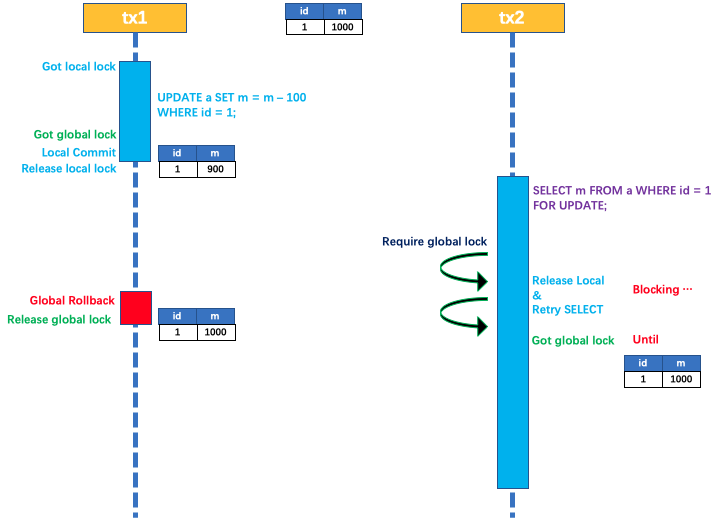
SELECT FOR UPDATE 语句的执行会申请全局锁,如果全局锁被其他事务持有,则释放本地锁(回滚 SELECT FOR UPDATE 语句的本地执行)并重试。这个过程中,查询是被 block 住的,直到全局锁拿到,即读取的相关数据是已提交的,才返回。
出于总体性能上的考虑,Seata 目前的方案并没有对所有 SELECT 语句都进行代理,仅针对 FOR UPDATE 的 SELECT 语句。
工作流程示例
下面以一个示例来说明整个 AT 分支的工作过程。假设有业务表:product
| Field | Type | Key |
|---|---|---|
| id | bigint(20) | PRI |
| name | varchar(100) | |
| since | varchar(100) |
AT 分支事务的业务逻辑:
sql
update product set name = 'GTS' where name = 'TXC';一阶段
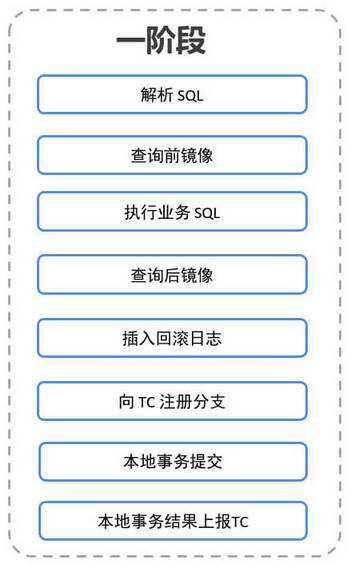
此阶段的具体过程如下:
- 解析 SQL:得到 SQL 的类型(UPDATE),表(product),条件(
where name = 'TXC')等相关的信息。 - 查询前镜像:根据解析得到的条件信息,生成查询语句,定位数据。例如:
sql
select id, name, since from product where name = 'TXC';得到前镜像:
| id | name | since |
|---|---|---|
| 1 | TXC | 2014 |
- 执行业务 SQL:更新这条记录的 name 为 'GTS'。
- 查询后镜像:根据前镜像的结果,通过主键定位数据。
sql
select id, name, since from product where id = 1;得到后镜像:
| id | name | since |
|---|---|---|
| 1 | GTS | 2014 |
- 插入回滚日志:把前后镜像数据以及业务 SQL 相关的信息组成一条回滚日志记录,插入到
UNDO_LOG表中。例如:
json
{
	"branchId": 641789253,
	"undoItems": [{
		"afterImage": {
			"rows": [{
				"fields": [{
					"name": "id",
					"type": 4,
					"value": 1
				}, {
					"name": "name",
					"type": 12,
					"value": "GTS"
				}, {
					"name": "since",
					"type": 12,
					"value": "2014"
				}]
			}],
			"tableName": "product"
		},
		"beforeImage": {
			"rows": [{
				"fields": [{
					"name": "id",
					"type": 4,
					"value": 1
				}, {
					"name": "name",
					"type": 12,
					"value": "TXC"
				}, {
					"name": "since",
					"type": 12,
					"value": "2014"
				}]
			}],
			"tableName": "product"
		},
		"sqlType": "UPDATE"
	}],
	"xid": "xid:xxx"
}- 提交前,向 TC 注册分支:申请 product 表中,主键值等于 1 的记录的全局锁。
- 本地事务提交:业务数据的更新和前面步骤中生成的 UNDO LOG 一并提交。
- 将本地事务提交的结果上报给 TC。
二阶段
二阶段分为『回滚』与『提交』两种情况,分别流程如下:
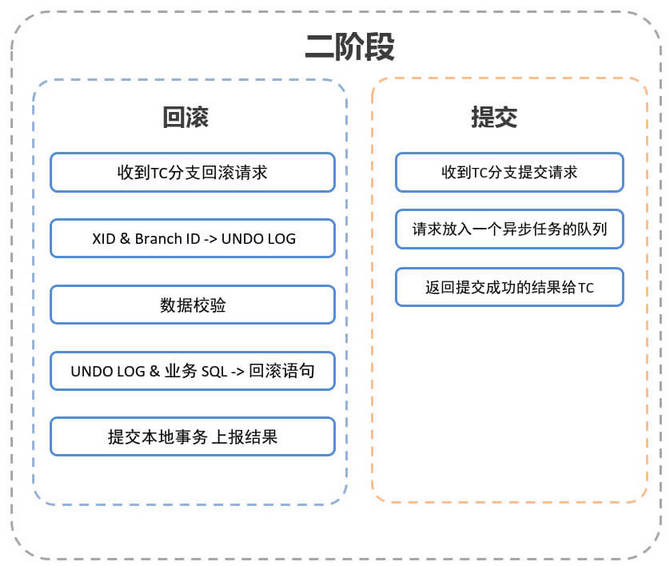
回滚
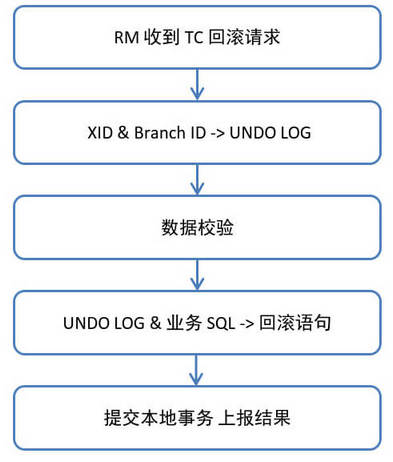
- 收到 TC 的分支回滚请求,开启一个本地事务。
- 通过 XID 和 Branch ID 查找到相应的 UNDO LOG 记录。
- 数据校验:拿 UNDO LOG 中的后镜与当前数据进行比较,如果有不同,说明数据被当前全局事务之外的动作做了修改。这种情况,需要根据配置策略来做处理。
- 根据 UNDO LOG 中的前镜像和业务 SQL 的相关信息生成并执行回滚的语句:
sql
update product set name = 'TXC' where id = 1;- 提交本地事务。并把本地事务的执行结果(即分支事务回滚的结果)上报给 TC。
提交
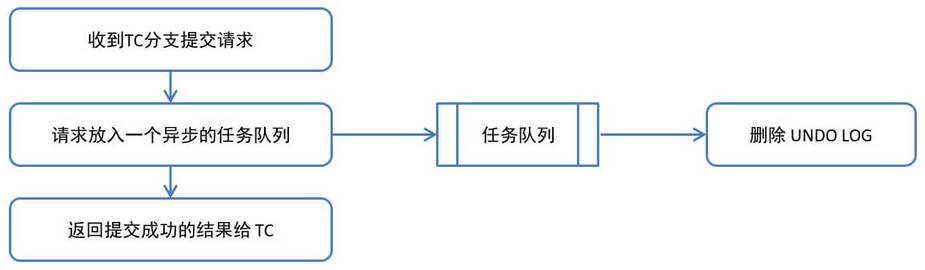
- 收到 TC 的分支提交请求,把请求放入一个异步任务的队列中,马上返回提交成功的结果给 TC。
- 异步任务阶段的分支提交请求将异步和批量地删除相应 UNDO LOG 记录。
Seata AT 模式开发示例
快速开始的示例通过 Seata 中间件实现分布式事务,模拟电商中的下单和扣库存的过程。案例通过订单微服务执行下单操作,然后由订单微服务调用商品微服务扣除库存
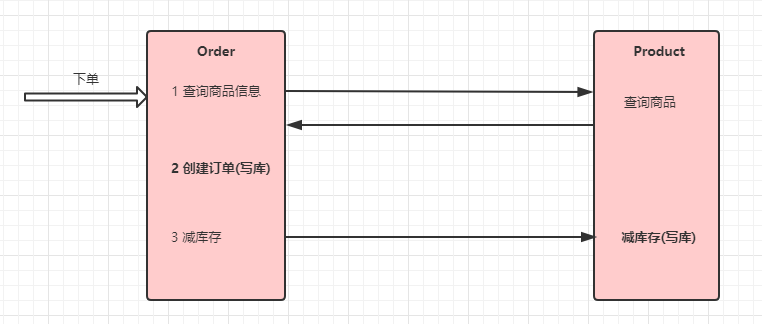
编写业务处理逻辑
此部分详见案例项目
spring-cloud-note\spring-cloud-alibaba-sample-seata\
启动 Seata 服务(0.9.0 版服务端)
下载 Seata
官方下载地址:https://github.com/seata/seata/releases
Notes: 本次示例 Seata 版本为 0.9.0。demo 中使用的相关版本号,具体请看代码。如果搭建个人demo不成功,验证是否是由版本导致,由于目前这几个项目更新比较频繁,版本稍有变化便会出现许多奇怪问题
修改 Seata 配置
将 Seata 压缩包进行解压,进入 conf 目录,修改以下的配置文件:
- registry.conf。该配置用于指定 TC 的注册中心和配置文件,默认都是
file;如果使用其他的注册中心,要求 Seata-Server 也注册到该配置中心上。此示例使用了 nacos,修改type值,将其他不需要的内容删除。
registry {
  # file 、nacos 、eureka、redis、zk、consul、etcd3、sofa
  type = "nacos"

  nacos {
    serverAddr = "127.0.0.1:8848"
    namespace = "public"
    cluster = "default"
  }
}

config {
  # file、nacos 、apollo、zk、consul、etcd3
  type = "nacos"

  nacos {
    serverAddr = "127.0.0.1:8848"
    namespace = "public"
    cluster = "default"
  }
}- nacos-config.txt 用于定义导入到 nocao 配置中心的相关内容。这里需要增加本次示例服务的服务名称。语法为:
service.vgroup_mapping.${your-service-gruop}=default,中间的${your-service-gruop}为自定义的服务组名称,这里需要在程序的配置文件中配置。
service.vgroup_mapping.product-service=default
service.vgroup_mapping.order-service=default
初始化 seata 相关配置至 nacos
确保正常运行 nacos 服务后,进行 seata 的 config 目录,运行以下命令:
bash
nacos-config.sh 127.0.0.1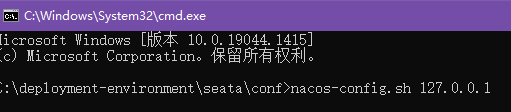
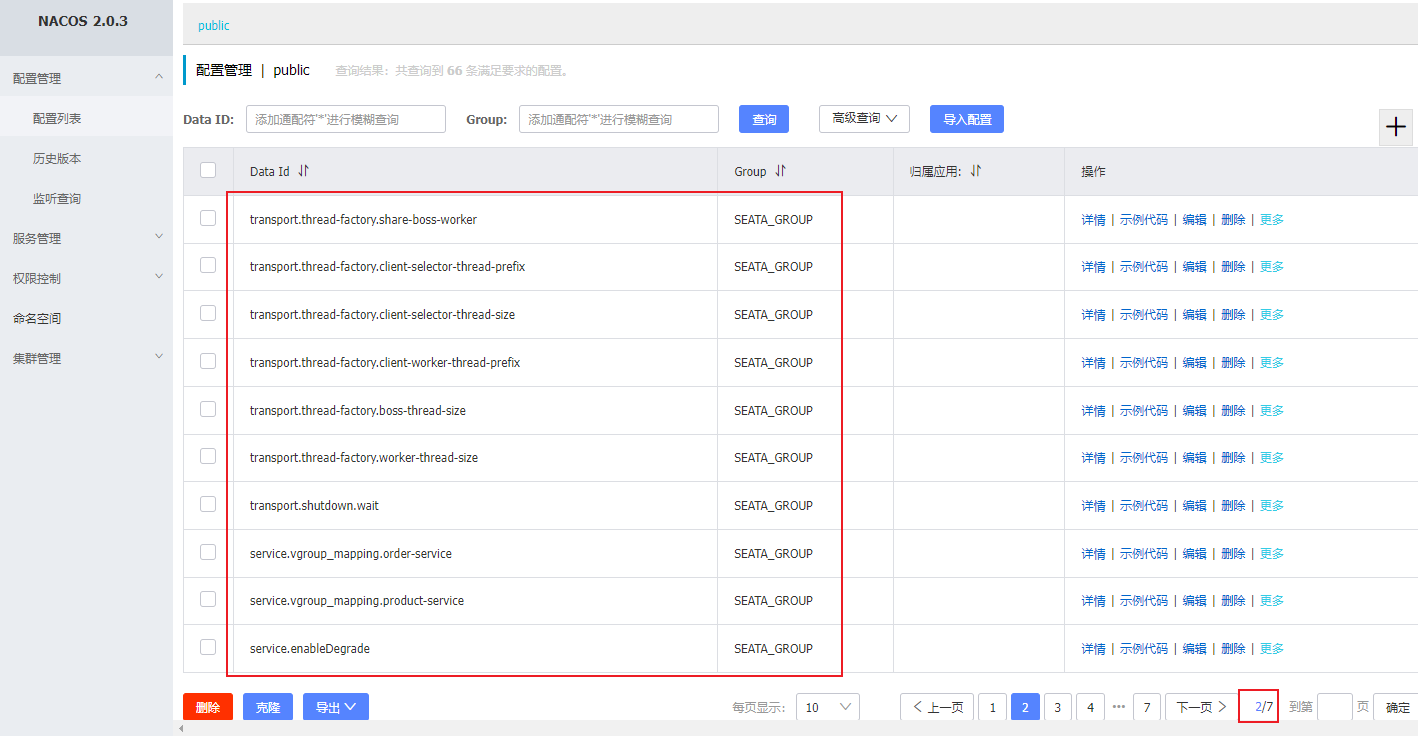
执行成功后可以打开 Nacos 的控制台,在配置列表中,可以看到初始化了很多 Group 为 SEATA_GROUP 的配置。也可以找到 nacos-config.txt 增加的服务名称映射。
启动 Seata 服务
进行 Seata 的 bin 目录。(windows 运行 .bat 脚本,linux 运行 .sh 的脚本)
bash
cd /d E:\deployment-environment\seata\bin\
seata-server.bat -p 9000 -m file
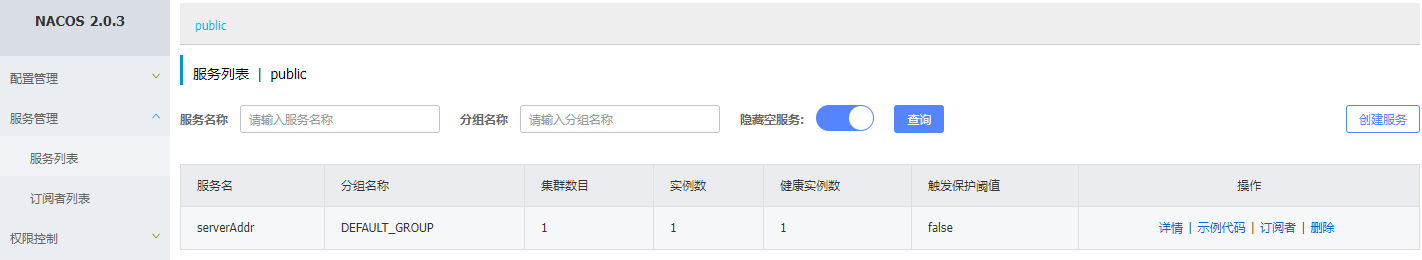
启动成功后,在 Nacos 的服务列表下面可以看到一个名为 serverAddr 的服务。
微服务使用 Seata 实现事务控制(0.7.1 版客户端)
添加依赖
在需要进行分布式控制的微服务中(示例是订单微服务、商品微服务),添加 Spring Cloud Alibaba 依赖管理工具和 Seata 依赖
特别注意有坑:这个 Spring Cloud Alibaba 的版本是 2.1.0.RELEASE!!!如果使用更高的版本,io.seata:seata-all 的版本就不是0.7.1,以下示例相关配置将不会生效!!!
xml
<dependencyManagement>
    <dependencies>
        <dependency>
            <groupId>com.alibaba.cloud</groupId>
            <artifactId>spring-cloud-alibaba-dependencies</artifactId>
            <version>2.1.0.RELEASE</version>
            <type>pom</type>
            <scope>import</scope>
        </dependency>
    </dependencies>
</dependencyManagement>

<dependency>
	<groupId>com.alibaba.cloud</groupId>
	<artifactId>spring-cloud-starter-alibaba-seata</artifactId>
</dependency>
需要注意的是 Spring Cloud Alibaba 的毕业版本的 GroupId 是 com.alibaba.cloud。spring-cloud-starter-alibaba-seata 这个依赖中只依赖了 spring-cloud-alibaba-seata,所以在项目中添加 spring-cloud-starter-alibaba-seata 和 spring-cloud-alibaba-seata 是一样的
此示例是使用nacos作为注册配置中心,需要再引入
spring-cloud-starter-alibaba-nacos-config相关的依赖
初始化 undo_log 表
在微服务业务相关的数据库中添加 undo_log 表,这是 Seata 记录事务日志要用到的表,用于保存需要回滚的数据
sql
CREATE TABLE `undo_log` (
	`id` BIGINT ( 20 ) NOT NULL AUTO_INCREMENT,
	`branch_id` BIGINT ( 20 ) NOT NULL,
	`xid` VARCHAR ( 100 ) NOT NULL,
	`context` VARCHAR ( 128 ) NOT NULL,
	`rollback_info` LONGBLOB NOT NULL,
	`log_status` INT ( 11 ) NOT NULL,
	`log_created` DATETIME NOT NULL,
	`log_modified` DATETIME NOT NULL,
	`ext` VARCHAR ( 100 ) DEFAULT NULL,
	PRIMARY KEY ( `id` ),
    UNIQUE KEY `ux_undo_log` ( `xid`, `branch_id` )
) ENGINE = INNODB AUTO_INCREMENT = 1 DEFAULT CHARSET = utf8;
注入数据源
Seata 是通过代理数据源实现事务分支的,所以需要配置 io.seata.rm.datasource.DataSourceProxy 的 Bean,且是 @Primary 默认的数据源,否则事务不会回滚,无法实现分布式事务
值得注意:MyBatis 和 JPA 都需要注入
io.seata.rm.datasource.DataSourceProxy, 不同的是,MyBatis 还需要额外注入org.apache.ibatis.session.SqlSessionFactory
- JPA 配置
java
@Configuration
public class DataSourceProxyConfig {
    @Bean
    @ConfigurationProperties(prefix = "spring.datasource")
    public DruidDataSource druidDataSource() {
        return new DruidDataSource();
    }

    @Primary
    @Bean
    public DataSourceProxy dataSource(DruidDataSource druidDataSource) {
        return new DataSourceProxy(druidDataSource);
    }
}- MyBatis 配置
java
@Configuration
public class DataSourceProxyConfig {
    @Bean
    @ConfigurationProperties(prefix = "spring.datasource")
    public DataSource dataSource() {
        return new DruidDataSource();
    }

    @Bean
    public DataSourceProxy dataSourceProxy(DataSource dataSource) {
        return new DataSourceProxy(dataSource);
    }

    @Bean
    public SqlSessionFactory sqlSessionFactoryBean(DataSourceProxy dataSourceProxy) throws Exception {
        SqlSessionFactoryBean sqlSessionFactoryBean = new SqlSessionFactoryBean();
        sqlSessionFactoryBean.setDataSource(dataSourceProxy);
        return sqlSessionFactoryBean.getObject();
    }
}
修改微服务项目配置文件
- 修改项目配置文件,创建
bootstrap.yaml/bootstrap.properties文件,增加 nacos 配置中心与 seata 的配置
yml
spring:
  cloud:
    nacos:
      config:
        server-addr: 127.0.0.1:8848 # nacos 的服务端地址
        group: SEATA_GROUP # 默认值:DEFAULT_GROUP
        namespace: public # 配置的命名空间。常用场景之一是不同环境的配置的区分隔离,例如开发测试环境和生产环境的资源隔离等。
    # 配置seata
    alibaba:
      seata:
tx-service-group: ${spring.application.name}- 在 resources 目录下添加 Seata 的配置文件 registry.conf
在微服务开启全局事务
Seata 实现全局事务,只需要在业务发起方的方法上使用 @GlobalTransactional 注解,即可开启全局事务,Seata 会将事务的 xid 通过拦截器添加到调用其他服务的请求中,实现分布式事务。
java
@Override
@GlobalTransactional
public Order createOrder(Long pid)  {
    ....
}
Seata 运行流程分析
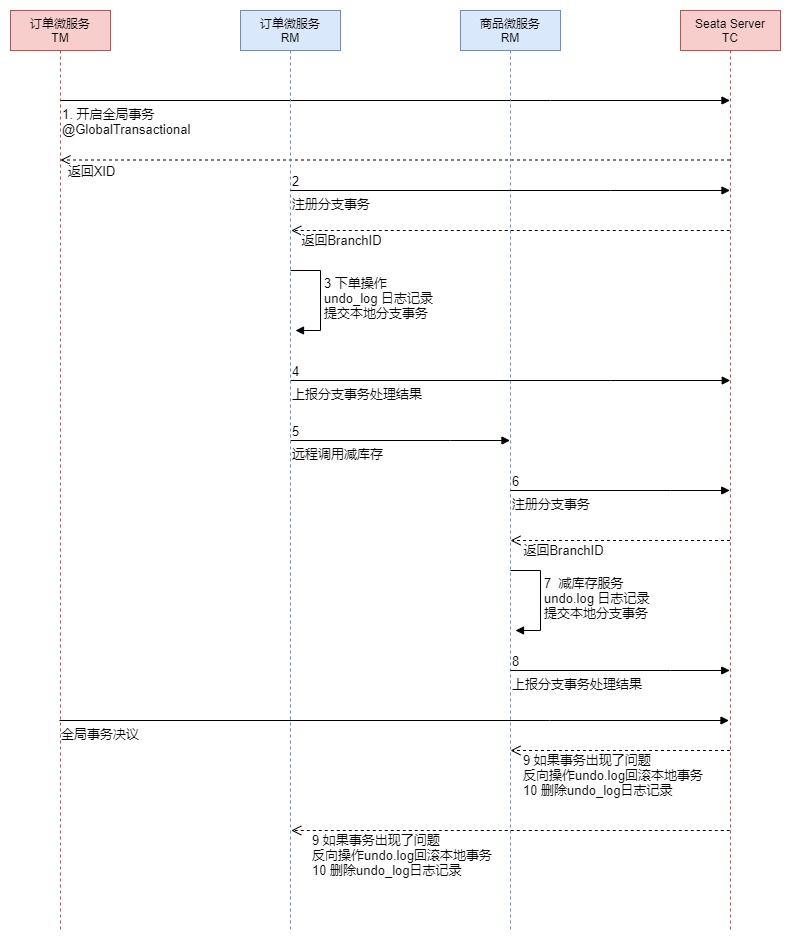
要点说明:
- 每个 RM 使用
DataSourceProxy连接数据库,其目的是使用ConnectionProxy,使用数据源和数据连接代理的目的就是在第一阶段将 undo_log 和业务数据放在一个本地事务提交,这样就保存了只要有业务操作就一定有 undo_log。 - 在第一阶段 undo_log 中存放了数据修改前和修改后的值,为事务回滚作好准备,所以第一阶段完成就已经将分支事务提交,也就释放了锁资源。
- TM 开启全局事务开始,将 XID 全局事务 id 放在事务上下文中,通过 feign 调用也将 XID 传入下游分支事务,每个分支事务将自己的 Branch ID 分支事务 ID 与 XID 关联。
- 第二阶段全局事务提交,TC 会通知各各分支参与者提交分支事务,在第一阶段就已经提交了分支事务,这里各各参与者只需要删除 undo_log 即可,并且可以异步执行,第二阶段很快可以完成。
- 第二阶段全局事务回滚,TC 会通知各各分支参与者回滚分支事务,通过 XID 和 Branch ID 找到相应的回滚日志,通过回滚日志生成反向的 SQL 并执行,以完成分支事务回滚到之前的状态,如果回滚失败则会重试回滚操作。
Seata TCC 模式
一个分布式的全局事务,整体是两阶段提交的模型。全局事务是由若干分支事务组成的,分支事务要满足两阶段提交的模型要求,即需要每个分支事务都具备自己的:
- 一阶段 prepare 行为
- 二阶段 commit 或 rollback 行为
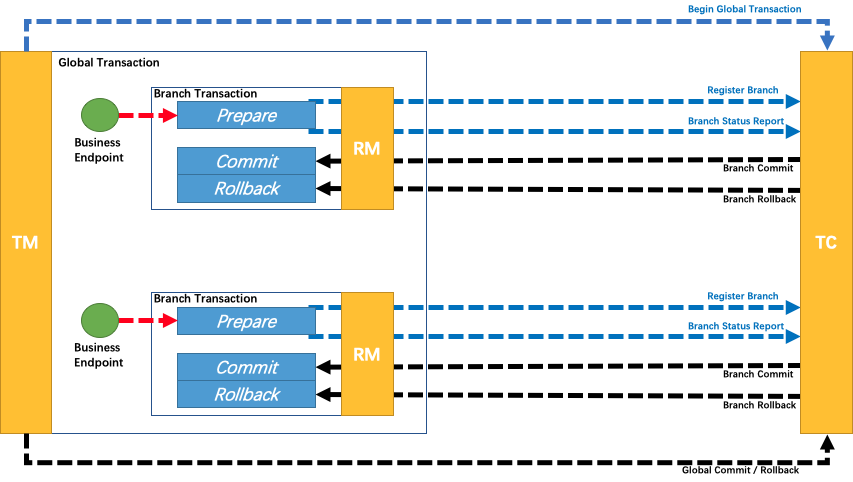
根据两阶段行为模式的不同,我们将分支事务划分为 Automatic (Branch) Transaction Mode 和 TCC (Branch) Transaction Mode.
所谓 TCC 模式,是指支持把自定义的分支事务纳入到全局事务的管理中。不依赖于底层数据资源的事务支持:
- 一阶段 prepare 行为:调用自定义的 prepare 逻辑。
- 二阶段 commit 行为:调用自定义的 commit 逻辑。
- 二阶段 rollback 行为:调用自定义的 rollback 逻辑。
对比 AT 模式是基于支持本地 ACID 事务的关系型数据库:
- 一阶段 prepare 行为:在本地事务中,一并提交业务数据更新和相应回滚日志记录。
- 二阶段 commit 行为:马上成功结束,自动异步批量清理回滚日志。
- 二阶段 rollback 行为:通过回滚日志,自动生成补偿操作,完成数据回滚。
SEATA Saga 模式
概述
整理中
Seata XA 模式
模式实现前提
- 支持 XA 事务的数据库。如 MySQL、DB2、Oracle。
- Java 应用,通过 JDBC 访问数据库。
整体机制
在 Seata 定义的分布式事务框架内,利用事务资源(数据库、消息服务等)对 XA 协议的支持,以 XA 协议的机制来管理分支事务的一种 事务模式。
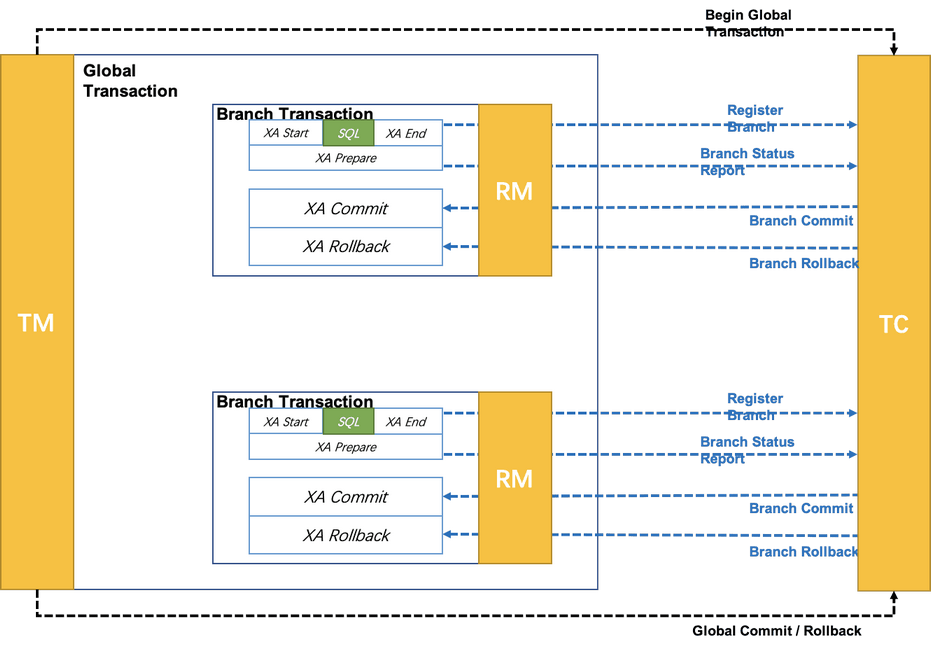
执行阶段:
- 可回滚:业务 SQL 操作放在 XA 分支中进行,由资源对 XA 协议的支持来保证可回滚。
- 持久化:XA 分支完成后,执行 XA prepare,同样,由资源对 XA 协议的支持来保证持久化(即,之后任何意外都不会造成无法回滚的情况)。
完成阶段:
- 分支提交:执行 XA 分支的 commit
- 分支回滚:执行 XA 分支的 rollback
工作机制
整体运行机制
XA 模式 运行在 Seata 定义的事务框架内:
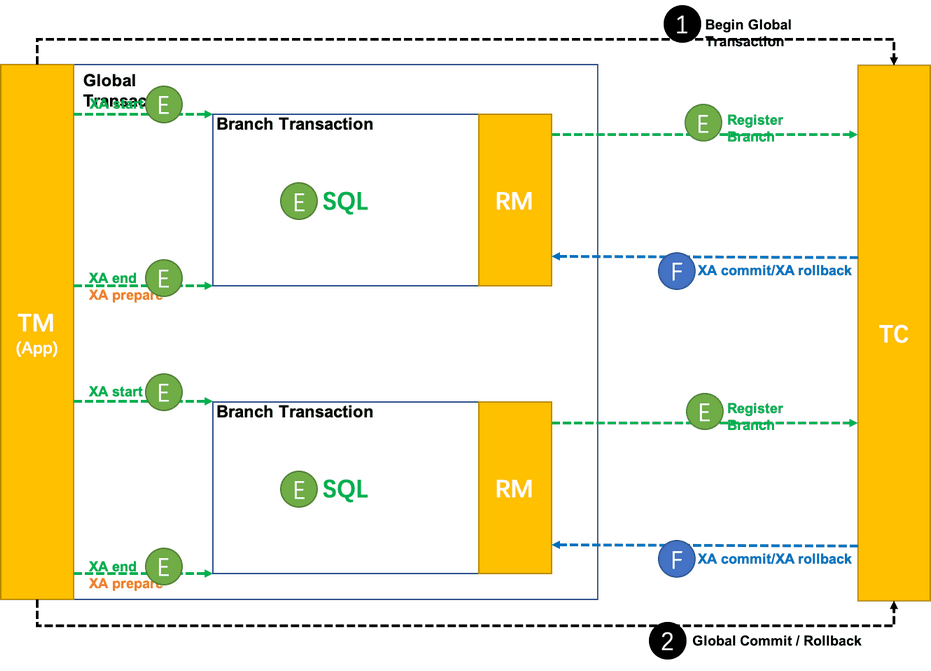
- 执行阶段(Execute):XA start/XA end/XA prepare + SQL + 注册分支。
- 完成阶段(Finish):XA commit/XA rollback
数据源代理
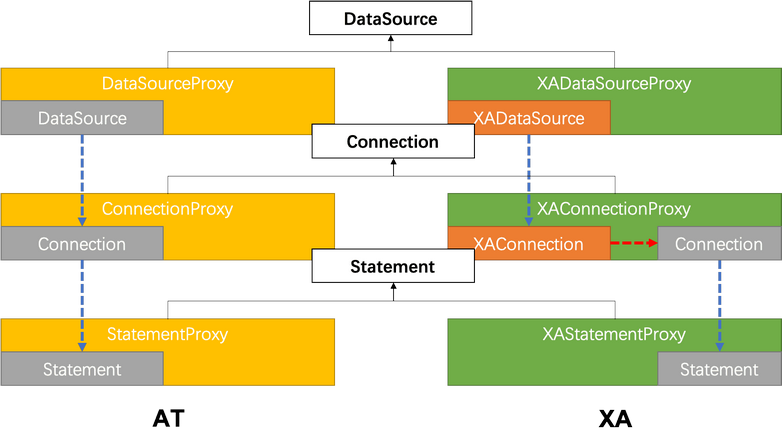
XA 模式需要 XAConnection,有以下两种方式:
- 方式一:要求开发者配置 XADataSource。给开发者增加了认知负担,需要为 XA 模式专门去学习和使用 XA 数据源,与透明化 XA 编程模型的设计目标相违背。
- 方式二:根据开发者的普通 DataSource 来创建。对开发者比较友好,和 AT 模式使用一样,开发者完全不必关心 XA 层面的任何问题,保持本地编程模型即可。
优先设计实现第二种方式:数据源代理根据普通数据源中获取的普通 JDBC 连接创建出相应的 XAConnection。类比 AT 模式的数据源代理机制,如下:
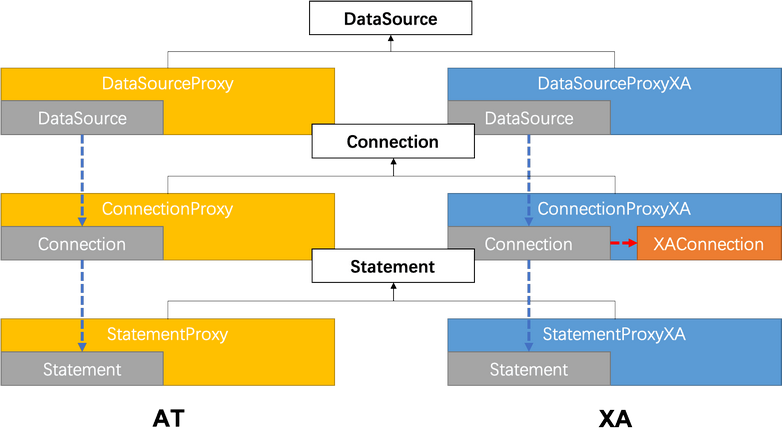
但是,第二种方法有局限:无法保证兼容的正确性。实际上,这种方法是在做数据库驱动程序要做的事情。不同的厂商、不同版本的数据库驱动实现机制是厂商私有的,只能保证在充分测试过的驱动程序上是正确的,开发者使用的驱动程序版本差异很可能造成机制的失效。这点在 Oracle 上体现非常明显。
综合考虑,XA 模式的数据源代理设计需要同时支持第一种方式:基于 XA 数据源进行代理。类比 AT 模式的数据源代理机制,如下:
分支注册
XA start 需要 Xid 参数。这个 Xid 需要和 Seata 全局事务的 XID 和 BranchId 关联起来,以便由 TC 驱动 XA 分支的提交或回滚。
目前 Seata 的 BranchId 是在分支注册过程,由 TC 统一生成的,所以 XA 模式分支注册的时机需要在 XA start 之前。
将来一个可能的优化方向:把分支注册尽量延后。类似 AT 模式在本地事务提交之前才注册分支,避免分支执行失败情况下,没有意义的分支注册。这个优化方向需要 BranchId 生成机制的变化来配合。BranchId 不通过分支注册过程生成,而是生成后再带着 BranchId 去注册分支。
XA 模式的开发示例
从编程模型上,XA 模式与 AT 模式保持完全一致。上层编程模型与 AT 模式完全相同。只需要修改数据源代理,即可实现 XA 模式与 AT 模式之间的切换。
java
@Bean("dataSource")
public DataSource dataSource(DruidDataSource druidDataSource) {
    // DataSourceProxy for AT mode
    // return new DataSourceProxy(druidDataSource);

    // DataSourceProxyXA for XA mode
    return new DataSourceProxyXA(druidDataSource);
}