Appearance
高并发架构:负载均衡
概述
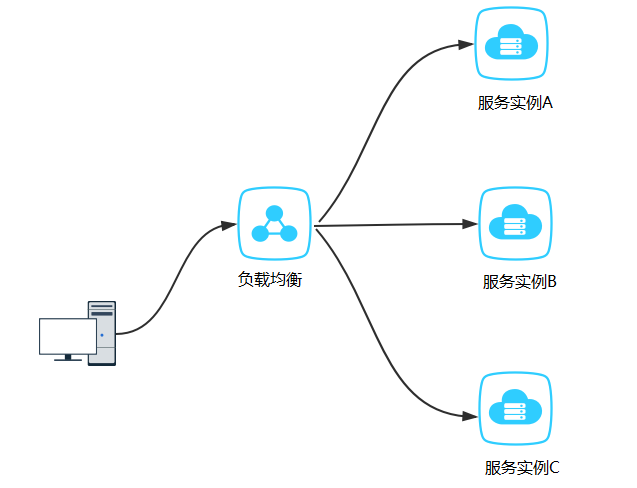
负载均衡,是高可用网络基础架构的关键组件,通常建立在现有网络结构之上,用于将工作负载分布到多个服务器,扩展网络设备和服务器的带宽,从而提高网站、应用、数据库或其他服务的性能、吞吐量,加强了网络数据处理能力,并提高了网络的灵活性和可用性的一套解决方案。简单来说,负载均衡就是将负载(工作任务,访问请求)进行分摊到多个操作单元(服务器、组件)上进行执行,旨在优化资源使用,最大吞吐量,最小响应时间并避免任何单一资源的过载。项目中常用的负载均衡有四层负载均衡和七层负载均衡。
为了保证服务的高可用,服务单元往往是集群化部署。由于服务注册中心既要接收每个服务的定时心跳,而且每个服务会定期获取服务注册列表的信息,所以一般做法将服务注册中心集群化,每个服务注册中心的数据实时同步。
服务提供者可以进行集群化部署,服务消费者集成负载均衡组件,该组件会向服务消费者获取服务注册列表信息,并每隔一段时间重新刷新获取列表。当消费服务时,负载均衡组件获取服务提供者所有注册信息,并通过负载均衡策略,选择一个服务提供者进行消费。
常见的负载均衡方案
- 基于 DNS 的负载均衡:将同一域名的请求分发到不同的服务器上,根据 DNS 服务器的负载均衡算法选择不同的 IP 地址返回给客户端。缺点是 DNS 缓存、DNS 响应不稳定等问题可能会影响负载均衡的效果。
- 基于硬件的负载均衡:使用专门的负载均衡设备,例如 F5 等负载均衡器。负载均衡器根据特定的算法将请求分发到不同的服务器上,从而实现负载均衡。缺点是价格昂贵,不适用于小型应用。
- 基于软件的负载均衡:使用软件负载均衡器,例如 HAProxy、Nginx 等。软件负载均衡器可以运行在普通的服务器上,使用软件算法将请求分发到不同的服务器上,从而实现负载均衡。相比硬件负载均衡器,软件负载均衡器价格较低,适用于中小型应用。
根据负载均衡发生位置的不同,一般又分为服务端负载均衡和客户端负载均衡。
- 基于服务端的负载均衡:使用一台特定的服务器来处理所有的请求(或者是服务提供方本身),根据请求的特性将请求分发到不同的服务器上。例如,可以根据请求的内容、大小等特性来选择服务器。缺点是单点故障问题,如果该服务器出现问题,整个系统将不可用。比如常见的 nginx 负载均衡。
- 基于客户端的负载均衡:客户端(服务调用方)根据特定算法选择一个合适的服务器来发送请求,也就是在发送请求之前已经选好了由哪个实例处理请求。例如,可以根据服务器的负载情况、延迟时间等指标来选择服务器。缺点是客户端需要进行负载均衡,增加了客户端的负担。比如 spring cloud openfeign
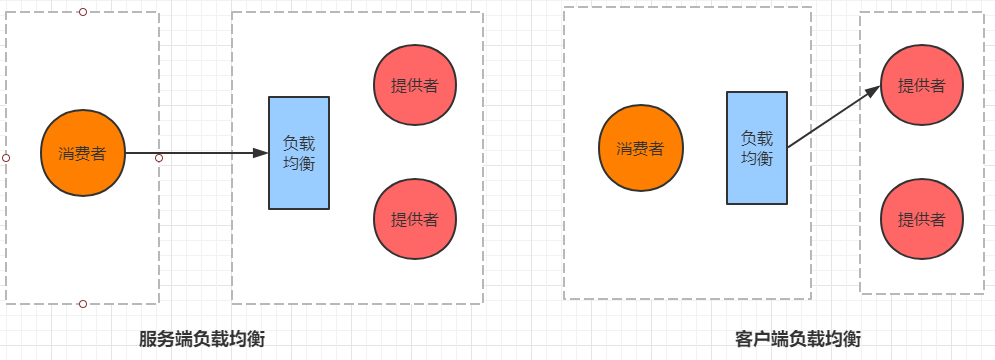
在微服务调用关系中一般会选择客户端负载均衡,也就是在服务调用的一方来决定服务由哪个提供者执行。
Nginx 反向代理的负载均衡
四层负载均衡与七层负载均衡
四层负载均衡
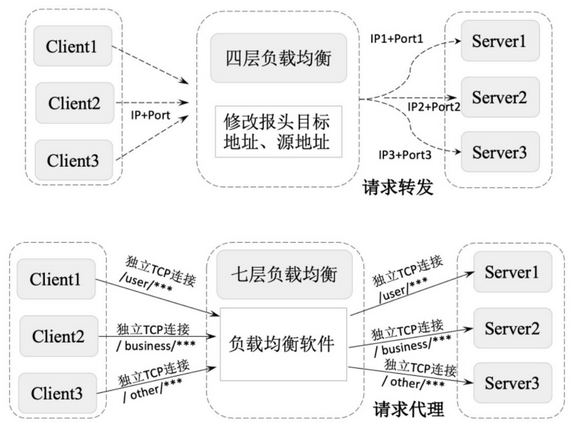
四层负载均衡主要通过修改报文中的目标地址和端口来实现报文的分发和负载均衡。以 TCP 为例,负载均衡设备在接收到第 1 个来自客户端的 SYN 请求后,会根据负载均衡配置和负载均衡策略选择一个最佳的服务器,并将报文中的目标IP地址修改为该服务器的IP直接转发给该服务器。TCP 连接的建立(即三次握手过程)是在客户端和服务器端之间完成的,负载均衡设备只起到路由器的转发功能。
四层负载均衡常用的软硬件如下:
- F5:硬件负载均衡器,功能完备,价格昂贵。
- LVS:基于
IP+端口实现的四层负载软件,常和 Keepalive 配合使用。 - Nginx:同时实现四层负载和七层负载均衡,带缓存功能,可基于正则表达式灵活转发。
七层负载均衡
七层负载均衡又叫作“内容负载均衡”,主要通过解析报文中真正有意义的应用层内容,并根据负载均衡配置和负载均衡策略选择一个最佳的服务器响应用户的请求。
七层应用负载可以使整个网络更智能化,七层负载均衡根据不同的数据类型将数据存储在不同的服务器上来提高网络整体的负载能力。比如将客户端的基本信息存储在内存较大的缓存服务器上,将文件信息存储在磁盘空间较大的文件服务器上,将图片视频存储在网络 I/O 能力较强的流媒体服务器上。在接收到不同的客户端的请求时从不同的服务器上获取数据并将其返回给客户端,提高客户端的访问效率
七层负载均衡常用的软件如下:
- HAProxy:支持七层代理、会话保持、标记、路径转移等。
- Nginx:同时实现四层负载和七层负载均衡,在 HTTP 和 Mail 协议上功能比较好,性能与 HAProxy 差不多。
- Apache:使用简单,性能较差。
对比
- 四层负载均衡基于IP和端口的方式实现网络的负载均衡,具体实现为对外提供一个虚拟IP和端口接收所有用户的请求,然后根据负载均衡配置和负载均衡策略将请求发送给真实的服务器。
- 七层负载均衡基于URL等资源来实现应用层基于内容的负载均衡,具体实现为通过虚拟的URL或主机名接收所有用户的请求,然后将请求发送给真实的服务器。
四层负载均衡和七层负载均衡的最大差别是:四层负载均衡只能针对 IP 地址和端口上的数据做统一的分发,而七层负载均衡能根据消息的内容做更加详细的有针对性的负载均衡。通常使用 LVS 等技术实现基于 Socket 的四层负载均衡,使用 Nginx 等技术实现基于内容分发的七层负载均衡,比如将以 /user/*** 开头的 URL 请求负载到单点登录服务器,而将以 /business/*** 开头的 URL 请求负载到具体的业务服务器,如下图:
负载均衡算法
常用的负载均衡算法有:轮询均衡(Round Robin)、权重轮询均衡(Weighted Round Robin)、随机均衡(Random)、权重随机均衡(Weighted Random)、响应速度均衡(Response Time)、最少连接数均衡(Least Connection)、处理能力均衡、DNS响应均衡(Flash DNS)、散列算法均衡、IP地址散列、URL散列。不同的负载均衡算法适用于不同的应用场景。
轮询均衡(Round Robin)
轮询均衡指将客户端请求轮流分配到 1 至 N 台服务器上,每台服务器均被均等地分配一定数量的客户端请求。轮询均衡算法适用于集群中所有服务器都有相同的软硬件配置和服务能力的情况下。
权重轮询均衡(Weighted Round Robin)
权重轮询均衡指根据每台服务器的不同配置及服务能力,为每台服务器都设置不同的权重值,然后按照设置的权重值轮询地将请求分配到不同的服务器上。
例如,服务器A的权重值被设计成 3,服务器 B 的权重值被设计成 3,服务器 C 的权重值被设计成 4,则服务器 A、B、C 将分别承担 30%、30%、40% 的客户端请求。权重轮询均衡算法主要用于服务器配置不均等的集群中。
随机均衡(Random)
随机均衡指将来自网络的请求随机分配给内部的多台服务器,不考虑服务器的配置和负载情况。
权重随机均衡(Weighted Random)
权重随机均衡算法类似于权重轮询算法,只是在分配请求时不再轮询发送,而是随机选择某个权重的服务器发送。
响应速度均衡(Response Time)
响应速度均衡指根据服务器设备响应速度的不同将客户端请求发送到响应速度最快的服务器上。对响应速度的获取是通过负载均衡设备定时为每台服务都发出一个探测请求(例如Ping)实现的。响应速度均衡能够为当前的每台服务器根据其不同的负载情况分配不同的客户端请求,这有效避免了某台服务器单点负载过高的情况。但需要注意的是,这里探测到的响应速度是负载均衡设备到各个服务器之间的响应速度,并不完全代表客户端到服务器的响应速度,因此存在一定偏差。
最少连接数均衡(Least Connection)
最少连接数均衡指在负载均衡器内部记录当前每台服务器正在处理的连接数量,在有新的请求时,将该请求分配给连接数最少的服务器。这种均衡算法适用于网络连接和带宽有限、CPU 处理任务简单的请求服务,例如 FTP。
处理能力均衡
处理能力均衡算法将服务请求分配给内部负荷最轻的服务器,负荷是根据服务器的CPU型号、CPU数量、内存大小及当前连接数等换算而成的。处理能力均衡算法由于考虑到了内部服务器的处理能力及当前网络的运行状况,所以相对来说更加精确,尤其适用于七层负载均衡的场景。
DNS 响应均衡(Flash DNS)
DNS响应均衡算法指在分布在不同中心机房的负载均衡设备都收到同一个客户端的域名解析请求时,所有负载均衡设备均解析此域名并将解析后的服务器IP地址返回给客户端,客户端向收到第一个域名解析后的IP地址发起请求服务,而忽略其他负载均衡设备的响应。这种均衡算法适用于全局负载均衡的场景。
散列算法均衡
散列算法均衡指通过一致性散列算法和虚拟节点技术将相同参数的请求总是发送到同一台服务器,该服务器将长期、稳定地为某些客户端提供服务。在某个服务器被移除或异常宕机后,该服务器的请求基于虚拟节点技术平摊到其他服务器,而不会影响集群整体的稳定性。
IP 地址散列
IP 地址散列指在负载均衡器内部维护了不同链接上客户端和服务器的 IP 对应关系表,将来自同一客户端的请求统一转发给相同的服务器。该算法能够以会话为单位,保证同一客户端的请求能够一直在同一台服务器上处理,主要适用于客户端和服务器需要保持长连接的场景,比如基于 TCP 长连接的应用。
URL 散列
URL 散列指通过管理客户端请求 URL 信息的散列表,将相同 URL 的请求转发给同一台服务器。该算法主要适用于在七层负载中根据用户请求类型的不同将其转发给不同类型的应用服务器。
LVS 的原理及应用
LVS(Linux Virtual Server)是一个虚拟的服务器集群系统,采用 IP 负载均衡技术将请求均衡地转移到不同的服务器上执行,且通过调度器自动屏蔽故障服务器,从而将一组服务器构成一个高性能、高可用的虚拟服务器。整个服务器集群的结构对用户是透明的,无须修改客户端和服务器端的程序,便可实现客户端到服务器的负载均衡。
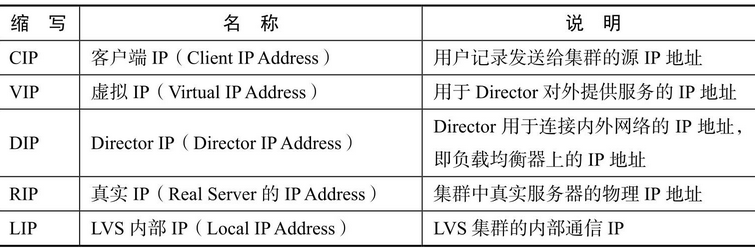
LVS 技术常用名词
LVS 的原理
LVS 由前端的负载均衡器(Load Balancer,LB)和后端的真实服务器(Real Server,RS)群组成,在真实服务器间可通过局域网或广域网连接。LVS 的这种结构对用户是透明的,用户只需要关注作为 LB 的虚拟服务器(Virtual Server),而不需要关注提供服务的真实服务器群。在用户的请求被发送给虚拟服务器后,LB 根据设定的包转发策略和负载均衡调度算法将用户的请求转发给真实服务器,真实服务器再将用户请求的结果返回给用户。
实现 LVS 的核心组件有负载均衡调度器、服务器池和共享存储。
- 负载均衡调度器(Load Balancer/Director):是整个集群对外提供服务的入口,通过对外提供一个虚拟 IP 来接收客户端请求。在客户端将请求发送到该虚拟 IP 后,负载均衡调度器会负责将请求按照负载均衡策略发送到一组具体的服务器上。
- 服务器池(Server Pool):服务器池是一组真正处理客户端请求的真实服务器,具体执行的服务有 WEB、MAIL、FTP 和 DNS 等。
- 共享存储(Shared Storage):为服务器池提供一个共享的存储区,使得服务器池拥有相同的内容,提供相同的服务。
LVS 的 IP 负载均衡技术是通过 IPVS 模块实现的。IPVS 是 LVS 集群系统的核心软件,被安装在 Director Server 上,同时在 Director Server上虚拟出一个 IP 地址。用户通过这个虚拟的 IP 地址访问服务器。这个虚拟的 IP 地址一般被称为 LVS 的 VIP,即 Virtual IP。访问的请求首先经过 VIP 到达负载调度器,然后由负载调度器从真实服务器列表中选取一个服务节点响应用户的请求。
LVS 数据转发
LVS 的数据转发流程是 LVS 设计的核心部分
- PREROUTING 链接收用户请求:客户端向 PREROUTING 链发送请求。
- INPUT 链转发:在 PREROUTING 链通过 RouteTable 列表发现请求数据包的目的地址是本机时,将数据包发送给 INPUT 链。
- IPVS 检查:IPVS 检查 INPUT 链上的数据包,如果数据包中的目的地址和端口不在规则列表中,则将该数据包发送到用户空间的 ipvsadm。ipvsadm主要用于用户定义和管理集群。
- POSTROUTING 链转发:如果数据包里面的目的地址和端口都在规则里面,那么将该数据包中的目的地址修改为事先定义好的真实服务器地址,通过 FORWARD 将数据发送到 POSTROUTING 链。
- 真实服务器转发:POSTROUTING 链根据数据包中的目的地址将数据包转发到真实服务器。
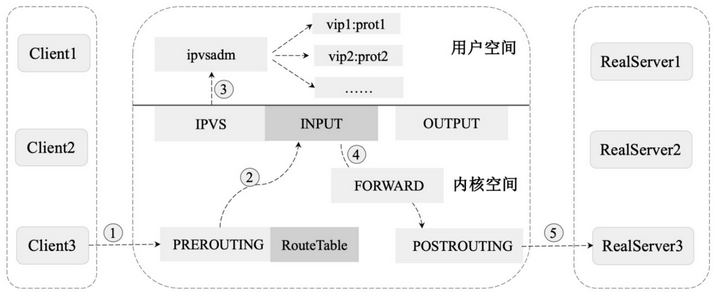
LVS NAT 模式
LVS NAT(Network Address Translation)即网络地址转换模式,具体的实现流程如下图:
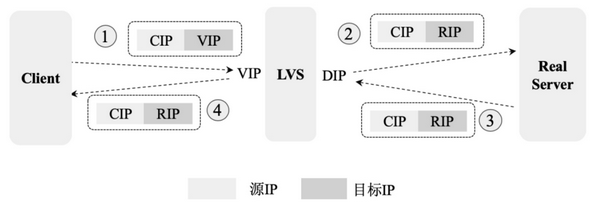
NAT 模式通过对请求报文和响应报文的地址进行改写完成对数据的转发,具体流程如下:
- 客户端将请求报文发送到 LVS,请求报文的源地址是 CIP(Client IP Address,客户端IP),目标地址是 VIP(Virtual IP Address,虚拟IP)。
- LVS 在收到报文后,发现请求的 IP 地址在 LVS 的规则列表中存在,则将客户端请求报文的目标地址 VIP 修改为 RIP(Real-server IP Address,后端服务器的真实 IP),并将报文发送到具体的真实服务器上。
- 真实服务器在收到报文后,由于报文的目标地址是自己的 IP,所以会响应该请求,并将响应报文返回给 LVS。
- LVS 在收到数据后将此报文的源地址修改为本机 IP 地址(即 VIP),并将报文发送给客户端。
NAT 模式的特点:
- 请求的报文和响应的报文都需要通过 LVS 进行地址改写,因此在并发访问量较大的时候 LVS 存在瓶颈问题,一般适用于节点不是很多的情况下。
- 只需要在 LVS 上配置一个公网 IP 即可。
- 每台内部的真实服务器的网关地址都必须是 LVS 的内网地址。
- NAT 模式支持对 IP 地址和端口进行转换,即用户请求的端口和真实服务器的端口可以不同。
LVS DR 模式
LVS DR(Direct Routing)模式用直接路由技术实现,通过改写请求报文的 MAC 地址将请求发送给真实服务器,具体的实现流程如下图:
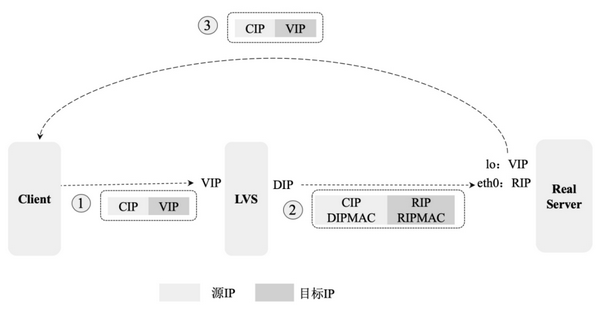
LVD DR 模式是局域网中经常被用到的一种模式,其报文转发流程如下:
- 客户端将请求发送给 LVS,请求报文的源地址是 CIP,目标地址是 VIP。
- LVS 在收到报文后,发现请求在规则中存在,则将客户端请求报文的源 MAC 地址改为自己的 DIP(Direct IP Address,内部转发 IP)的 MAC 地址,将目标 MAC 改为 RIP 的 MAC 地址,并将此包发送给真实服务器。
- 真实服务器在收到请求后发现请求报文中的目标 MAC 是自己,就会将此报文接收下来,在处理完请求报文后,将响应报文通过 lo(回环路由)接口发送给 eth0 网卡,并最终发送给客户端。
DR 模式的特点:
- 通过 LVS 修改数据包的目的 MAC 地址实现转发。注意,源 IP 地址仍然是 CIP,目标 IP 地址仍然是 VIP 地址。
- 请求的报文均经过 LVS,而真实服务器响应报文时无须经过 LVS,因此在并发访问量大时比 NAT 模式的效率高很多。
- 因为 DR 模式是通过 MAC 地址改写机制实现转发的,因此所有真实服务器节点和 LVS 只能被部署在同一个局域网内。
- 真实服务器主机需要绑定 VIP 地址在 lo 接口(掩码 32 位)上,并且需要配置 ARP 抑制。
- 真实服务器节点的默认网关无须被配置为 LVS 网关,只需要被配置为上级路由的网关,能让真实服务器直接出网即可。
- DR 模式仅做 MAC 地址的改写,不能改写目标端口,即真实服务器端口和 VIP 端口必须相同。
LVS TUN 模式
TUN(IP Tunneling)通过 IP 隧道技术实现,具体的实现流程如下图:
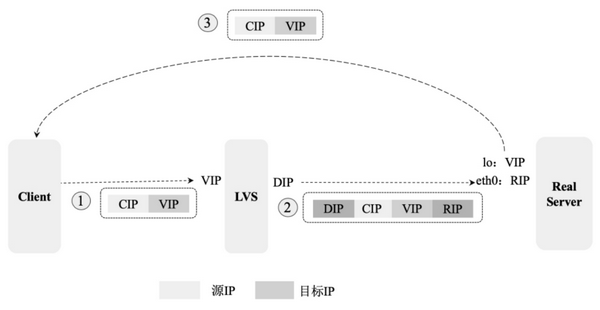
LVS TUN模式常用于跨网段或跨机房的负载均衡,具体的报文转发流程如下:
- 客户端将请求发送给前端的 LVS,请求报文的源地址是 CIP,目标地址是 VIP。
- LVS 在收到报文后,发现请求在规则里中存在,则将在客户端请求报文的首部再封装一层 IP 报文,将源地址改为 DIP,将目标地址改为 RIP,并将此包发送给真实服务器。
- 真实服务器在收到请求报文后会先拆开第 1 层封装,因为发现里面还有一层 IP 首部的目标地址是自己 lo 接口上的 VIP,所以会处理该请求报文,并将响应报文通过 lo 接口发送给 eth0 网卡,并最终发送给客户端。
TUN 模式的特点:
- TUNNEL模式需要设置 lo 接口的 VIP 不能在公网上出现。
- TUNNEL模式必须在所有的真实服务器上绑定 VIP 的 IP 地址。
- TUNNEL 模式中 VIP -> 真实服务器的包通信通过 TUNNEL 隧道技术实现,不管是内网还是外网都能通信,所以不需要 LVS 和真实服务器在同一个网段内。
- 在 TUNNEL 模式中,真实服务器会把响应报文直接发送给客户端而不经过 LVS,负载能力较强。
- TUNNEL 模式采用的是隧道模式,使用方法相对复杂,一般用于跨机房 LVS 实现,并且需要所有服务器都支持 IP Tunneling 或 IP Encapsulation 协议。
LVS FULLNAT 模式
无论是 DR 模式还是 NAT 模式,都要求 LVS 和真实服务器在同一个 VLAN 下,否则 LVS 无法作为真实服务器的网关,因此跨 VLAN 的真实服务器无法接入。同时,在流量增大、真实服务器水平扩容时,单点 LVS 会成为瓶颈。
FULLNAT 能够很好地解决 LVS 和真实服务器跨 VLAN 的问题,在跨 VLAN 问题解决后,LVS 和真实服务器不再存在 VLAN 上的从属关系,可以做到多个 LVS 对应多个真实服务器,解决水平扩容的问题。FULLNAT 的原理是在 NAT 的基础上引入 Local Address IP(内网IP地址),将 CIP -> VIP 转换为 LIP -> RIP,而 LIP 和 RIP 均为 IDC 内网 IP,可以通过交换机实现跨 VLAN 通信。FULLNAT 的具体实现流程如下图:
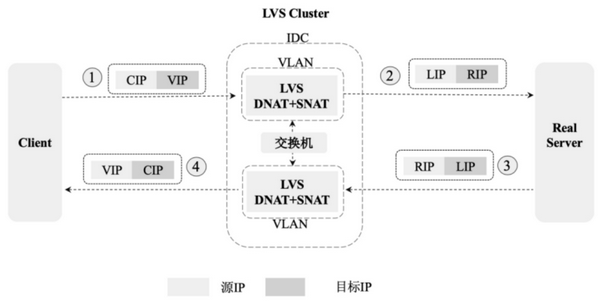
LVS FULLNAT 具体的报文转发流程:
- 客户端将请求发送给 LVS 的 DNAT,请求报文的源地址是 CIP,目标地址是 VIP。
- LVS 在收到数据后将源地址 CIP 修改成 LIP( Local IP Address,LVS 的内网 IP),将目标地址 VIP 修改为 RIP,并将数据发送到真实服务器。多个 LIP 在同一个 IDC 数据中心,可以通过交换机跨 VLAN 通信。
- 真实服务器在收到数据包并处理完成后,将目标地址修改为 LIP,将源地址修改为 RIP,最终将这个数据包返回给 LVS。
- LVS 在收到数据包后,将数据包中的目标地址修改为 CIP,将源地址修改为 VIP,并将数据发送给客户端。