Appearance
任务调度 SpringTask
什么是任务调度
在企业级应用中,经常会制定一些“计划任务”,即在某个时间点做某件事情,核心是以时间为关注点,即在一个特定的时间点,系统执行指定的一个操作。常见的任务调度框架有Quartz和SpringTask等
SpringTask 整合配置
- 在 spring 的配置文件中,开启任务注解驱动
<task:annotation-driven/>、配置任务调度方式<task:scheduler id="scheduler"/> - 创建任务调度类,使用注解
@Component让 spring 管理,在调度的方法上配置注解@Scheduled(cron = "* * * * * ?"),cron 配置时间表达式。
搭建任务服务模块
- 创建 pinyougou-task-service 模块(war 类型),修改 pom.xml 文件,配置相关的依赖,端口 9010
xml
<dependencies>
    <!-- 日志 -->
    <dependency>
        <groupId>org.slf4j</groupId>
        <artifactId>slf4j-log4j12</artifactId>
    </dependency>
    <!-- spring -->
    <dependency>
        <groupId>org.springframework</groupId>
        <artifactId>spring-web</artifactId>
    </dependency>
    <dependency>
        <groupId>org.springframework</groupId>
        <artifactId>spring-jdbc</artifactId>
    </dependency>
    <!-- pinyougou-mapper -->
    <dependency>
        <groupId>com.moon</groupId>
        <artifactId>pinyougou-mapper</artifactId>
        <version>${project.version}</version>
    </dependency>
    <!-- pinyougou-common -->
    <dependency>
        <groupId>com.moon</groupId>
        <artifactId>pinyougou-common</artifactId>
        <version>${project.version}</version>
    </dependency>
</dependencies>
<build>
    <plugins>
        <!-- 配置tomcat插件 -->
        <plugin>
            <groupId>org.apache.tomcat.maven</groupId>
            <artifactId>tomcat7-maven-plugin</artifactId>
            <configuration>
                <path>/</path>
                <port>9010</port>
            </configuration>
        </plugin>
    </plugins>
</build>- 修改 web.xml 文件,配置 spring 核心监听器
xml
<?xml version="1.0" encoding="UTF-8"?>
<web-app xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xmlns="http://java.sun.com/xml/ns/javaee"
         xsi:schemaLocation="http://java.sun.com/xml/ns/javaee
         http://java.sun.com/xml/ns/javaee/web-app_3_0.xsd" version="3.0">

    <!-- 配置Spring加载文件 -->
    <context-param>
        <param-name>contextConfigLocation</param-name>
        <param-value>classpath:applicationContext*.xml</param-value>
    </context-param>
    <!-- 配置Spring的核心监听器 -->
    <listener>
        <listener-class>org.springframework.web.context.ContextLoaderListener</listener-class>
    </listener>

</web-app>- 在 resources 目录下创建 applicationContext-task.xml 文件,开启任务注解驱动与配置任务调度
xml
<?xml version="1.0" encoding="utf-8"?>
<beans xmlns="http://www.springframework.org/schema/beans"
       xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
       xmlns:task="http://www.springframework.org/schema/task"
       xmlns:context="http://www.springframework.org/schema/context"
       xsi:schemaLocation="http://www.springframework.org/schema/beans
                  http://www.springframework.org/schema/beans/spring-beans.xsd
                  http://www.springframework.org/schema/task
                  http://www.springframework.org/schema/task/spring-task.xsd
                  http://www.springframework.org/schema/context
                  http://www.springframework.org/schema/context/spring-context.xsd">

    <!-- 导入数据访问的Spring配置文件 -->
    <import resource="classpath:applicationContext-mapper.xml"/>
    <!-- 配置导入common模块中的Redis配置文件 -->
    <import resource="classpath:applicationContext-redis.xml"/>

    <!-- 开启组件扫描 -->
    <context:component-scan base-package="com.pinyougou.task"/>

    <!-- 为了不一直在后台调用,所以在需要使用时放开以下配置  -->
    <!-- 开启任务注解驱动 -->
    <task:annotation-driven/>
    <!-- 配置任务调度 -->
    <task:scheduler id="scheduler"/>

</beans>- 创建 log4j.properties 文件
- 创建 com.pinyougou.task 包,编写 SeckillTaskService 类
java
/**
 * 秒杀任务调度服务类
 */
@Component
public class SeckillTaskService {
    /*
     * 定时关闭订单任务 (每隔2秒调用一次)
     *      使用spring框架的任务调度注解@Scheduled
     *      cron属性:任务执行表达式
     */
    @Scheduled(cron = "0/2 * * * * ?")
    public void closeOrderTask() {
        System.out.println("执行了任务调度: " + new Date());
    }
}
注:执行后会看到控制台每两秒都输出了当前时间,其中 cron 设置的为表达式,是执行的时间规则
Cron 表达式
Cron 表达式格式
Cron 表达式是一个字符串,字符串分 7 个域,每一个域代表一个含义,Cron 有如下两种语法格式:
Seconds Minutes Hours DayofMonth Month DayofWeek Year
Seconds Minutes Hours DayofMonth Month DayofWeek
【秒】   【分】   【小时】  【日】   【月】  【周】    【年】
每一个域可出现的字符如下:
Seconds:可出现", - * /"四个字符,有效范围为 0-59 的整数Minutes:可出现", - * /"四个字符,有效范围为 0-59 的整数Hours:可出现", - * /"四个字符,有效范围为 0-23 的整数DayofMonth:可出现", - * / ? L W C"八个字符,有效范围为 1-31 的整数Month:可出现", - * /"四个字符,有效范围为 1-12 的整数或 JAN-DEcDayofWeek:可出现", - * / ? L C #"八个字符,有效范围为 1-7 的整数或 SUN-SAT 两个范围。1 表示星期天,2 表示星期一, 依次类推Year:可出现", - * /"四个字符,有效范围为 1970-2099 年
每一个域都使用数字,但还可以出现如下特殊字符,它们的含义是:
*:表示匹配该域的任意值,假如在 Minutes 域使用*, 即表示每分钟都会触发事件。?:只能用在 DayofMonth(日)和 DayofWeek(周)两个域。它也匹配域的任意值-:表示范围,例如在 Minutes 域使用 5-20,表示从 5 分到 20 分钟每分钟触发一次/: 表示起始时间开始触发,然后每隔固定时间触发一次,例如在 Minutes 域使用 5/20,则意味着 5 分钟触发一次,而 25,45 等分别触发一次。,:表示列出枚举值。例如:在 Minutes 域使用 5,20,则意味着在 5 和 20 分每分钟触发一次。L: 表示最后,只能出现在 DayofWeek(周)和 DayofMonth(日),如果在 DayofWeek 域使用 5L,意味着在最后的一个星期四触发。W: 表示有效工作日(周一到周五),只能出现在 DayofMonth(日),系统将在离指定日期的最近的有效工作日触发事件。例如:在 DayofMonth 使用 5W,如果 5 日是星期六,则将在最近的工作日:星期五,即 4 日触发。如果 5 日是星期天,则在 6 日(周一)触发;如果 5 日在星期一 到星期五中的一天,则就在 5 日触发。另外一点,W 的最近寻找不会跨过月份LW: 这两个字符可以连用,表示在某个月最后一个工作日,即最后一个星期五。#: 用于确定每个月第几个星期几,只能出现在 DayofMonth 域。例如在 4#2,表示某月的第二个星期三。
Cron 表达式例子
"0 0 10,14,16 * * ?": 每天上午 10 点,下午 2 点,4 点"0 0/30 9-17 * * ?": 朝九晚五工作时间内每半小时"0 0 12 ? * WED":表示每个星期三中午 12 点"0 0 12 * * ?":每天中午 12 点触发"0 15 10 ? * *":每天上午 10:15 触发"0 15 10 * * ?":每天上午 10:15 触发"0 15 10 * * ? *":每天上午 10:15 触发"0 15 10 * * ? 2005":2005 年的每天上午 10:15 触发"0 * 14 * * ?":在每天下午 2 点到下午 2:59 期间的每 1 分钟触发"0 0/5 14 * * ?": 在每天下午 2 点到下午 2:55 期间的每 5 分钟触发"0 0/5 14,18 * * ?": 在每天下午 2 点到 2:55 期间和下午 6 点到 6:55 期间的每 5 分钟触发"0 0-5 14 * * ?": 在每天下午 2 点到下午 2:05 期间的每 1 分钟触发"0 10,44 14 ? 3 WED": 每年三月的星期三的下午 2:10 和 2:44 触发"0 15 10 ? * MON-FRI": 周一至周五的上午 10:15 触发"0 15 10 15 * ?": 每月 15 日上午 10:15 触发"0 15 10 L * ?": 每月最后一日的上午 10:15 触发"0 15 10 ? * 6L": 每月的最后一个星期五上午 10:15 触发"0 15 10 ? * 6L 2002-2005":2002 年至 2005 年的每月的最后一个星期五上午 10:15 触发"0 15 10 ? * 6#3": 每月的第三个星期五上午 10:15 触发
秒杀商品列表的增量更新
每分钟执行查询秒杀商品表,将符合条件的记录并且缓存中不存在的秒杀商品存入缓存
java
/* 注入缓存操作对象 */
@Autowired
private RedisTemplate<String, Object> redisTemplate;
/* 注入秒杀商品数据访问层接口 */
@Autowired
private SeckillGoodsMapper seckillGoodsMapper;

/*
 * 定时任务-查询新增的秒杀商品 (每隔1分钟调用一次)
 *      使用spring框架的任务调度注解@Scheduled
 *      cron属性:任务执行表达式
 */
@Scheduled(cron = "0 0/1 * * * ?")
public void refreshSeckillGoods() {

    System.err.println("执行了查询新增的秒杀商品任务调度: " + new Date());
    // 查询Redis中所有秒杀的商品,得到秒杀商品id集合
    Set seckillIds = redisTemplate.boundHashOps("seckillGoodsList").keys();

    // 创建示范对象
    Example example = new Example(SeckillGoods.class);
    // 查询条件对象
    Example.Criteria criteria = example.createCriteria();
    // 通过查询条件对象,添加查询条件。审核通过的秒杀商品
    criteria.andEqualTo("status", "1");
    // 剩余库存数据大于零
    criteria.andGreaterThan("stockCount", 0);
    // 秒杀开始时间小于等于当前时间
    criteria.andLessThanOrEqualTo("startTime", new Date());
    // 秒杀结束时间大于等于当前时间
    criteria.andGreaterThanOrEqualTo("endTime", new Date());
    // 排除Redis中已存储的秒杀商品
    criteria.andNotIn("id", seckillIds);

    // 查询新增秒杀商品集合
    List<SeckillGoods> seckillGoodsList = seckillGoodsMapper.selectByExample(example);

    // 循环新增的秒杀商品集合
    for (SeckillGoods seckillGoods : seckillGoodsList) {
        // 存入Redis缓存中
        redisTemplate.boundHashOps("seckillGoodsList")
                .put(seckillGoods.getId(), seckillGoods);
    }
    System.err.println("将" + seckillGoodsList.size() + "条商品存入缓存!");
}
过期秒杀商品的移除
每秒中从 Redis 中查询过期的秒杀商品,发现过期同步到数据库,并在缓存中移除该秒杀商品
java
/**
 * 从Redis中移除过期的秒杀商品(每20秒执行一次)
 */
@Scheduled(cron = "0/20 * * * * ?")
public void removeSeckillGoods() {

    System.err.println("移除秒杀商品任务正在执行...");
    // 查询Redis中所有秒杀的商品对象集合
    List<Object> seckillGoodsList = redisTemplate
            .boundHashOps("seckillGoodsList").values();

    // 迭代秒杀商品集合,判断是否已经过期
    for (Object obj : seckillGoodsList) {
        // 强转类型
        SeckillGoods seckillGoods = (SeckillGoods) obj;

        // 如果秒杀商品的结束时间小于当前时间,代表过期
        if (seckillGoods.getEndTime().getTime() < new Date().getTime()) {
            // 把秒杀商品同步到数据库(可能有被抢购,更新库存)
            seckillGoodsMapper.updateByPrimaryKeySelective(seckillGoods);

            // 将Redis中删除过期的秒杀商品
            redisTemplate.boundHashOps("seckillGoodsList")
                    .delete(seckillGoods.getId());
            System.err.println("移除的秒杀商品:" + seckillGoods.getId());
        }
    }
    System.err.println("移除秒杀商品任务结束...");
}
Maven Profile
什么是 MavenProfile
在平常的 java 开发中,会经常使用到很多配置文件(xxx.properties,xxx.xml),而当在本地开发(dev),测试环境测试(test),线上生产使用(product)时,需要不停的去修改这些配制文件,次数一多,相当麻烦。现在,利用 maven 的 filter 和 profile 功能,可实现在编译阶段简单的指定一个参数就能切换配制,提高效率,还不容易出错.
profile 可以定义一系列的配置信息,然后指定其激活条件。这样就可以定义多个 profile,然后每个 profile 对应不同的激活条件和配置信息,从而达到不同环境使用不同配置信息的效果。
Maven Profile 入门
- 修改 pinyougou-task-service 的 pom.xml
xml
<!-- 配置全局属性 -->
<properties>
    <port>9010</port>
</properties>

<build>
    <plugins>
        <!-- 配置tomcat插件 -->
        <plugin>
            <groupId>org.apache.tomcat.maven</groupId>
            <artifactId>tomcat7-maven-plugin</artifactId>
            <configuration>
                <path>/</path>
                <port>${port}</port>
            </configuration>
        </plugin>
    </plugins>
</build>- 运行
tomcat7:run,发现运行结果是一样的,因为 port 是变量,而变量值是定义为 9010。这其实就是我们之前学习的 maven 的变量。 - 如果这个端口在开发时使用 9010,如果在生产环境(或其他环境)为 9110 呢?如何解决值的动态切换呢?
- 修改 pom.xml,增加 profile 配置
xml
<!-- 配置全局属性 -->
<properties>
    <port>9010</port>
</properties>

<profiles>
    <!-- 开发环境 -->
    <profile>
        <!-- id用于区别不同的环境配置,随便定义 -->
        <id>dev</id>
        <properties>
            <port>9090</port>
        </properties>
    </profile>
    <!-- 生产环境 -->
    <profile>
        <id>pro</id>
        <properties>
            <port>9110</port>
        </properties>
    </profile>
</profiles>

<build>
    <plugins>
        <!-- 配置tomcat插件 -->
        <plugin>
            <groupId>org.apache.tomcat.maven</groupId>
            <artifactId>tomcat7-maven-plugin</artifactId>
            <configuration>
                <path>/</path>
                <port>${port}</port>
            </configuration>
        </plugin>
    </plugins>
</build>- 执行命令:
tomcat7:run -P dev发现以 9090 端口启动 - 执行命令:
tomcat7:run -P pro发现以 9110 端口启动 - 注:
- 参数
-P,其中P必须是大写 -P后边跟的是相应 profile 的 id- 如果只执行命令
tomcat7:run,也是以 9010 启动,因为一开始定义的变量值就是 9010,就是在不指定 profile 的 id 时的默认值。
- 参数
切换数据库连接配置
编写不同环境的配置文件
- pinyougou-mapper 工程中 src/main/resources 下创建 filter 文件夹。(注:文件夹名称无特殊规定,随意定义)
- 在 filter 文件夹下创建
db_dev.properties文件(注:文件名称无特殊规定,随意定义)
properties
env.jdbc.driver=com.mysql.jdbc.Driver
env.jdbc.url=jdbc:mysql://localhost:3306/pinyougou_db?characterEncoding=utf-8
env.jdbc.username=root
env.jdbc.password=123456
env.jdbc.maxActive=10
env.jdbc.minIdle=5- 在 filter 文件夹下创建
db_pro.properties文件
properties
env.jdbc.driver=com.mysql.jdbc.Driver
env.jdbc.url=jdbc:mysql://localhost:3306/pinyougou_pro?characterEncoding=utf-8
env.jdbc.username=root
env.jdbc.password=123456
env.jdbc.maxActive=10
env.jdbc.minIdle=5- 修改 properties 下的
db.properties文件
properties
jdbc.driver=${env.jdbc.driver}
jdbc.url=${env.jdbc.url}
jdbc.username=${env.jdbc.username}
jdbc.password=${env.jdbc.password}
jdbc.maxActive=${env.jdbc.maxActive}
jdbc.minIdle=${env.jdbc.minIdle}
定义 Profile
修改 pinyougou-mapper 工程的 pom.xml 文件,定义 profile 变量
xml
<!-- 配置全局属性,如果在package或install时不指定-P的参数,则默认为些全局配置 -->
<properties>
    <env>dev</env>
</properties>

<!-- 定义Profile -->
<profiles>
    <!-- 开发环境 -->
    <profile>
        <id>dev</id>
        <properties>
            <env>dev</env>
        </properties>
    </profile>
    <!-- 生产环境 -->
    <profile>
        <id>pro</id>
        <properties>
            <env>pro</env>
        </properties>
    </profile>
</profiles>
说明:这里定义了 2 个 profile,分别是开发环境和生产环境
资源过滤与变量替换
修改 pinyougou-mapper 工程的 pom.xml,在 build 节点中添加如下配置
xml
<build>
    <!-- 定义过滤 -->
    <filters>
        <filter>src/main/resources/filter/db_${env}.properties</filter>
    </filters>
    <!-- 配置开启资源文件过滤 -->
    <resources>
        <resource>
            <directory>src/main/resources/</directory>
            <filtering>true</filtering>
        </resource>
    </resources>
    <plugins>
        <plugin>
            <groupId>org.apache.maven.plugins</groupId>
            <artifactId>maven-resources-plugin</artifactId>
            <configuration>
                <encoding>UTF-8</encoding>
            </configuration>
        </plugin>
    </plugins>
</build>- 注:
- 这里利用 filter 实现对资源文件(resouces)过滤,
maven filter可利用指定的 xxx.properties 中对应的key=value对资源文件中的${key}进行替换,最终把资源文件中的username=${key}替换成username=value - 在开启了资源文件过滤后,配置文件的编码就发生改变,打包(或安装)后的资源文件会出现中文乱码,此时需要再配置插件,指定编码即可
- 这里利用 filter 实现对资源文件(resouces)过滤,
打包
- pinyougou-mapper 工程 执行命令:
package -P pro, 解压生成的 jar 包,观察 db.properties 配置文件内容,已经替换为生产环境的值。 - pinyougou-sellergoods-service 工程 执行命令
pageage,解压生成的 war 包里的 pinyougou-dao 的 jar 包,发现也是生成环境的值。
测试运行
- 连接生产数据库:
- 在 pinyougou-mapper 工程执行命令:
install -P pro - 在 pinyougou-sellergoods-service 执行命令:
tomcat7:run - 在 pinyougou-shop-web 执行命令:
tomcat7:run
- 在 pinyougou-mapper 工程执行命令:
- 连接开发数据库:
- 在 pinyougou-mapper 工程执行命令:
install -P dev(或install) - 在 pinyougou-sellergoods-service 执行命令:
tomcat7:run - 在 pinyougou-shop-web 执行命令:
tomcat7:run
- 在 pinyougou-mapper 工程执行命令:
项目集群
什么是集群
集群概念
集群是一种计算机系统,它通过一组松散集成的计算机软件和/或硬件连接起来高度紧密地协作完成计算工作。在某种意义上,他们可以被看作是一台计算机。集群系统中的单个计算机通常称为节点,通常通过局域网连接,但也有其它的可能连接方式。集群计算机通常用来改进单个计算机的计算速度和/或可靠性。一般情况下集群计算机比单个计算机,比如工作站或超级计算机性能价格比要高得多。
总结:集群是,多台服务器组成的一组计算机,作为一个整体存在,向用户提供一组网络资源,这些单个的服务器就是集群的节点。
集群的两个特点
- 可扩展性:集群的性能不限制于单一的服务实体,新的服务实体可以动态的添加到集群,从而增强集群的性能。
- 高可用性:集群当其中一个节点发生故障时,这台节点上面所运行的应用程序将在另一台节点被自动接管,消除单点故障对于增强数据可用性、可达性和可靠性是非常重要的。
集群的两大能力
- 负载均衡:负载均衡把任务比较均匀的分布到集群环境下的计算和网络资源,以提高数据吞吐量。
- 错误恢复:如果集群中的某一台服务器由于故障或者维护需要无法使用,资源和应用程序将转移到可用的集群节点上。这种由于某个节点的资源不能工作,另一个可用节点中的资源能够透明的接管并继续完成任务的过程,叫做错误恢复。
负载均衡和错误恢复要求各服务实体中有执行同一任务的资源存在,而且对于同一任务的各个资源来说,执行任务所需的信息视图必须是相同的。
集群和分布式的区别
集群和分布式-相同点
分布式和集群都是需要有很多节点服务器通过网络协同工作完成整体的任务目标。
集群和分布式-不同点
分布式是指将业务系统进行拆分,即分布式的每一个节点都是实现不同的功能。而集群每个节点做的是同一件事情。
分布式与集群的联系和区别
- 分布式是指将不同的业务分布到不同的地方。
- 而集群是指将几台服务器集中在一起,实在同一个业务。
- 分布式的每一个节点,都可以用来做集群。而集群不一定就是分布式了
例如:互联网上访问的人多了,就可以做一个集群,前面放一个响应服务器,后面几台服务器完成同一业务,如果有业务访问的时候,响应服务器看哪台服务器的负载不是很重,就将任务交给哪台去完成。
而分布式,从狭义上理解,也与集群差不多,但是它的组织比较松散,不像集群,有一定组织性,一台服务器挂了,其他的服务器可以顶上来。分布式的每一个节点,都完成不同的业务,一个节点挂了,这个业务就不可访问了。
Linux 系统安装 Nginx
参考【\Java 编程工具资料\Nginx-反向代理服务器\nginx(项目 2 参考资料)\】:Linux 安装 Nginx.docx
安装 gcc
Nginx 是 C 语言开发,建议在 linux 上运行,以下案例是使用 Centos6.5 作为安装环境。安装 Nginx 需要先将官网下载的源码进行编译,编译依赖 gcc 环境;所以需要安装 gcc。
shell
yum -y install gcc-c++安装 nginx
shell
# 安装依赖环境
yum -y install pcre pcre-devel
yum -y install zlib zlib-devel
yum -y install openssl openssl-devel

# 进入root目录
cd /root
# 上传nginx压缩包。使用rz命令上传“nginx-1.11.13.tar.gz”

# 解压
tar -xzvf nginx-1.11.13.tar.gz
# 删除压缩包
rm -rf nginx-1.11.13.tar.gz
# 进入nginx文件夹
cd nginx-1.11.13

# 设置安装路径
./configure --prefix=/usr/local/nginx

# 编译(在/root/nginx-1.11.13路径下执行)
make
# 安装(在/root/nginx-1.11.13路径下执行,执行后的安装目录是/usr/local/nginx,上面指定的路径)
make install
启动 nginx
shell
cd /usr/local/nginx/sbin

# sbin目录下启动
./nginx

# sbin目录下停止
./nginx -s stop

# sbin目录下重新加载
./nginx -s reload

# 关闭防火墙
systemctl stop firewalld.service

# 查看线程是否存在
ps -ef | grep nginx
测试
浏览器访问测试:http://192.168.12.132
部署运营商后台系统集群
准备运营商系统 war 包
- 到 pinyougou-manager-web 工程中,执行
package命令生成 war 包。
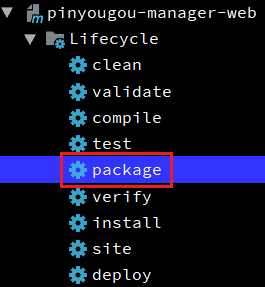
- 生成的 war 包位置在 pinyougou-manager-web 工程目录下的 target 文件夹中
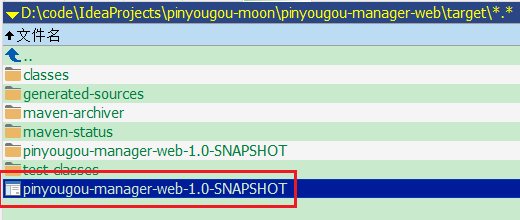
部署 2 台运营商系统
- 部署第一台 tomcat
shell
# 创建文件夹并进入
mkdir /usr/local/web && cd /usr/local/web

# 使用 rz 命令,上传apache-tomcat-8.5.28.tar.gz

# 解压 tomcat
tar -xzvf apache-tomcat-8.5.28.tar.gz

# 重命名
mv apache-tomcat-8.5.28 tomcat-pyg-manager-web1

# 进入webapps文件夹,删除所有内容
cd tomcat-pyg-manager-web1/webapps/
rm -rf *

# 创建ROOT目录
mkdir ROOT && cd ROOT

# 使用 rz 命令,上传秒杀系统pinyougou-manager-web-1.0-SNAPSHOT.war包

# 解压pinyougou-manager-web-1.0-SNAPSHOT.war,访问系统不需要带路径
jar -xvf pinyougou-manager-web-1.0-SNAPSHOT.war

# 删除pinyougou-manager-web-1.0-SNAPSHOT.war
rm -rf *.war

# 修改第2台tomcat配置的conf/server.xml中的三个端口:
# server port  8016     (22行)
# http port 8081        (69行)
# connector port 8010  (116行)
vi tomcat-pyg-manager-web1/conf/server.xml- 部署第二台 tomcat
shell
# 复制第一台门户服务器的所有内容
cd /usr/local/web
cp -r tomcat-pyg-manager-web1/ tomcat-pyg-manager-web2

# 修改第2台tomcat配置的conf/server.xml中的三个端口:
# server port  8026     (22行)
# http port 8082        (69行)
# connector port 8020  (116行)
vi tomcat-pyg-manager-web2/conf/server.xml- 启动:
shell
# 启动tomcat
cd /usr/local/web
tomcat-pyg-manager-web1/bin/startup.sh
tomcat-pyg-manager-web2/bin/startup.sh
# 注意要在windows中启动pinyougou-sellergoods与pinyougou-content服务和开启注册中心
【注意】pinyougou-sellergoods-service 与 pinyougou-content-service 服务是在 windows 上启动的,如果部署在 linux 系统的运营商项目无法访问前面那两个服务,需要将 windows 的对专用和对外的防火墙关闭。
- 修改 hosts(不配置 host 则直接使用 ip 地址访问):
192.168.12.132 manager.moon.com - 测试:
配置运营商系统 nginx 集群
- 修改 nginx 的 nginx.conf 文件。配置集群节点,注意节点的名称对应
location的proxy_pass属性的值。如果没有修改 hosts 文件的映射,则server_name的值manager.moon.com改为 ip 地址,即192.168.12.132
shell
# 进入nginx安装目录,修改nginx.conf文件
cd /usr/local/nginx/conf
vi nginx.conf
json
# 在http节点内添加:
# 配置集群节点
upstream pinyougou-manager-web {
    ip_hash;
    server 192.168.12.132:8081;
    server 192.168.12.132:8082;
}

server {
    listen       80;
    server_name  manager.moon.com;

    proxy_set_header X-Forwarded-Host $host;
    proxy_set_header X-Forwarded-Server $host;
    proxy_set_header Host $host;

    location / {
        proxy_pass http://pinyougou-manager-web;
        proxy_connect_timeout 600;
        proxy_read_timeout 600;
    }
}- 重启 nginx
shell
# 进入nginx的安装目录下的sbin文件夹
cd ../sbin
./nginx -s reload- 测试:可以在 192.168.12.132 的 linux 服务器上关闭对应的两台 tomcat 来验证系统的集群。只要还有一台服务器在运行系统就是可使用的;除非两台服务器全部关闭才不能访问系统。
Nginx 负载均衡调度算法
轮询(默认)
每个请求按时间顺序逐一分配到不同的服务器,如果当前服务器 down 掉,则会跳转到下一台服务器。此配置存在的问题是 session 不能共享。如果用户登陆时是第 1 台 tomcat,再次访问时跳到第 2 台 tomcat,当前 session 在第 2 台不存在,此时就需要用户再次登陆。如果使用这种配置需要解决 session 的问题,如其中一种方案就是将 session 存放到 redis 中
json
upstream pinyougou-manager-web {
    server 192.168.12.132:8081;
    server 192.168.12.132:8082;
}
weight(权重)
指定在轮询的基础上加上权重,weight 和访问比率成正比,即用于表明服务器的性能好坏,若服务器性能较好则可将大部分请求分配给它,已实现其力所能及。如下配置,即每两个请求分配到 8081 的 tomcat 中,一个请求分配到 8082 的 tomcat 中
json
upstream pinyougou-manager-web {
    server 192.168.12.132:8081 weight=2;
    server 192.168.12.132:8082 weight=1;
}
ip_hash(ip 哈希值)
每个请求按访问 ip 的 hash 结果分配,当新的请求到达时,先将其客户端 IP 通过哈希算法进行哈希出一个值,在随后的请求客户端 IP 的哈希值只要相同,就会被分配至同一个后端服务器,该调度算法可以解决 session 的问题。
json
upstream pinyougou-manager-web {
    ip_hash;
    server 192.168.12.132:8081;
    server 192.168.12.132:8082;
}
nginx 服务器和 tomcat 服务器的处理能力
- 1 个 nginx 服务的处理并发量大概是 5 万
- 1 台 tomcat 并发量:1 秒处理 200-300 个请求
- 对于商城的项目,大概 1 秒处理 1000~2000 个请求
- 如果并发量在 5 万以内,则考虑 tomcat 的集群;如果并发量在 5 万以上,则需要对 nginx 也做集群
Mycat 数据库分库分表中间件
- 详细资料见:\Java 编程工具资料\数据库\MySQL\资料(项目 2)\
- 【mycat-分库分表中间件】:mycat 笔记、安装包、配置文件
- 【mysql-安装包与安装说明-linux 系统】:CentOS 7.4 安装与配置 MySql 5.7.21
Mycat 介绍
更多 Mycat 使用详见《Mycat2 - 数据库中间件》笔记
Mycat 安装与使用
环境准备
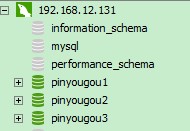
- 在 Linux 上安装一个 MySQL 数据库服务器进行模拟,再其上创建三个数据库,作为集群中的库进行使用。
- Linux 安装 MySQL 在“\Java 编程工具资料\数据库\MySQL\资料(项目 2)\mysql-安装包与安装说明-linux 系统\”文件夹中参考文档:《CentOS 7.4 安装与配置 MySql 5.7.21.docx》;或参考自己的《【13】Linux 笔记.doc》的【5、CentOS 7.4 安装与配置 MySQL 5.7.21】
安装好 mysql 后,创建 3 个数据库
安装
shell
cd /usr/local

# 使用 rz 命令上传“Mycat-server-1.6-RELEASE-20161028204710-linux.tar.gz”
#解压
tar -xzvf Mycat-server-1.6-RELEASE-20161028204710-linux.tar.gz
配置
shell
cd mycat/confconf 文件夹相关文件的作用说明
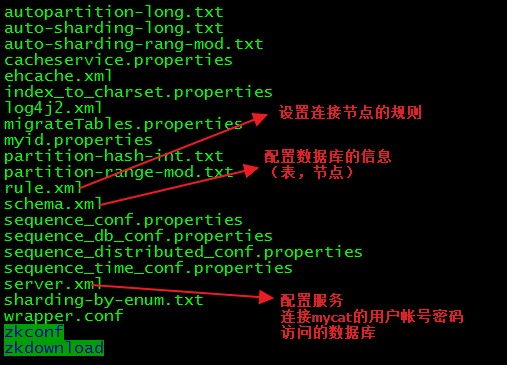
配置服务参数 server.xml
修改第 82、97 行的数据库名称为 pinyougou*(此名称对应 schema.xml 文件中的<schema>的 name 属性)*;文件中的用户为连接 mycat 的帐号和密码
shell
vi server.xmlxml
<user name="root">
	<property name="password">123456</property>
	<property name="schemas">pinyougou</property>

	<!-- 表级 DML 权限设置 -->
	<!--
	<privileges check="false">
		<schema name="TESTDB" dml="0110" >
			<table name="tb01" dml="0000"></table>
			<table name="tb02" dml="1111"></table>
		</schema>
	</privileges>
	 -->
</user>

<user name="user">
	<property name="password">user</property>
	<property name="schemas">pinyougou</property>
	<property name="readOnly">true</property>
</user>
配置逻辑库约束 schema.xml
此配置文件主要是逻辑数据库(虚拟的)与实际的集群物理数据库的关系,编辑schema.xml文件,修改内容如下(删除多余的 table 节点)
shell
vi schema.xmlxml
<?xml version="1.0" encoding="utf-8"?>
<!DOCTYPE mycat:schema SYSTEM "schema.dtd">
<mycat:schema xmlns:mycat="http://io.mycat/">

	<!-- schema: 配置逻辑数据库 -->
	<schema name="pinyougou" checkSQLschema="false" sqlMaxLimit="100">
		<!--
		  table: 配置逻辑数据库表
		  dataNode:数据分片节点
		  rule: 分片规则名称
		-->
		<table name="tb_item" dataNode="dn1,dn2,dn3" rule="auto-sharding-item-id" />
	</schema>

	<!-- 配置数据节点(配置物理数据库) -->
	<dataNode name="dn1" dataHost="localhost1" database="pinyougou1" />
	<dataNode name="dn2" dataHost="localhost1" database="pinyougou2" />
	<dataNode name="dn3" dataHost="localhost1" database="pinyougou3" />

	<!-- 配置数据主机 -->
	<dataHost name="localhost1" maxCon="1000" minCon="10" balance="0"
			  writeType="0" dbType="mysql" dbDriver="native" switchType="1"  slaveThreshold="100">
		<!-- 检查心跳 -->
		<heartbeat>select user()</heartbeat>
		<!-- 配置读写主机-->
		<writeHost host="hostS1" url="localhost:3306" user="root"
				   password="Root_123" />
	</dataHost>

</mycat:schema>
配置表分片规则 rule.xml
- 配置 rule.xml 文件
shell
vi rule.xml- 修改 rule1 的内容
- 把
name="rule1"修改为name="auto-sharding-item-id"; <algorithm>func1</algorithm>改为<algorithm>func-item-id</algorithm>
- 把
xml
<!--
    配置表的分片规则
	name 为schema.xml 中table 标签中对应的 rule="auto-sharding-item-id"
-->
<tableRule name="auto-sharding-item-id">
	<rule>
		<!-- 表的切分字段 -->
		<columns>id</columns>
		<!--  切分规则:映射到function 的name -->
		<algorithm>func-item-id</algorithm>
	</rule>
</tableRule>- 配置分片算法;继续在文件的倒数第二行添加如下内容
xml
<!--
    分片算法函数
	name 为切分规则的名称,需要与tableRule中匹配
	class 是切分规则对应的切分类(表达式切分类)
	property 标签是切分规则对应的不同属性,不同的切分规则配置不同
-->
<function name="func-item-id" class="io.mycat.route.function.PartitionByPattern">
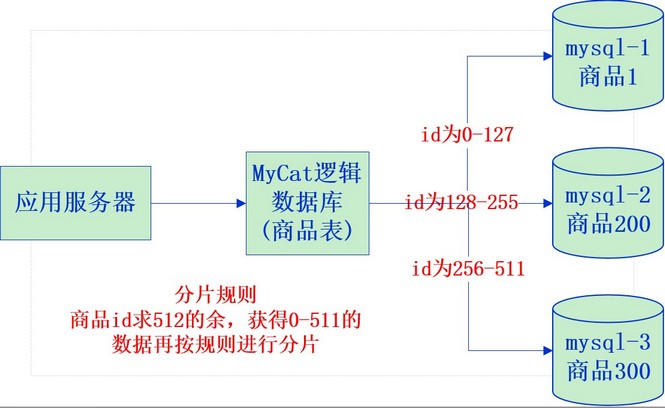
		<!-- 表达式的值: 切分字段id % 512 = 0-511  -->
		<property name="patternValue">512</property>
		<!-- mapFile:指定切分结果怎样存储到不同数据库 -->
		<property name="mapFile">partition-item-id.txt</property>
</function>
添加并编辑配置文件
- 添加并编辑配置文件,用于配置分配到不同的数据库
shell
vim partition-item-id.txt0-127=0
128-255=1
256-511=2启动
shell
cd /usr/local/mycat/bin/
./mycat start

# 查看启动日志:
cat ../logs/wrapper.log

# 如果报Jvm的堆内存大小异常Invalid maximum heap size: -Xmx4G;可以如下:
vim ../conf/wrapper.conf     # 修改36行的4G可以修改为1G

# 如果日志中出现:JVM did not exit on request, terminated
# 可以打开配置文件
vim ../conf/wrapper.conf

# 添加如下内容(启动超时):
wrapper.startup.timeout=7200

# ********* 如果出现以下错误: ********* #
FATAL  | wrapper  | 2017/02/07 05:47:00 |   There may be a configuration problem: please check the logs.
STATUS | wrapper  | 2017/02/07 05:47:00 | <-- Wrapper Stopped
STATUS | wrapper  | 2017/02/07 05:47:56 | --> Wrapper Started as Daemon
STATUS | wrapper  | 2017/02/07 05:47:57 | Launching a JVM...
ERROR  | wrapper  | 2017/02/07 05:47:57 | JVM exited while loading the application.
INFO   | jvm 1    | 2017/02/07 05:47:57 | 错误: 代理抛出异常错误: java.net.MalformedURLException: Local host name unknown: java.net.UnknownHostException: moon: moon: 未知的名称或服务
# **************************************** #

# 则可以在hosts文件中添加如下内容:
vim /etc/hosts

# 添加如下:
127.0.0.1 moon
测试
- 连接 MyCat:
- 连接 MyCat 和连接 MySQL 是一样的,区别是,MyCat 的端口号是 8066
- MyCat 的账号密码在 server.xml 中进行配置
- 测试 MyCat:
- 在 Mysql 中三个库都创建 tb_item 表
- 在 MyCat 中插入数据,发现按照规则给三个数据库分别插入了数据
- 程序测试 MyCat
java
/** 加载驱动类 */
Class.forName("com.mysql.jdbc.Driver");
/** 配置连接URL */
String url = "jdbc:mysql://192.168.12.131:8066/pinyougou";
/** 获取数据库连接 */
Connection conn = DriverManager.getConnection(url, "root", "123456");
/** 执行查询得到结果集 */
ResultSet rs = conn.prepareStatement("select * from tb_item").executeQuery();
while(rs.next()){
	System.out.println(rs.getLong(1) + "\t" + rs.getString(2) );
}
conn.close();
说明:程序操作 MyCat 实际上操作得是 mysql,CRUD 完全一样,需要改变得是应用程序连接得是 MyCat。更改连接 URL、用户名、密码即可,其它代码不需要改变。
MongoDB 简介
详细教程资料:G:\Java 编程工具资料\数据库\MongoDB
什么是 MongoDB
MongoDB 是一个跨平台的,面向文档的数据库,是当前 NoSQL 数据库产品中最热门的一种。它介于关系数据库和非关系数据库之间,是非关系数据库当中功能最丰富,最像关系数据库的产品。它支持的数据结构非常松散,是类似 JSON 的 BSON 格式,因此可以存储比较复杂的数据类型。
MongoDB 的官方网站地址是:http://www.mongodb.org/
MongoDB 特点
MongoDB 最大的特点是他支持的查询语言非常强大,其语法有点类似于面向对象的查询语言,几乎可以实现类似关系数据库单表查询的绝大部分功能,而且还支持对数据建立索引。它是一个面向集合的,模式自由的文档型数据库。
具体特点总结如下:
- 面向集合存储,易于存储对象类型的数据
- 模式自由
- 支持动态查询
- 支持完全索引,包含内部对象
- 支持复制和故障恢复
- 使用高效的二进制数据存储,包括大型对象(如视频等)
- 自动处理碎片,以支持云计算层次的扩展性
- 支持 Python,PHP,Ruby,Java,C,C#,Javascript,Perl 及 C++语言的驱动程序,社区中也提供了对 Erlang 及.NET 等平台的驱动程序
- 文件存储格式为 BSON(一种 JSON 的扩展)
MongoDB 体系结构
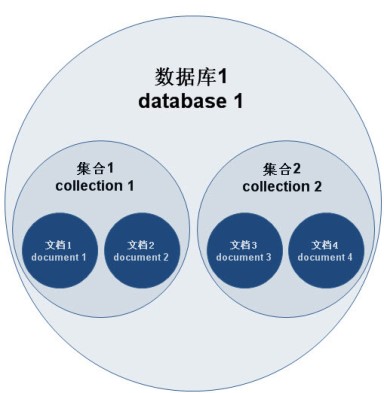
- MongoDB 的逻辑结构是一种层次结构。主要由:文档(document)、集合(collection)、数据库(database)这三部分组成的。
- 逻辑结构是面向用户的,用户使用 MongoDB 开发应用程序使用的就是逻辑结构。
- MongoDB 的文档(document),相当于关系数据库中的一行记录。
- 多个文档组成一个集合(collection),相当于关系数据库的表。
- 多个集合(collection),逻辑上组织在一起,就是数据库(database)。
- 一个 MongoDB 实例支持多个数据库(database)
- 文档(document)、集合(collection)、数据库(database)的层次结构如下图
下表是 MongoDB 与 MySQL 数据库逻辑结构概念的对比
| MongoDb | 关系型数据库 Mysql |
|---|---|
| 数据库(databases) | 数据库(databases) |
| 集合(collections) | 表(table) |
| 文档(document) | 行(row) |
MongoDB 在品优购中的应用
品优购的评价系统、收藏系统采用等信息存储在 MongoDB
品优购-其它业务功能分析
详见 day21 笔记