Appearance
函数(Function)概述
函数是组织好的,可重复使用的,用来实现单一,或相关联功能的代码段。函数能提高应用的模块性,和代码的重复利用率。Python 提供了许多内建函数,也可以创建自定义函数。
函数定义语法
定义函数使用 def 关键字,默认情况下,参数值和参数名称是按函数声明中定义的顺序匹配起来的。一般格式如下:
python
def 函数名(参数列表):
    函数体
示例:
python
def max(a, b):
    if a > b:
        return a
    else:
        return b
# 调用函数
print(max(4, 5))
函数定义规则
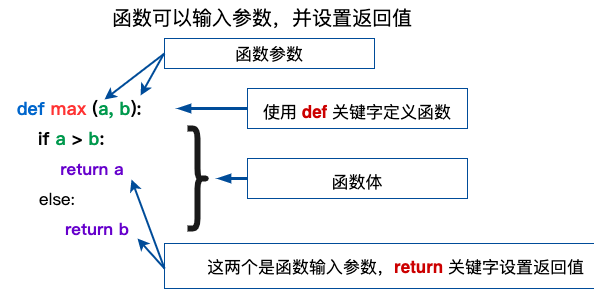
用户自定义函数,有以下基本的规则:
- 函数代码块以
def关键词开头,后接函数标识符名称和圆括号()。 - 任何传入参数和自变量必须放在圆括号中间,圆括号之间可以用于定义参数。
- 函数的第一行语句可以选择性地使用文档字符串—用于存放函数说明。
- 函数内容以冒号
:起始,并且缩进。 return [表达式]结束函数,选择性地返回一个值给调用方,不带表达式的return相当于返回None。
函数的调用
在定义函数的基本结构(名称、函数里包含的参数和代码块结构)完成以后,可以通过另一个函数调用执行,也可以直接从 Python 命令提示符执行。
python
# 定义函数
def max(a, b):
    if a > b:
        return a
    else:
        return b
# 调用函数
print(max(4, 5))
函数的参数
调用函数时可使用几种参数方式:
- 必需参数
- 关键字参数
- 默认参数
- 不定长参数
必需参数
必需参数须以正确的顺序传入函数。调用时的数量必须和声明时的一样,否则会出现语法错误。
python
def printme(str):
    print(str)
    return

# 调用 printme 函数,不加参数会报错
printme()
# TypeError: printme() missing 1 required positional argument: 'str'
关键字参数
关键字参数和函数调用关系紧密,函数调用使用关键字参数来确定传入的参数值,允许函数调用时参数的顺序与声明时不一致,因为 Python 解释器能够用参数名匹配参数值。
python
def printinfo(name, age):
    print("名字: ", name)
    print("年龄: ", age)
    return
# 使用关键字参数方式调用函数
printinfo(age=50, name="MooN")
参数默认值 (可选参数)
默认参数:定义函数时,通过 形参名=值 的形式,为参数指定一个默认值。调用函数时,如果没有传递参数,则会使用默认参数;如果传递了参数,则用传入的值覆盖默认值。以下实例中如果没有传入 age 参数,则使用默认值:
python
def printinfo(name, age=25):
    print("名字: ", name)
    print("年龄: ", age)
    return

printinfo(age=23, name="MooNkirA")
# 调用函数,使用默认参数
printinfo(name="N") # 年龄: 25注意:**默认参数必须要放在必选参数的后面。或者某个形参,一旦设置了默认值,那它后面的所有形参,也必须要写默认值!**
可变参数
有时可能需要一个函数能处理比当初声明时更多的参数,这些参数叫做**可变参数**。声明时不会命名
元组类型的可变参数
元组类型的不定长参数:定义函数时,在形参名前加星号 *,会以元组(tuple)的形式导入,可以接收任意数量的位置参数。如果在函数调用时没有指定参数,它就是一个空元组。也可以不向函数传递未命名的变量。
python
def functionname([formal_args,] *var_args_tuple ):
    "函数_文档字符串"
    function_suite
    return [expression]
示例:
python
def printinfo(arg1, *vartuple):
    print("输出: ")
    print(arg1)
    for var in vartuple:
        print(var)
    return

# 函数调用时没有指定参数,它就是一个空元组。
printinfo(10)
printinfo(70, 60, 50)
字典类型的可变参数
字典类型的不定长参数:定义函数时,在形参名前加两个星号 **,会以字典(dict)的形式导入,可以接收任意数量的关键字参数。
python
def functionname([formal_args,] **var_args_dict ):
    "函数_文档字符串"
    function_suite
    return [expression]
示例:
python
def printinfo(arg1, **vardict):
    print("输出: ")
    print(arg1)
    print(vardict)

# 元组类型的不定长参数
printinfo(1, a=2, b=3)

'''
输出:
1
{'a': 2, 'b': 3}
'''
混合类型的可变参数
注意事项
- 可变位置参数、可变关键字参数,可以同时使用,但必须先写可变位置参数!!
- 可变位置参数、可变关键字参数,也能与其他类型的参数一起使用。
示例:
python
# 定义函数(使用*args去接收:可变位置参数)
def test1(*args):
    print(args)
# 调用
test1('张三', '男', 18, 172)  # ('张三', '男', 18, 172)

# 定义函数(使用**kwargs去接收:可变关键字参数)
def test2(**kwargs):
    print(kwargs)
# 调用
test2(name='张三', gender='男', age=18, height=172)  # {'name': '张三', 'gender': '男', 'age': 18, 'height': 172}

# 定义函数(同时使用:可变位置参数、可变关键字参数)
def test3(*args, **kwargs):
    print(args, end='  ')
    print(kwargs)
# 调用
test3('MooN', '男', age=23, height=180)  # ('MooN', '男')  {'age': 23, 'height': 180}

# 定义函数(同时使用:可变位置参数、可变关键字参数 和 其他类型)
def test4(a, b, *args, c='镜花水月', **kwargs):
    print(f'a: {a}, b: {b}, c: {c}', end='  ')
    print(args, end='  ')
    print(kwargs)
# 调用
test4('MooNkirA', '男', '运动', '摄影', c='天锁斩月', age=24, height=183)  # a: MooNkirA, b: 男, c: 天锁斩月  ('运动', '摄影')  {'age': 24, 'height': 183}
强制关键字参数
声明函数时,参数中可以有单独出现星号 * ,则星号 * 后的参数必须用关键字传入。例如:
python
def f(a, b, *, c):
    return a + b + c

# f(1, 2, 3)  # 报错 TypeError: f() takes 2 positional arguments but 3 were given
f(1, 2, c=3)  # 正常调用,* 后参数必须用关键字传入
强制位置参数
Python 3.8 新增了一个函数形参语法 /,用来指明函数形参必须使用指定位置参数,不能使用关键字参数的形式。
python
def f(a, b, /, c, d, *, e, f):
    print(a, b, c, d, e, f)
在以上示例,形参 a 和 b 必须使用指定位置参数,c 或 d 可以是位置形参或关键字形参,而 e 和 f 要求为关键字形参
python
def f(a, b, /, c, d, *, e, f):
    print(a, b, c, d, e, f)

# 正确调用
f(10, 20, 30, d=40, e=50, f=60)
# 错误调用
f(10, b=20, c=30, d=40, e=50, f=60)  # b 不能使用关键字参数的形式
f(10, 20, 30, 40, 50, f=60)  # e 必须使用关键字参数的形式
参数传递
在 python 中,类型属于对象,对象有不同类型的区分,变量是没有类型的:
可变(mutable)与不可变(immutable)对象
在 python 中,strings, tuples, 和 numbers 是不可更改的对象,而 list, dict 等则是可以修改的对象。
- 不可变类型:变量赋值
a = 5后再赋值a = 10,这里实际是新生成一个 int 值对象 10,再让 a 指向它所在的内存地址,而 5 被丢弃,不是改变 a 的值,相当于新生成了 a。 - 可变类型:变量赋值
myList = [1,2,3,4]后再赋值myList[2]=5则是将 myList 的第三个元素值更改,但本身 myList 没有动,只是其内部的一部分值被修改了。
python 函数的参数传递:
- 不可变类型:类似 C++ 的值传递,如整数、字符串、元组。如 fun(a),传递的只是 a 的值,没有影响 a 对象本身。如果在 fun(a) 内部修改 a 的值,则是新生成一个 a 的对象。
- 可变类型:类似 C++ 的引用传递,如 列表,字典。如 fun(la),则是将 la 真正的传过去,修改后 fun 外部的 la 也会受影响
传不可变对象实例
通过 id() 函数来查看内存地址变化。以下示例的形参和实参指向的是同一个对象(对象 id 相同),在函数内部修改形参后,形参指向的是不同的 id。
python
def change(a):
    print(id(a))  # 指向的是同一个对象
    a = 10
    print(id(a))  # 一个新对象

a = 1
print(id(a))
change(a)

'''
以上实例输出结果为:
4379369136
4379369136
4379369424
'''
传可变对象实例
可变对象在函数里修改了参数,那么在调用这个函数里,原始的参数也被改变了。例如,“传入函数的形参”和“在函数里对参数末尾添加新内容的对象”用的是同一个引用。故输出结果如下:
python
def changeme(mylist):
    "修改传入的列表"
    mylist.append([1, 2, 3, 4])
    print("函数内取值: ", mylist)
    return

mylist = [10, 20, 30]
changeme(mylist)  # 函数内取值:  [10, 20, 30, [1, 2, 3, 4]]
print("函数外取值: ", mylist)  # 函数外取值:  [10, 20, 30, [1, 2, 3, 4]]
函数参数的组包与解包
组包与解包概述
组包与解包的核心作用是:简化函数参数传递,让函数支持任意数量、任意类型的参数,提高代码灵活性。
- 组包(Packing):在函数形参中使用
*或**,将调用函数时传入的多个零散参数,打包成一个元组或字典,方便函数内部统一处理。 - 解包(Unpacking):在函数实参中使用
*或**,将容器类型数据(列表、元组、字符串、字典)拆分成多个独立的参数,传递给函数。
涉及的核心符号:
*:处理位置参数、可迭代对象(列表/元组/字符串/range)**:处理关键字参数、字典
参数组包(函数形参中使用)
组包仅用于定义函数时的形参,分为位置参数组包和关键字参数组包。
位置参数组包
- 语法:
def 函数名(*args): - 规则:
*必须写在形参名前,args是约定俗成的名称(可自定义)- 接收函数调用时传入的所有多余位置参数
- 打包后的数据类型是元组(tuple)
- 支持接收 0 个、1 个、多个位置参数
python
# 定义函数,使用*args组包位置参数
def demo(*args):
    print("组包后的数据类型:", type(args))  # <class 'tuple'>
    print("组包后的数据:", args)

# 调用函数,传入任意数量的位置参数
demo()  # 无参数:()
demo(10)  # 1个参数:(10,)
demo(10, 20, 30)  # 多个参数:(10, 20, 30)
demo("Python", 3.14, True)  # 混合类型:('Python', 3.14, True)
关键字参数组包
- 语法:
def 函数名(**kwargs): - 规则:
**必须写在形参名前,kwargs是约定俗成的名称- 接收函数调用时传入的所有多余关键字参数
- 打包后的数据类型是字典(dict):
键=参数名,值=参数值
python
# 定义函数,使用**kwargs组包关键字参数
def demo(**kwargs):
    print("组包后的数据类型:", type(kwargs))  # <class 'dict'>
    print("组包后的数据:", kwargs)

# 调用函数,传入任意数量的关键字参数
demo()  # 无参数:{}
demo(name="张三", age=18)  # 多个关键字参数:{'name': '张三', 'age': 18}
demo(subject="Python", score=100)  # {'subject': 'Python', 'score': 100}
混合组包
- 语法:
def 函数名(*args, **kwargs): - 规则:必须先写
*args,再写**kwargs - 作用:接收任意数量、任意类型的参数(全能型函数)
python
def demo(*args, **kwargs):
    print("位置参数组包:", args)  # (10, 20)
    print("关键字参数组包:", kwargs)  # {'name': '李四', 'age': 20}

# 同时传入位置参数+关键字参数
demo(10, 20, name="李四", age=20)
参数解包(函数实参中使用)
解包仅用于调用函数时的实参,将容器拆分为多个独立参数传递。
解包:可迭代对象(列表/元组/字符串/range)
- 语法:
函数名(*可迭代对象) - 规则:
- 适用于列表、元组、字符串、range 等所有可迭代对象
- 解包后自动转换为位置参数传递给函数
- 解包后的参数数量 必须匹配 函数形参数量
场景1:解包列表/元组
python
# 定义需要2个位置参数的函数
def add(a, b):
    return a + b

# 定义列表/元组
num_list = [10, 20]
num_tuple = (30, 40)

# 普通调用
print(add(10, 20))
# 解包调用(*拆分容器为独立参数)
print(add(*num_list))  # 等价 add(10,20)
print(add(*num_tuple))  # 等价 add(30,40)
场景2:解包字符串
python
def print_char(a, b, c):
    print(a, b, c)

my_str = "abc"
print_char(*my_str)  # 解包为:a b c
场景3:解包 range 对象
python
def get_num(a, b):
    print(a, b)

get_num(*range(1, 3))  # 解包range(1,3)为 1,2
场景4:print 函数解包(高频用法)
python
# 直接打印列表:[1,2,3]
print([1,2,3])
# 解包后打印:1 2 3
print(*[1,2,3])
解包:字典对象
- 语法:
函数名(**字典) - 规则:
- 仅适用于字典(dict)
- 解包后自动转换为关键字参数(
key=value)传递给函数 - 字典的键必须和函数形参名完全一致
python
# 定义需要关键字参数的函数
def user_info(name, age):
    print(f"姓名:{name},年龄:{age}")

# 定义字典(键与形参名一致)
user_dict = {"name": "MooN", "age": 18}

# 普通调用
user_info(name="Zero", age=18)
# 解包调用(**拆分字典为关键字参数)
user_info(**user_dict)
组包 + 解包(进阶,混合使用)
函数定义时组包,调用时解包,实现参数的灵活传递。
python
# 定义函数:组包任意参数
def func(*args, **kwargs):
    print("位置参数:", args)
    print("关键字参数:", kwargs)

# 定义容器数据
my_list = [1, 2, 3]
my_dict = {"a": 10, "b": 20}

# 调用函数:解包容器传递参数
func(*my_list, **my_dict)
# 位置参数: (1, 2, 3)
# 关键字参数: {'a': 10, 'b': 20}
混合函数参数完整顺序规则(必记)
当函数中同时存在普通参数、*args、默认参数、**kwargs 时,必须严格遵循以下顺序:
python
def 函数名(普通位置参数, *args, 默认参数, **kwargs):正确示例:
python
def demo(a, b, *args, c=10, **kwargs):
    print(a, b)
    print(args)
    print(c)
    print(kwargs)

demo(1, 2, 3, 4, c=20, name="MooN")
错误示例(顺序颠倒会报错):
python
# 报错:参数顺序错误
def demo(**kwargs, *args):
    pass
核心知识点总结
- 组包:用于函数形参,
*args打包成元组(不可变),**kwargs打包成字典 - 解包:用于调用函数的实参,
*拆可迭代对象为位置参数,**拆字典为关键字参数 - 不可变限制:组包后的
args是元组,无法修改 - 匹配规则:解包后的参数数量/名称,必须与函数形参匹配
- 通用场景:
*args和**kwargs是编写通用函数、装饰器的核心语法
函数返回值
核心概念概述
函数返回值:函数执行完毕后返回给调用者的结果。通过返回值,函数可以将内部计算或处理的结果传递给外部代码使用,实现数据的“输出”功能。
return 语句的作用
return 是 Python 中用于指定函数返回值的关键字,其核心作用包括:
- 终止函数的执行。一旦执行到
return,函数立即停止,后续代码不再运行。 - 将
return后面的表达式结果返回给函数调用者。
基本语法:
python
def 函数名(参数列表):
    # 函数体
return 表达式 # 表达式的结果即为返回值无返回值的两种写法:
python
# 写法1:无 return 语句
def func1():
    print("仅执行操作,无显式返回")

# 写法2:return 后无表达式
def func2():
    print("执行操作后返回")
    return  # 等价于 return None
示例:
python
def sum(arg1, arg2):
    total = arg1 + arg2
    print("函数内 : ", total)
    return total

# 调用 sum 函数
total = sum(10, 20)
print("函数外 : ", total)
默认返回值(None)
以下场景函数会默认返回 None(Python 中表示“空值”的特殊对象):
- 函数中没有显式使用
return语句。 return后无任何表达式。- 显式写
return None。
注意:不要混淆 `return None` 和无返回值的情况
显式返回 None 的使用场景:函数执行失败或无需返回有效结果时,显式返回 None 便于调用者判断。
python
def divide(a, b):
    if b == 0:
        print("除数不能为0")
        return None  # 显式返回 None 表示失败
    return a / b

result = divide(10, 0)
if result is None:
    print("计算失败")
else:
    print(f"结果: {result}")
返回值的使用要点及注意事项
return 会立即终止函数执行
函数中一旦执行到 return,后续的所有代码都不会被执行。一般使用场景是,在条件判断中提前终止函数(如参数校验失败时直接返回)。
python
def check_positive(num):
    if num <= 0:
        return "参数必须为正数"  # 条件满足时直接返回,后续代码不执行
    return f"{num} 是正数"

print(check_positive(-5))  # 输出:参数必须为正数
print(check_positive(10))  # 输出:10 是正数
函数中可以有多个 return 语句
多个 return 通常配合条件判断使用,不同分支返回不同结果。
python
def calculate_score(score):
    if score >= 90:
        return "优秀"
    elif score >= 80:
        return "良好"
    elif score >= 60:
        return "及格"
    else:
        return "不及格"

print(calculate_score(85))  # 输出:良好
多个返回值
Python 支持通过 return 返回多个值,本质是返回一个元组(也可返回列表、字典等容器)。
- 返回元组(默认方式):需要同时返回多个关联结果(如计算两个数的和、差、积)。
python
def calculate(a, b):
    sum_ab = a + b
    diff_ab = a - b
    product_ab = a * b
    return sum_ab, diff_ab, product_ab  # 等价于 return (sum_ab, diff_ab, product_ab)

# 调用时可直接解包接收
s, d, p = calculate(10, 3)
print(f"和: {s}, 差: {d}, 积: {p}")  # 输出:和: 13, 差: 7, 积: 30

# 也可接收为元组
result = calculate(5, 2)
print(result) # 输出:(7, 3, 10)- 返回列表:返回的多个值需要后续修改(列表是可变对象)。
python
def get_even_numbers(n):
    return [i for i in range(n) if i % 2 == 0]

evens = get_even_numbers(10)
evens.append(10)  # 可修改返回的列表
print(evens) # 输出:[0, 2, 4, 6, 8, 10]- 返回字典:返回的多个值需要通过键名明确标识(提高可读性)。
python
def get_user_info():
    return {
        "name": "张三",
        "age": 25,
        "city": "广州"
    }

user = get_user_info()
print(user["name"])  # 输出:张三
返回函数(闭包)
Python 中函数也可以作为返回值返回(通常用于实现闭包或工厂函数)。
示例:根据参数动态生成不同的处理函数(如根据配置生成不同的计算函数)。
python
def create_multiplier(factor):
    # 定义内部函数,使用外部函数的 factor 变量
    def multiplier(n):
        return n * factor
    return multiplier  # 返回内部函数

# 生成两个不同的乘法函数
double = create_multiplier(2)
triple = create_multiplier(3)

print(double(5))   # 输出:10
print(triple(5))   # 输出:15
返回值类型注解
Python 3.5+ 支持类型注解,可通过 -> 类型 标注函数的返回值类型(仅为提示,不强制检查)。其核心作用是,提高代码可读性,便于 IDE 进行类型检查和提示。
python
def add(a: int, b: int) -> int:
    """
    计算两个整数的和
    :param a: 第一个整数
    :param b: 第二个整数
    :return: 两数之和(整数类型)
    """
    return a + b

# 调用时 IDE 会提示返回值为 int 类型
result = add(3, 5)
print(result)  # 输出:8
匿名函数
核心概念
匿名函数是 Python 中无需使用 def 关键字定义、没有函数名称的小型函数,通过 lambda 关键字创建,因此也常被称为“lambda 函数”。它仅能包含一个表达式,执行后自动返回表达式的结果,适合处理简单、一次性使用的逻辑。与普通 def 函数的区别如下:
| 特性 | 匿名函数(lambda) | 普通函数(def) |
|---|---|---|
| 定义方式 | lambda 关键字 | def 关键字 |
| 函数名称 | 无(仅绑定到变量时有名) | 必须指定函数名 |
| 主体内容 | 仅一个表达式 | 可包含多个语句、代码块 |
| 返回值 | 自动返回表达式结果 | 需显式使用 return |
| 文档字符串(docstring) | 不支持 | 支持 |
lambda 函数的特点:
- lambda 函数拥有自己的命名空间,且不能访问自己参数列表之外或全局命名空间里的参数。
- 虽然 lambda 函数看起来只能写一行,却不等同于 C 或 C++ 的内联函数,内联函数的目的是调用小函数时不占用栈内存从而减少函数调用的开销,提高代码的执行速度。
lambda 函数语法格式
python
lambda 参数列表: 表达式
# 无参数
lambda: 表达式
基础示例:
python
# 匿名函数示例:计算两数之和
add_lambda = lambda x, y: x + y

# 等价的普通函数
def add_def(x, y):
    return x + y

# 调用方式完全相同
print(add_lambda(3, 5))  # 输出:8
print(add_def(3, 5))     # 输出:8
使用要点及注意事项
只能包含一个表达式
lambda 函数的主体必须是单个表达式,不能包含语句/代码块(如 print、if-else 多分支、for 循环等),但支持使用**条件表达式(三目运算符)**实现简单分支。
python
# 示例1:使用条件表达式判断正负
check_sign = lambda x: "正数" if x > 0 else "非正数"
print(check_sign(10))   # 输出:正数
print(check_sign(-5))   # 输出:非正数

# 反例:不能包含 print 语句(print 是语句,不是表达式)
# error_lambda = lambda x: print(x)  # 语法上允许,但不推荐用于复杂副作用
参数支持多种形式
lambda 函数的参数规则与普通函数一致,支持位置参数、默认参数、可变参数(*args)、关键字可变参数(**kwargs)。可以根据不同需求灵活传递参数。
python
# 示例1:位置参数
multiply = lambda x, y: x * y
print(multiply(3, 4))  # 输出:12

# 示例2:默认参数
power = lambda x, y=2: x ** y
print(power(3))        # 输出:9(默认 y=2)
print(power(3, 3))     # 输出:27

# 示例3:可变参数(*args)
sum_all = lambda *args: sum(args)
print(sum_all(1, 2, 3, 4))  # 输出:10

# 示例4:关键字可变参数(**kwargs)
sum_kwargs = lambda **kwargs: sum(kwargs.values())
print(sum_kwargs(a=1, b=2, c=3))  # 输出:6
自动返回表达式结果
lambda 函数无需显式使用 return,表达式的计算结果会自动作为返回值返回,简化简单函数的返回逻辑。
python
# 示例:直接返回列表推导式结果
get_evens = lambda n: [i for i in range(n) if i % 2 == 0]
print(get_evens(10))  # 输出:[0, 2, 4, 6, 8]
作用域与变量捕获(闭包注意事项)
lambda 函数可以捕获外部作用域的变量(形成闭包),但需注意:lambda 捕获的是变量的引用,而非变量的当前值。若外部变量在 lambda 定义后发生变化,lambda 的执行结果也会改变,需注意避免变量捕获的常见陷阱。
捕获外部作用域的变量示例:
python
def make_multiplier(factor):
    # 返回一个 lambda 闭包,捕获外部变量 factor
    return lambda x: x * factor

# 生成两个不同的乘法函数
double = make_multiplier(2)
triple = make_multiplier(3)

print(double(5))  # 输出:10
print(triple(5))  # 输出:15
变量捕获的常见陷阱示例:
python
# 反例:变量捕获的陷阱(循环中定义 lambda)
funcs = []
for i in range(3):
    funcs.append(lambda: i)  # 所有 lambda 都捕获变量 i 的引用

for f in funcs:
    print(f())  # 输出:2, 2, 2(循环结束后 i=2)

# 正例:用默认参数绑定当前值(利用默认参数在函数定义时求值的特性)
funcs = []
for i in range(3):
    funcs.append(lambda i=i: i)  # 默认参数 i=i 绑定当前循环的 i 值

for f in funcs:
    print(f())  # 输出:0, 1, 2
以返回值的形式返回
可以将匿名函数封装在一个函数内,并以返回值的形式返回,这样可以使用同样的代码来创建多个匿名函数。
python
def myfunc(n):
    return lambda a: a * n

mydoubler = myfunc(2)
mytripler = myfunc(3)

print(mydoubler(11))  # 22
print(mytripler(11))  # 33
类型注解支持(Python 3.6+)
Python 3.6+ 支持对 lambda 函数进行类型注解,需通过变量注解或函数返回值注解实现(lambda 本身无法直接写注解)。提高代码可读性,便于 IDE 进行类型检查。
python
from typing import Callable

# 示例1:变量注解标注 lambda 的类型
add: Callable[[int, int], int] = lambda x, y: x + y
print(add(3, 5))  # 输出:8

# 示例2:函数返回值注解标注返回的 lambda 类型
def create_adder() -> Callable[[int, int], int]:
    return lambda x, y: x + y

adder = create_adder()
print(adder(2, 4))  # 输出:6
在 GUI 编程中的简单应用
lambda 函数可作为 GUI 框架(如 Tkinter)中按钮、菜单等组件的回调函数,作为简单的 GUI 事件处理,避免为简单回调定义单独的 def 函数。
python
import tkinter as tk

root = tk.Tk()
root.title("Lambda 回调示例")

# 用 lambda 直接定义按钮点击回调
btn = tk.Button(
    root,
    text="点击我",
    command=lambda: print("按钮被点击了!")
)
btn.pack(pady=20)

root.mainloop()
匿名函数使用场景总结
- 适用场景:
- 作为高阶函数(
sorted()、map()、filter())的参数。 - 实现简单的闭包。
- 一次性使用的简单逻辑(无需复用),避免为临时逻辑定义完整的
def函数。
- 作为高阶函数(
- 不适用场景:
- 复杂逻辑(多分支、循环、异常处理);
- 需要文档字符串(docstring)说明函数用途;
- 需要复用的函数(建议用
def定义)。
高阶函数
高阶函数的概念
Python 中的函数是“一等公民”(First-class Citizen),这意味着函数具备以下特性:
- 可以赋值给变量
- 可以作为参数传递给其他函数
- 可以作为其他函数的返回值
- 可以存储在数据结构(如列表、字典)中
以上的特性是高阶函数存在的基础。在 Python 中,高阶函数(Higher-order Function) 是指满足以下任意一个条件的函数:
- 接受一个或多个函数作为参数,将函数作为输入参数。
- 返回一个函数作为结果,将函数作为输出返回值。
高阶函数是函数式编程的核心特性之一,它允许将函数像普通变量一样传递、操作和返回,从而实现更灵活的代码抽象和逻辑复用。常用场景如下:
- 对数据进行批量处理(如排序、映射、过滤)
- 动态生成特定功能的函数(如工厂函数、闭包)
- 实现代码的解耦和复用(如装饰器)
python
# 示例:函数作为一等公民的基本操作
def greet(name):
    return f"你好,{name}!"

# 1. 函数赋值给变量
say_hello = greet
print(say_hello("张三"))  # 输出:你好,张三!

# 2. 函数存储在列表中
func_list = [greet, str.upper]
print(func_list[0]("李四"))  # 输出:你好,李四!
print(func_list[1]("hello"))  # 输出:HELLO
常用高阶函数
sorted 函数
sorted(iterable, key=None, reverse=False):对可迭代对象进行排序,返回一个新的排序后的列表(不修改原可迭代对象)。- 参数
iterable:待排序的可迭代对象(如列表、元组、字符串、字典等)。 - 参数
key:可选,函数类型,用于指定生成排序键的函数(默认None,直接比较元素)。 - 参数
reverse:可选,布尔值,True表示降序,False表示升序(默认False)。 - 返回值:新的排序后的列表。
- 参数
使用场景:对任意可迭代对象进行灵活排序(如按字符串长度、元组指定字段、对象属性排序)。
python
# 示例1:基础排序(升序/降序)
nums = [3, 1, 4, 1, 5, 9, 2, 6]
sorted_nums_asc = sorted(nums)  # 升序(默认)
sorted_nums_desc = sorted(nums, reverse=True)  # 降序
print(sorted_nums_asc)  # 输出:[1, 1, 2, 3, 4, 5, 6, 9]
print(sorted_nums_desc)  # 输出:[9, 6, 5, 4, 3, 2, 1, 1]

# 示例2:按 key 函数排序(字符串长度)
words = ["apple", "banana", "cherry", "date"]
sorted_words = sorted(words, key=lambda x: len(x))
print(sorted_words)  # 输出:['date', 'apple', 'banana', 'cherry']

# 示例3:按元组的第二个元素排序
tuples = [(1, 3), (2, 1), (3, 2)]
sorted_tuples = sorted(tuples, key=lambda x: x[1])
print(sorted_tuples)  # 输出:[(2, 1), (3, 2), (1, 3)]

# 示例4:对字典排序(按 key 或 value)
scores = {"张三": 85, "李四": 92, "王五": 78}
# 按 key 排序
sorted_by_key = sorted(scores.items(), key=lambda x: x[0])
# 按 value 降序排序
sorted_by_value = sorted(scores.items(), key=lambda x: x[1], reverse=True)
print(sorted_by_key)  # 输出:[('张三', 85), ('李四', 92), ('王五', 78)]
print(sorted_by_value)  # 输出:[('李四', 92), ('张三', 85), ('王五', 78)]
list.sort 方法
list.sort(key=None, reverse=False):对列表本身进行排序(直接修改原列表,无返回值),参数规则与sorted()完全一致。- 参数
key:可选,函数类型,生成排序键的函数。 - 参数
reverse:可选,布尔值,True降序,False升序(默认)。 - 返回值:
None(注意:不会返回新列表,直接修改原列表)。
- 参数
使用场景:当不需要保留原列表,仅需对列表本身进行排序时(节省内存)。
python
# 示例:原地排序
nums = [3, 1, 4, 1, 5]
result = nums.sort()  # 无返回值
print(nums)  # 输出:[1, 1, 3, 4, 5](原列表被修改)
print(result)  # 输出:None
map 函数
map(function, iterable, ...):将function应用于iterable的每个元素,返回一个包含处理结果的迭代器。若提供多个可迭代对象,function需接受对应数量的参数,并行处理元素(元素数量以最短的可迭代对象为准)。- 参数
function:应用于每个元素的函数(可以是 lambda、普通函数或内置函数)。 - 参数
iterable:一个或多个可迭代对象。 - 返回值:迭代器,包含
function处理后的结果。
- 参数
使用场景:对数据进行批量转换或计算(如元素平方、字符串格式化、多列表元素相加)。
python
# 示例1:单个可迭代对象(元素平方)
nums = [1, 2, 3, 4]
squared = map(lambda x: x ** 2, nums)
print(list(squared))  # 输出:[1, 4, 9, 16](迭代器转列表)

# 示例2:多个可迭代对象(并行相加)
a = [1, 2, 3]
b = [4, 5, 6]
c = [7, 8]  # 最短的可迭代对象,结果长度为 2
sum_abc = map(lambda x, y, z: x + y + z, a, b, c)
print(list(sum_abc))  # 输出:[12, 15]

# 示例3:使用内置函数(字符串转整数)
str_nums = ["1", "2", "3"]
int_nums = map(int, str_nums)
print(list(int_nums))  # 输出:[1, 2, 3]
filter 函数
filter(function, iterable):用function过滤iterable中的元素,返回一个包含使function为True(或真值)的元素的迭代器。- 参数
function:判断函数,接受一个参数,返回布尔值(或真值/假值);若为None,则直接判断元素是否为真值。 - 参数
iterable:待过滤的可迭代对象。 - 返回值:迭代器,包含过滤后的元素。
- 参数
使用场景:从数据集中筛选符合条件的元素(如过滤偶数、过滤非空字符串、过滤真值)。
python
# 示例1:过滤偶数
nums = [1, 2, 3, 4, 5, 6]
evens = filter(lambda x: x % 2 == 0, nums)
print(list(evens))  # 输出:[2, 4, 6]

# 示例2:过滤非空字符串
words = ["apple", "", "banana", None, "cherry", "   "]
non_empty = filter(lambda x: x and x.strip(), words)
print(list(non_empty))  # 输出:['apple', 'banana', 'cherry']

# 示例3:function 为 None(过滤真值)
values = [0, 1, "", "hello", None, [], [1, 2]]
truthy = filter(None, values)
print(list(truthy))  # 输出:[1, 'hello', [1, 2]]
functools.reduce 函数
functools.reduce(function, iterable[, initializer]):将function累积应用于iterable的元素(从左到右),最终返回一个单一值。- 参数
function:接受两个参数的函数,第一个参数是累积值,第二个参数是当前元素。 - 参数
iterable:待处理的可迭代对象。 - 参数
initializer:可选,初始累积值;若提供,先与第一个元素处理;否则第一个元素为初始值。 - 返回值:最终累积值。
- 参数
使用场景:对数据进行累积计算(如求和、求积、字符串拼接、找最大值)。
python
from functools import reduce

# 示例1:求和(带/不带初始值)
nums = [1, 2, 3, 4]
sum_without_init = reduce(lambda x, y: x + y, nums)  # 等价于 (((1+2)+3)+4)
sum_with_init = reduce(lambda x, y: x + y, nums, 10)  # 等价于 ((((10+1)+2)+3)+4)
print(sum_without_init)  # 输出:10
print(sum_with_init)  # 输出:20

# 示例2:求积
product = reduce(lambda x, y: x * y, nums)
print(product)  # 输出:24

# 示例3:找最大值
max_num = reduce(lambda x, y: x if x > y else y, nums)
print(max_num)  # 输出:4

# 示例4:字符串拼接
words = ["Hello", " ", "World", "!"]
sentence = reduce(lambda x, y: x + y, words)
print(sentence)  # 输出:Hello World!
functools.partial 偏函数
functools.partial(func, *args, **keywords):偏函数,用于固定原函数的部分参数(位置参数或关键字参数),返回一个新的函数(调用新函数时只需传入剩余参数)。- 参数
func:原函数。 - 参数
*args:要固定的位置参数。 - 参数
**keywords:要固定的关键字参数。 - 返回值:新的函数,已固定部分参数。
- 参数
常用场景:简化频繁调用的函数(如固定进制转换、固定排序规则)。
python
from functools import partial

# 示例1:固定 int() 的 base 参数(二进制转十进制)
# 原函数:int(x, base=10)
bin_to_dec = partial(int, base=2)
print(bin_to_dec("1010"))  # 输出:10(等价于 int("1010", base=2))
print(bin_to_dec("1111"))  # 输出:15

# 示例2:固定 sorted() 的 key 和 reverse 参数
sort_by_len_desc = partial(sorted, key=lambda x: len(x), reverse=True)
words = ["apple", "banana", "cherry", "date"]
print(sort_by_len_desc(words))  # 输出:['banana', 'cherry', 'apple', 'date']
高阶函数的使用要点及注意事项
合理使用 lambda 作为参数
lambda 函数适合作为高阶函数的简单参数(如 sorted() 的 key、map() 的转换函数),但如果逻辑复杂(超过一个表达式),应定义普通 def 函数以提高可读性。
- 反例:过度复杂的
lambda(难以阅读)。 - 正例:简单逻辑用
lambda,复杂逻辑用def。
python
# 反例:复杂逻辑用 lambda(不推荐)
data = [(1, "apple", 3.5), (2, "banana", 2.5), (3, "cherry", 4.0)]
# 按第三个元素(价格)降序,若价格相同按第二个元素(名称)升序
sorted_data = sorted(data, key=lambda x: (-x[2], x[1]))

# 正例:复杂逻辑用 def(推荐)
def sort_key(item):
    return (-item[2], item[1])  # 清晰的返回值,可加注释

sorted_data = sorted(data, key=sort_key)
print(sorted_data)  # 输出:[(3, 'cherry', 4.0), (1, 'apple', 3.5), (2, 'banana', 2.5)]
正确处理返回的迭代器
map()、filter() 返回的是迭代器(而非列表),迭代器只能遍历一次,遍历后会“耗尽”。若需要多次使用或查看结果,需将其转换为列表(list())或其他可迭代对象。
python
# 示例:迭代器的耗尽问题
nums = [1, 2, 3]
squared = map(lambda x: x ** 2, nums)

# 第一次遍历(正常)
print(list(squared))  # 输出:[1, 4, 9]
# 第二次遍历(迭代器已耗尽,无输出)
print(list(squared))  # 输出:[]

# 正例:转换为列表保存结果
squared_list = list(map(lambda x: x ** 2, nums))
print(squared_list)  # 输出:[1, 4, 9]
print(squared_list)  # 输出:[1, 4, 9](可多次使用)
避免过度使用高阶函数
高阶函数虽强大,但过度使用(如嵌套 map/filter、复杂的 reduce)会降低代码可读性。对于简单逻辑,列表推导式或生成器表达式通常更直观。
python
# 示例:map/filter vs 列表推导式
nums = [1, 2, 3, 4, 5]

# 方式1:map + filter(可读性一般)
result1 = map(lambda x: x ** 2, filter(lambda x: x % 2 == 0, nums))

# 方式2:列表推导式(更直观,推荐)
result2 = [x ** 2 for x in nums if x % 2 == 0]

print(list(result1))  # 输出:[4, 16]
print(result2)  # 输出:[4, 16]
注意作用域与变量捕获(闭包)
当高阶函数返回一个内部函数(闭包)时,内部函数会捕获外部作用域的变量引用,而非变量的当前值。若外部变量在闭包定义后发生变化,闭包的执行结果也会改变(需用默认参数绑定当前值)。
python
# 反例:闭包变量捕获陷阱
def create_funcs():
    funcs = []
    for i in range(3):
        # 所有 lambda 都捕获变量 i 的引用
        funcs.append(lambda: i)
    return funcs

funcs = create_funcs()
for f in funcs:
    print(f())  # 输出:2, 2, 2(循环结束后 i=2)

# 正例:用默认参数绑定当前值
def create_funcs():
    funcs = []
    for i in range(3):
        # 默认参数 i=i 在函数定义时绑定当前 i 的值
        funcs.append(lambda i=i: i)
    return funcs

funcs = create_funcs()
for f in funcs:
    print(f())  # 输出:0, 1, 2
性能考虑
map()的性能通常略高于列表推导式(因为map是内置函数,底层优化更好),但差异在大多数场景下可忽略。reduce()的性能通常不如直接使用循环(尤其是简单的求和/求积,建议用内置函数sum()、max()、min()替代)。
python
# 示例:用内置函数替代 reduce(更高效、更可读)
nums = [1, 2, 3, 4, 5]

# 不推荐:reduce 求和
sum_reduce = reduce(lambda x, y: x + y, nums)
# 推荐:内置 sum() 函数
sum_builtin = sum(nums)

print(sum_reduce)  # 输出:15
print(sum_builtin)  # 输出:15
装饰器(Decorator)
装饰器是一种特殊的高阶函数,它接受一个函数作为参数,返回一个新的函数(通常会增强原函数的功能,而不修改原函数的代码)。装饰器是 Python 中非常常用的代码复用工具。常用场景有,日志记录、性能计时、权限验证、缓存等。
python
# 示例:简单的计时装饰器
import time

def timer(func):
    def wrapper(*args, **kwargs):
        start = time.time()
        result = func(*args, **kwargs)
        end = time.time()
        print(f"{func.__name__} 执行耗时:{end - start:.4f} 秒")
        return result
    return wrapper

# 使用装饰器(@timer 等价于 slow_func = timer(slow_func))
@timer
def slow_func(n):
    time.sleep(n)
    return f"等待了 {n} 秒"

print(slow_func(1))
# 输出:
# slow_func 执行耗时:1.0001 秒
# 等待了 1 秒
函数式编程工具库
Python 提供了两个常用的函数式编程工具库,包含更多高阶函数:
itertools:提供用于操作迭代器的高效工具(如itertools.starmap、itertools.filterfalse、itertools.accumulate等)。functools:除了reduce和partial,还提供functools.lru_cache(缓存装饰器)、functools.wraps(装饰器辅助工具)等。
python
# 示例:itertools.accumulate(累积迭代器,类似 reduce 但返回中间结果)
from itertools import accumulate

nums = [1, 2, 3, 4]
acc = accumulate(nums, lambda x, y: x + y)
print(list(acc))  # 输出:[1, 3, 6, 10](每次累积的结果)
函数的扩展知识
生成器函数
yield 关键字
yield 是生成器函数的关键字,用于“暂停”函数执行并返回一个值,下次调用时从暂停处继续执行(与 return 不同,yield 不会终止函数)。一般的使用场景是,处理大数据集时,通过生成器逐个返回值,节省内存(无需一次性生成所有数据)。
内置函数 next()
next(iterator):从迭代器(包括生成器)中获取下一个值。- 参数
iterator:可迭代对象(如生成器、列表迭代器等)。 - 返回值:迭代器的下一个值;若没有更多值,抛出
StopIteration异常。
- 参数
python
def count_down(n):
    while n > 0:
        yield n  # 暂停并返回 n
        n -= 1

# 创建生成器对象
gen = count_down(3)

# 使用 next() 逐个获取值
print(next(gen))  # 输出:3
print(next(gen))  # 输出:2
print(next(gen))  # 输出:1
# print(next(gen))  # 再次调用会抛出 StopIteration 异常

# 也可通过 for 循环遍历(自动处理 StopIteration)
for num in count_down(5):
    print(num, end=" ")  # 输出:5 4 3 2 1
递归函数的返回值
递归函数中必须确保每一层递归都能正确返回值,且最终能收敛到基准情况(否则会返回 None 或陷入无限递归)。常见使用场景是,处理可分解为子问题的场景(如阶乘计算、斐波那契数列)。
python
def factorial(n):
    if n == 0 or n == 1:
        return 1  # 基准情况,直接返回 1
    return n * factorial(n - 1)  # 递归调用并返回结果

print(factorial(5))  # 输出:120 (5*4*3*2*1)
使用 namedtuple 或 dataclass 返回结构化数据
返回值包含多个字段且需要明确的属性名时,使用 collections.namedtuple 或 dataclasses.dataclass 比字典更安全(属性名固定,避免拼写错误)。
namedtuple
namedtuple(typename, field_names):内置模块collections.namedtuple,用于创建一个具名元组子类。- 参数
typename:具名元组的类名(字符串)。 - 参数
field_names:字段名列表(如["x", "y"]或"x y")。 - 返回值:一个新的具名元组类,可通过属性名访问字段。
- 参数
python
from collections import namedtuple

# 定义具名元组类 Point
Point = namedtuple("Point", ["x", "y"])

def get_coordinate():
    return Point(x=10, y=20)  # 返回具名元组对象

point = get_coordinate()
print(point.x)  # 输出:10(通过属性名访问,比字典更直观)
print(point.y)  # 输出:20
dataclass (Python 3.7+)
@dataclass:dataclasses.dataclass是 Python 3.7+ 版本新增的装饰器,作用是自动为类生成__init__、__repr__等方法。- 无额外必填参数,直接装饰类即可。
- 类中定义的变量会自动成为实例属性。
python
from dataclasses import dataclass

@dataclass
class User:
    name: str
    age: int
    city: str

def get_user():
    return User(name="李四", age=30, city="深圳")

user = get_user()
print(user.name)  # 输出:李四
print(user)       # 输出:User(name='李四', age=30, city='深圳')(自动生成 __repr__)