Appearance
Redis 的部署方案简述
Redis 的部署分为:Redis 单机版安装、Redis 主从模式安装、Redis 哨兵模式安装和 Redis Cluster(集群模式)安装。
- 单机版:单机部署,单机redis能够承载的 QPS 大概就在上万到几万不等。实际生产这种部署方式很少使用,一般都是用于本地测试开发。存在的问题:
- 内存容量有限
- 处理能力有限
- 无法高可用
- 主从模式:一主多从,主负责写,并且将数据复制到其它的 slave 节点,从节点负责处理所有的读请求。这样也可以很轻松实现水平扩容,支撑读高并发。master 节点挂掉后,需要手动指定新的 master,可用性不高,基本不用。
- 哨兵模式:通过哨兵机制(Sentinel)可以自动切换主从节点,因此解决了主从复制存在不能自动故障转移、达不到高可用的问题。master 节点挂掉后,哨兵进程会主动选举新的 master,可用性高,但是每个节点存储的数据是一样的,浪费内存空间。数据量不是很多,集群规模不是很大,需要自动容错容灾的时候使用。
- Redis cluster:服务端分片技术,3.0版本开始正式提供。Redis Cluster 并没有使用一致性 hash,而是采用slot(槽)的概念,一共分成16384个槽。将请求发送到任意节点,接收到请求的节点会将查询请求发送到正确的节点上执行。主要是针对海量数据+高并发+高可用的场景,如果是海量数据,那么建议使用 Redis cluster,所有主节点的容量总和就是 Redis cluster 可缓存的数据容量。
Redis 单机模式
windows 单机版
直接运行 Redis 服务
Windows 版本的 redis 下载地址:https://github.com/MicrosoftArchive/redis/tags
下载 Redis-x64-3.2.100 版本,解压 Redis-x64-3.2.100.zip 到无中文与空格的目录中。
进入 cmd 命令行,进入 Redis-x64-3.2.100 目录,运行以下命令。(注:如果使用powershell打开,需要在命令前增加“./”)
bash
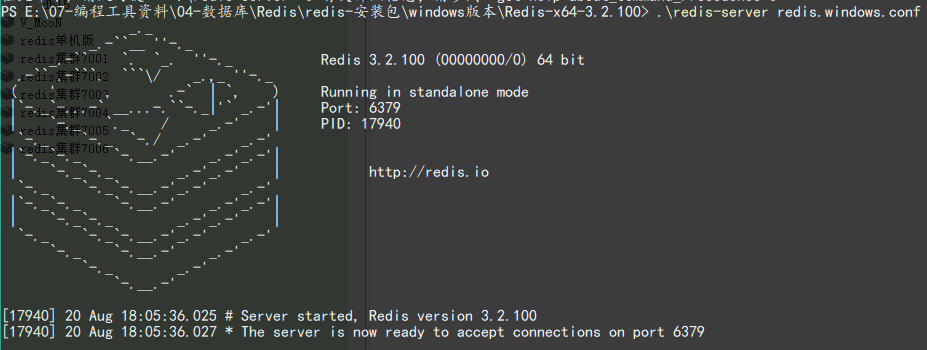
redis-server redis.windows.conf出现下图说明,redis启动成功
将 Redis 注册为服务
- 进入 cmd 命令行,进入 redis 所在目录,运行以下命令(注:如果使用powershell打开,需要在命令前增加“./”)
bash
redis-server --service-install redis.windows-service.conf --loglevel verbose- 成功执行命令后,刷新服务,会看到多了一个redis服务
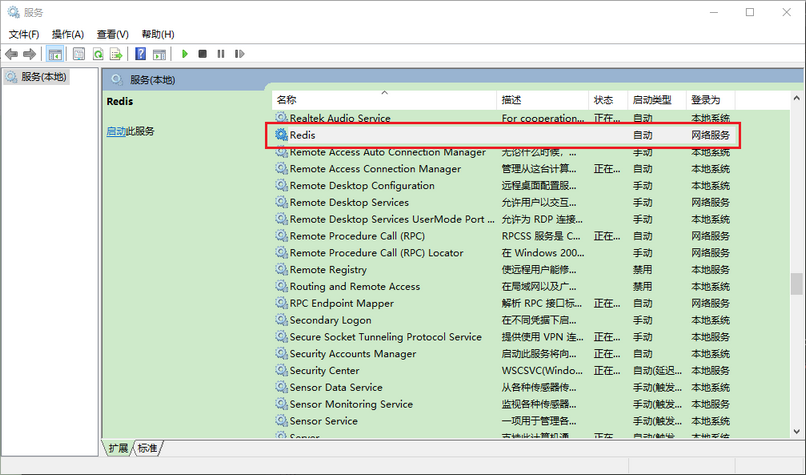
- 进入redis所在目录,输入常用的redis服务命令
bash
redis-server.exe --service-uninstall    # 卸载服务
redis-server.exe --service-start    # 开启服务
redis-server.exe --service-stop    # 停止服务
linux 单机版
安装(压缩包安装)
- 参考文档:
- E:\07-编程工具资料\04-数据库\Redis\Redis安装和使用.docx
- E:\07-编程工具资料\04-数据库\Redis\Redis安装.doc
- 安装 redis 的依赖环境
bash
[root@localhost src]# yum -y install gcc automake autoconf libtool make- 上传安装包
获取到安装包,使用 rz 命令(需要系统支持)并将它上传到 linux 的 /usr/local/src/ 目录下
bash
[root@localhost src]# ls
redis-5.0.4.tar.gz- 解压
解压安装包,得到一个redis-5.0.4目录
bash
[root@localhost src]# tar -zxvf redis-5.0.4.tar.gz
[root@localhost src]# ls
redis-5.0.4 redis-5.0.4.tar.gz- 编译
进入 redis 目录,在目录下执行 make 命令
bash
[root@localhost src]# cd redis-5.0.4
[root@localhost redis-5.0.4]# make- 安装
执行安装命令,注意此处指定了安装目录为 /usr/local/redis
bash
[root@localhost redis-5.0.4]# make PREFIX=/usr/local/redis install- 复制配置文件
将配置文件复制到 redis 的安装目录的bin目录下
bash
[root@localhost redis-5.0.4]# cd /usr/local/redis/bin/
[root@localhost bin]# ls
redis-benchmark redis-check-aof redis-check-rdb redis-cli redis-sentinelredis-server
[root@localhost bin]# cp /usr/local/src/redis-5.0.4/redis.conf ./
[root@localhost bin]# ls
redis-benchmark redis-check-aof redis-check-rdb redis-cli redis.conf redis-sentinel redis-server- 修改redis的配置文件
修改 redis 的配置文件,将注解绑定和保护模式关闭,方便从客户端连接测试
bash
[root@localhost bin]# vim redis.conf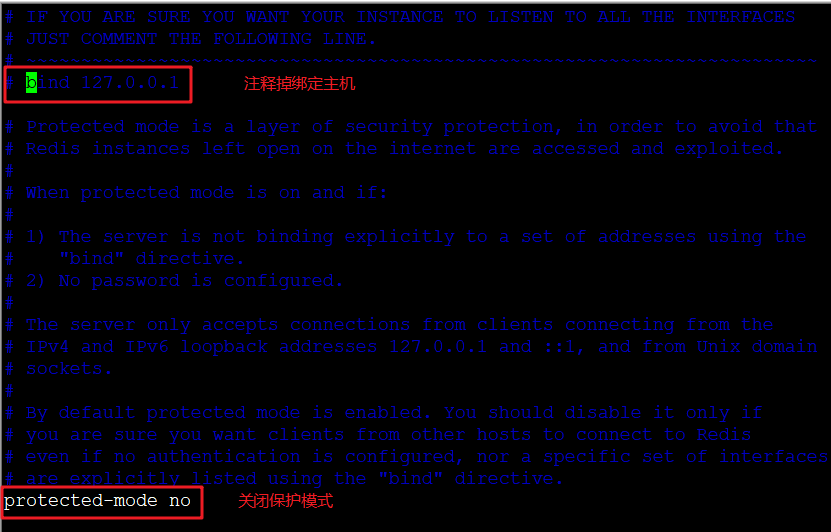
- 启动redis服务
bash
[root@localhost bin]# ./src/redis-server redis.conf &可执行相关文件
| 可执行文件 | 作用 |
|---|---|
| redis-server | 启动 redis |
| redis-cli | redis 命令行客户端 |
| redis-benchmark | 基准测试工具 |
| redis-check-aof | AOF 持久化文件检测和修复工具 |
| redis-check-dump | RDB 持久化文件检测和修复工具 |
| redis-sentinel | 启动哨兵 |
redis-server 服务端启动
默认配置:redis-server,日志输出版本信息,端口:6379
- 启动方式1(不建议),
--port指定端口号
bash
redis-server --port 6380- 启动方式2,以配置文件方式启动
bash
redis-server /opt/redis/redis.conf- 启动方式3:修改 redis.conf 配置文件,增加
daemonize yes配置以后端模式启动。启动时,指定配置文件。
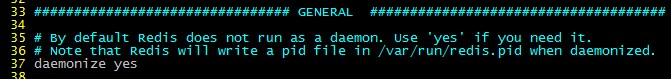
bash
./redis-server redis.confredis-cli 客户端启动与停止
- 交互式启动。
-h用于指定服务器ip,默认是127.0.0.1;-p用于指定服务的端口,默认是 6379;-a用于指定密码
bash
redis-cli -h {host} -p {prot} -a {password}- 命令式启动,直接连接并且操作
bash
redis-cli -h 127.0.0.1 -p 6379 get hello- 停止 redis 服务
bash
# 使用客户端登陆
redis-cli -a 123456
# 关闭前生成持久化文件
shutdown nosave|save
使用以上命令断开连接,持久化文件生成,相对安全。还可以用 kill -9 pid 命令关闭,但此方式不会做持久化,还会造成缓冲区非法关闭,可能会造成 AOF 和丢失数据,所以不推荐。
redis-cli 客户端监控命令
打开 redis-cli 客户端后,输入以下命令打开 redis 服务的数据监控
bash
monitorRedis 主从模式
主从复制
Redis 的主从模式是为了 Redis 服务的高可用。在复制的概念中,数据库分为两类,一类是主数据库(master),另一类是从数据库(slave)。且数据的复制是单向的,只能由主节点到从节点。Redis 主从复制支持主从同步和从从同步,后者是 Redis 后续版本新增的功能,以减轻主节点的同步负担。
Tips: Redis 的复制功能是支持多个数据库之间的数据同步,主从的所存取数据是一样的。一个主数据库可以拥有多个从数据库,而一个从数据库只能拥有一个主数据库,从库还可以作为其他数据库的主库。
主从复制主要的作用:
- 数据冗余:主从复制实现了数据的热备份,是持久化之外的一种数据冗余方式。
- 故障恢复:当主节点出现问题时,可以由从节点提供服务,实现快速的故障恢复 (实际上是一种服务的冗余)。
- 负载均衡:在主从复制的基础上,配合读写分离。一般由主节点提供执行写操作,当写操作导致数据变化时会自动将数据同步给从数据库;而从节点只用于读操作,并接受主数据库同步过来的数据。即写 Redis 数据时应用连接主节点,读 Redis 数据时应用连接从节点。读写分离能更好地分担服务器负载,尤其是在写少读多的场景下,通过多个从节点分担读负载,可以大大提高 Redis 服务器的并发量。
- 高可用基石:主从复制是 Redis 实现高可用的哨兵模式和集群模式的基础。
常用的主从拓扑结构
- 一主一从:用于主节点故障转移从节点,当主节点的“写”命令并发高且需要持久化,可以只在从节点开启AOF(主节点不需要)。
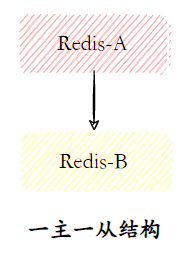
- 一主多从(又称为星形拓扑结构):针对“读”较多的场景,“读”由多个从节点来分担。但节点越多,主节点同步到多节点的次数也越多,影响带宽,也加重主节点的稳定。
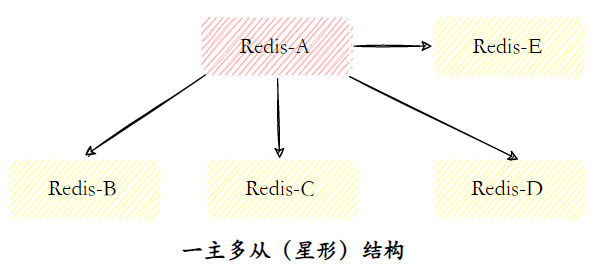
- 树状主从(又称为树状拓扑结构):一主多从的缺点是,主节点推送次数多压力大。而树状主从结构可以使得从节点不但可以复制主节点数据,同时可以作为其他从节点的主节点继续向下层复制。通过引入复制中间层,可以有效降低主节点负载和需要传送给从节点的数据量。例如,主节点只推送一次数据到从节点1,再由从节点2推送到11,从而减轻主节点推送的压力。
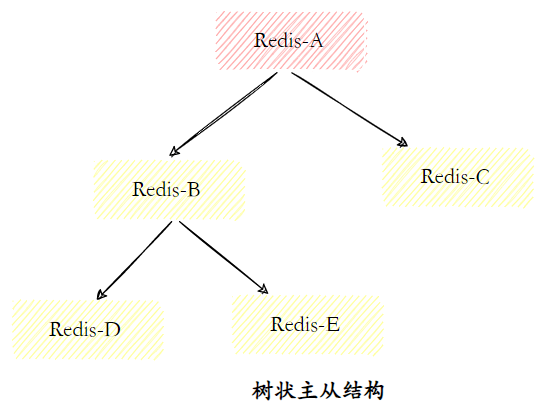
主从复制配置
Redis 开启复制功能时,主数据库无须进行任何配置,而从数据库需要在配置文件中增加以下内容:
properties
# slaveof master_address master_port
slaveof 127.0.0.1 9000
# 如果 master 有密码,则需要设置 masterauth
masterauth=123456在上述配置中,slaveof 后面的配置分别为主数据库的IP地址和端口,在主数据库开启了密码认证后需要将 masterauth 设置为主数据库的密码,在配置完成后重启 Redis,主数据库上的数据就会同步到从数据库上。
主从数据复制的原理
Redis 提供了复制功能,可以实现在主数据库(Master)中的数据更新后,自动将更新的数据同步到从数据库(Slave)。一个主数据库可以拥有多个从数据库,而一个从数据库只能拥有一个主数据库。
Redis 2.8 及以上版本使用 psync 命令完成主从数据同步,同步过程分为:全量复制和部分复制。
主从复制的工作流程
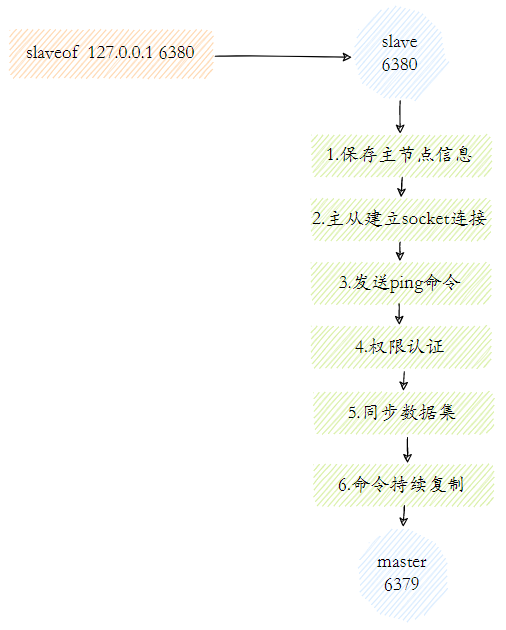
- 保存主节点(master)信息:这一步只是保存主节点信息,保存主节点的 ip 和 port。
- 主从建立连接:从节点(slave)发现新的主节点后,会尝试和主节点建立网络连接。
- 发送 ping 命令:连接建立成功后从节点发送 ping 请求进行首次通信,主要是检测主从之间网络套接字是否可用、主节点当前是否可接受处理命令。
- 权限验证:如果主节点要求密码验证,从节点必须正确的密码才能通过验证。
- 同步数据集:主从复制连接正常通信后,主节点会把持有的数据全部发送给从节点。
- 命令持续复制:接下来主节点会持续地把写命令发送给从节点,保证主从数据一致性。
全量复制
全量复制一般用于初次复制场景,Redis 早期支持的复制功能只有全量复制,它会把主节点全部数据一次性发送给从节点,当数据量较大时,会对主从节点和网络造成很大的开销。全量复制的完整运行流程如下:
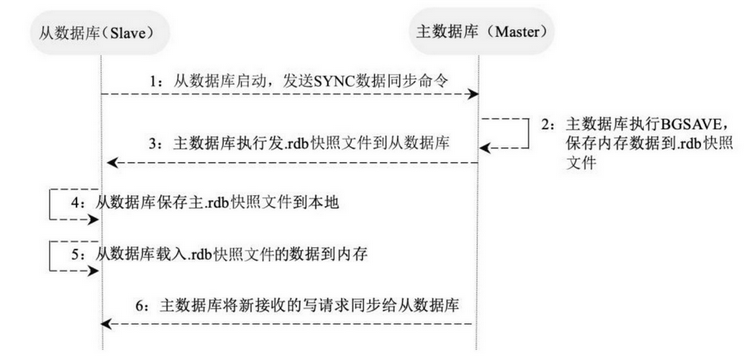
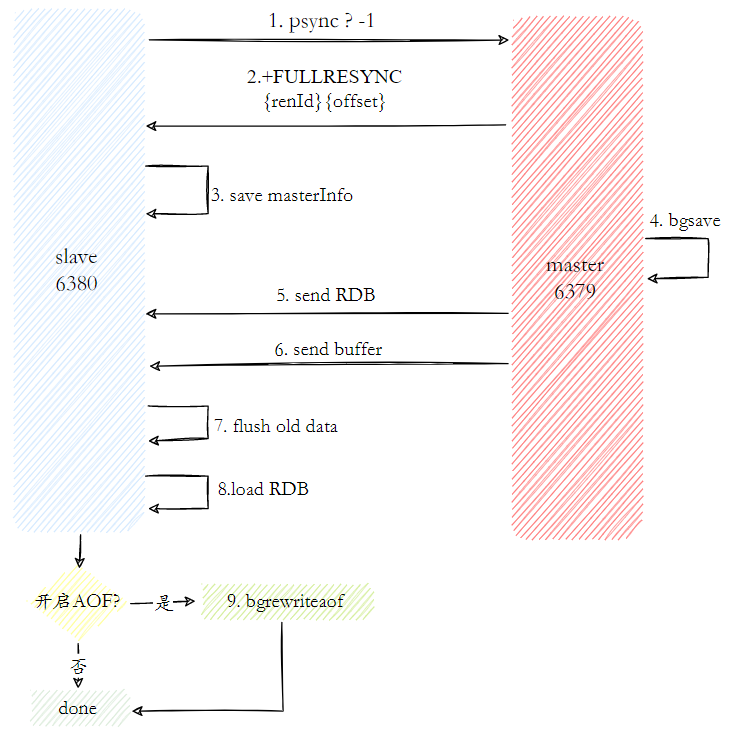
- 一个从数据库在启动后,会向主数据库发送发送
psync命令进行数据同步,由于是第一次进行复制,从节点没有复制偏移量和主节点的运行 ID,所以发送psync-1。 - 主节点根据
psync-1解析出当前为全量复制,回复+FULLRESYNC 响应。 - 从节点接收主节点的响应数据保存运行 ID 和偏移量 offset
- 主节点在接收到 SYNC 命令后,开始在后台执行
bgsave保存 RDB 快照文件到本地(即 RDB 持久化的过程),并将保存快照期间客户端(client)接收到的命令缓存起来。在该持久化过程中会生成一个.rdb快照文件 - 主节点快照执行完成后,Redis 会将快照文件和客户端(client)所有缓存的命令以
.rdb快照文件的形式发送给从节点,从节点把接收的 RDB 快照文件保存在本地磁盘并直接作为从节点的数据文件。 - 对于从节点开始接收 RDB 快照到接收完成期间,主节点仍然响应读写命令,因此主节点会把这期间写命令数据保存在复制客户端缓冲区内,当从节点加载完 RDB 文件后,主节点再把缓冲区内的数据发送给从节点,保证主从之间数据一致性。
- 从节点接收完主节点传送来的全部数据后会清空自身旧数据。
- 从节点清空数据后开始加载 RDB 文件,将数据从本地磁盘加载到内存中。以上过程被称为复制初始化。
- 从节点成功加载完 RDB 后,如果当前节点开启了 AOF 持久化功能, 它会立刻做
bgrewriteaof操作,为了保证全量复制后 AOF 持久化文件立刻可用。 - 在复制初始化结束后,主数据库在每次收到写命令时都会将命令同步给从数据库,从而保证主从数据库的数据一致。
- 如果从节点跟主节点之间网络出现故障,连接断开了,会自动重连,连接之后主节点仅会将部分缺失的数据同步给从节点(这里就会涉及下面的『部分复制』的流程)。
部分复制
部分复制主要是 Redis 针对全量复制的过高开销做出的一种优化措施,使用 psync{runId}{offset} 命令实现。当从节点(slave)正在复制主节点 (master)时,如果出现网络闪断或者命令丢失等异常情况时,从节点会向主节点要求补发丢失的命令数据,如果主节点的复制积压缓冲区内存在这部分数据则直接发送给从节点,这样就可以保持主从节点复制的一致性。
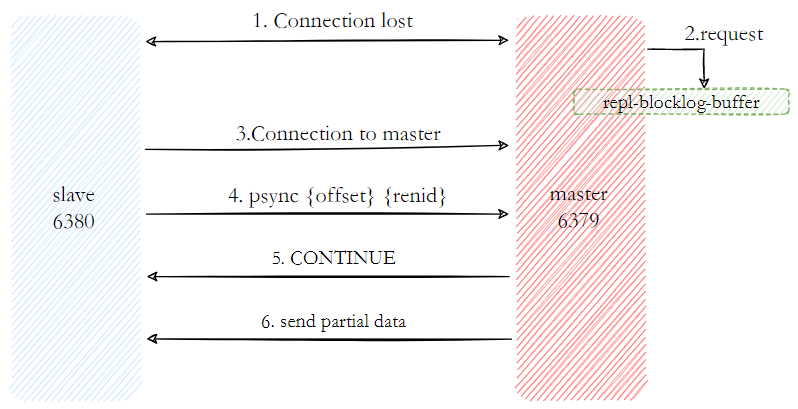
- 当主从节点之间网络出现中断时,如果超过 repl-timeout 时间,主节点会认为从节点故障并中断复制连接。
- 主从连接中断期间主节点依然响应命令,但因复制连接中断命令无法发送给从节点,不过主节点内部存在的复制积压缓冲区,依然可以保存最近一段时间的写命令数据,默认最大缓存1MB。
- 当主从节点网络恢复后,从节点会再次连上主节点。
- 当主从连接恢复后,由于从节点之前保存了自身已复制的偏移量和主节点的运行 ID。因此会把它们当作 psync 参数发送给主节点,要求进行部分复制操作。
- 主节点接到
psync命令后首先核对参数runId是否与自身一致,如果一致,说明之前复制的是当前主节点;之后根据参数offset在自身复制积压缓冲区查找,如果偏移量之后的数据存在缓冲区中,则对从节点发送+CONTINUE响应,表示可以进行部分复制。 - 主节点根据偏移量把复制积压缓冲区里的数据发送给从节点,保证主从复制进入正常状态。
主从模式存在的问题
- 一旦主节点出现故障,需要手动将一个从节点晋升为主节点,同时需要修改应用方的主节点地址,还需要命令其他从节点去复制新的主节点,整个过程都需要人工干预。
- 主节点的写能力受到单机的限制。
- 主节点的存储能力受到单机的限制。
第1个问题是 Redis 的高可用问题;第2、3个问题属于 Redis 的分布式问题。
Redis 哨兵模式
概述
在主从架构中,当主数据库遇到异常中断服务后,开发者可以通过手动的方式选择一个从数据库来升格为主数据库,以使得系统能够继续提供服务。然而整个过程相对麻烦且需要人工介入,难以实现自动化。
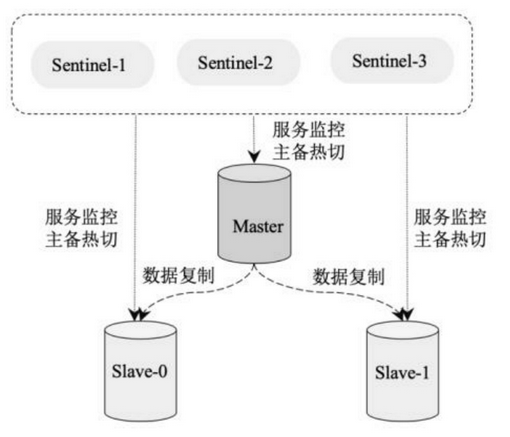
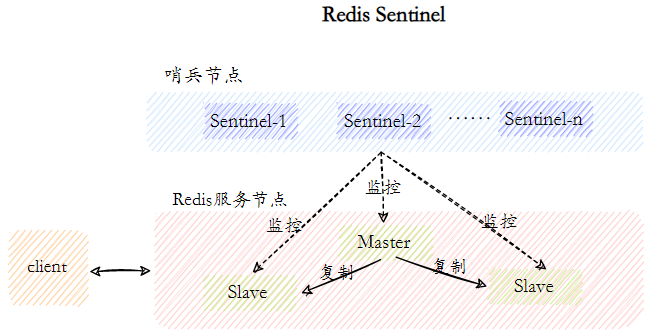
Redis 2.8 开始在主从模式上添加了一个 Redis Sentinel(哨兵)工具,实现自动化监控集群的运行状态和故障恢复功能。哨兵是一个独立运行的进程,通过发送命令让 Redis 服务器返回其运行状态,监控 redis 主、从数据库是否正常运行。Redis Sentinel 由两部分组成:
- 哨兵节点:哨兵系统由一个或多个哨兵节点组成,哨兵节点是特殊的 Redis 节点,不存储数据,只对数据节点进行监控。
- 数据节点:主节点和从节点都是数据节点。
在复制的基础上,哨兵实现了自动化的故障恢复功能:
- 监控(Monitoring):哨兵会不断地检查主节点和从节点是否运作正常。
- 自动故障转移(Automatic failover):当主节点不能正常工作时,哨兵会开始自动故障转移操作,它会将失效主节点的其中一个从节点升级为新的主节点,并让其他从节点改为复制新的主节点。
- 配置提供者(Configuration provider):客户端在初始化时,通过连接哨兵来获得当前 Redis 服务的主节点地址。
- 通知(Notification):哨兵可以将故障转移的结果发送给客户端。
其中,监控和自动故障转移功能,使得哨兵可以及时发现主节点故障并完成转移。而配置提供者和通知功能,则需要在与客户端的交互中才能体现。
哨兵运行流程
客户端连接 Redis 的时候,首先会连接哨兵,哨兵会返回客户端 Redis 主节点的地址,让客户端连接上 Redis 并进行后续的操作。在哨兵监测到 Master 库宕机时会自动推选出某个表现良好的 Slave 库切换成新的 Master 库,然后通过发布与订阅模式通知其他从服务器修改配置文件,完成主备热切。
高可用
高可用,它与被认为是不间断操作的容错技术有所不同。是目前企业防止核心系统因故障而无法工作的最有效保护手段。高可用一般指服务的冗余,一个服务挂了,可以自动切换到另外一个服务上,不影响客户体验
主从如何进行故障转移
当主节点(master)故障,从节点 slave-1 端执行 slaveof no one 后变成新主节点。其它的节点成为新主节点的从节点,并从新节点复制数据。
主从模式下的故障转移需要人工干预,无法实现高可用。
搭建哨兵集群(待整理)
TODO: 待整理
哨兵机制(sentinel)实现高可用原理
哨兵模式是通过哨兵节点完成对数据节点的监控、下线、故障转移。包括以下步骤:
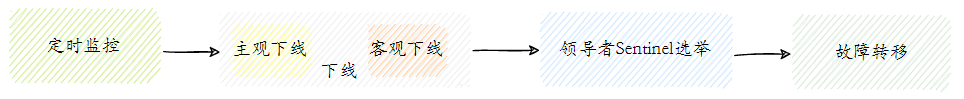
定时监控
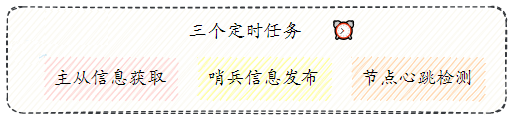
Redis Sentinel 通过 3 个定时监控任务完成对各个节点发现和监控:
- 每隔10秒,每个 Sentinel 节点会向主节点和从节点发送
info命令获取最新的拓扑结构。 - 每隔2秒,每个 Sentinel 节点会向 Redis 数据节点的
__sentinel__:hello频道上发送该 Sentinel 节点对于主节点的判断以及当前 Sentinel 节点的信息。 - 每隔1秒,每个 Sentinel 节点会向主节点、从节点、其余 Sentinel 节点发送一条 ping 命令做一次心跳检测,来确认这些节点当前是否可达。
主观下线和客观下线
主观下线是哨兵节点认为某个节点有问题,而客观下线
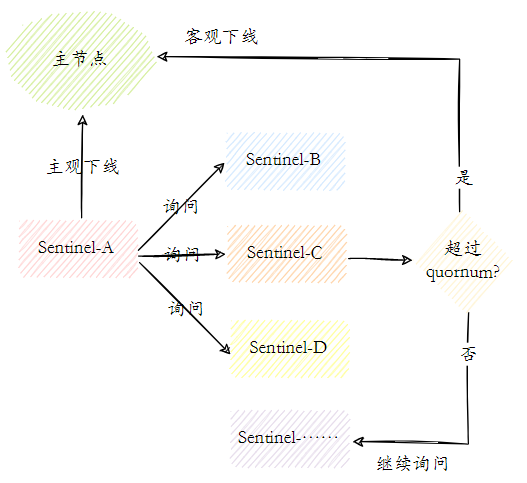
- 主观下线,是哨兵节点认为某个节点有问题。每个 Sentinel 节点会每隔1秒对主节点、从节点、其他 Sentinel 节点发送 ping 命令做心跳检测,当这些节点超过
down-after-milliseconds参数值的时间没有进行有效回复,Sentinel 节点就会对该节点做失败判定,这个行为叫做主观下线。 - 客观下线,是超过一定数量的哨兵节点认为主节点有问题。当 Sentinel 主观下线的节点是主节点时,该 Sentinel 节点会通过
sentinel is-master-down-by-addr命令向其他 Sentinel 节点询问对主节点的判断,当超过<quorum>个数,Sentinel 节点认为主节点确实有问题,这时该 Sentinel 节点会做出客观下线的决定。
领导者 Sentinel 节点选举
Sentinel 节点之间会做一个领导者选举的工作,选出一个 Sentinel 节点作为领导者进行故障转移的工作。Redis 使用了 Raft 算法实现领导者选举。
故障转移
领导者选举出的 Sentinel 节点负责故障转移,过程如下:
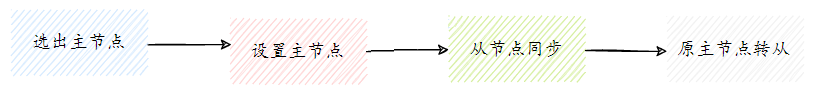
- 在从节点列表中选出一个节点作为新的主节点(流程相对复杂,详见下章节)。
- Sentinel 领导者节点会对第一步选出来的从节点执行
slaveof no one命令让其成为主节点。 - Sentinel 领导者节点会向剩余的从节点发送命令,让它们成为新主节点的从节点。
- Sentinel 节点集合会将原来的主节点更新为从节点,并保持着对其关注,当其恢复后命令它去复制新的主节点。
领导者 Sentinel 节点选举流程
Redis 使用了 Raft 算法实现领导者选举,大致流程如下:
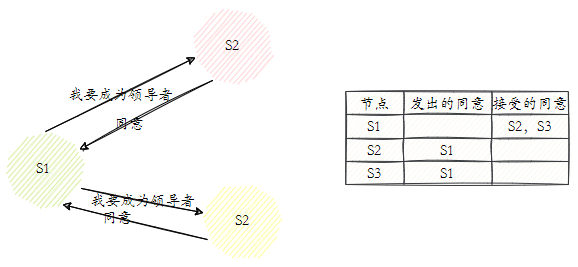
- 每个在线的 Sentinel 节点都有资格成为领导者,当它确认主节点主观下线时候,会向其他 Sentinel 节点发送
sentinel is-master-down-by-addr命令,要求将自己设置为领导者。 - 收到命令的 Sentinel 节点,如果没有同意过其他 Sentinel 节点的
sentinel is-master-down-by-addr命令,将同意该请求,否则拒绝。 - 如果该 Sentinel 节点发现自己的票数已经大于等于
max(quorum, num(sentinels)/2+1),那么它将成为领导者。 - 如果此过程没有选举出领导者,将进入下一次选举。
新的主节点的选取流程
哨兵选取新的主节点的流程分以下几步:
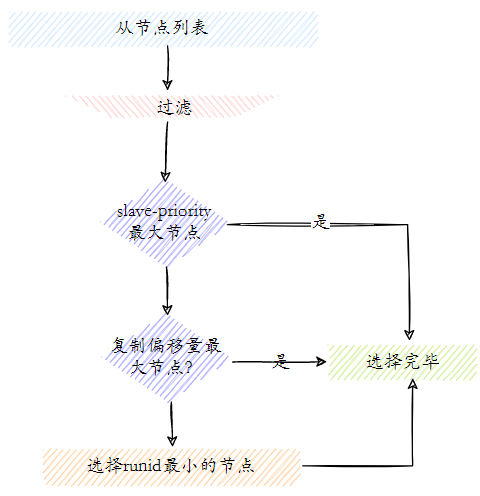
- 过滤“不健康”(主观下线、断线)、5 秒内没有回复过 Sentinel 节点 ping 响应、与主节点失联超过
down-after-milliseconds * 10秒。 - 选择
slave-priority(从节点优先级)最高的从节点列表,如果存在则返回,不存在则继续。 - 选择复制偏移量最大的从节点(复制的最完整),如果存在则返回,不存在则继续。
- 选择
runid最小的从节点。
总结
当主节点出现故障时,由 Redis Sentinel 会自动完成故障发现和转移,并通知应用方,实现高可用性。其工作原理如下:
- 每个 Sentinel 以每秒钟一次的频率向它所知道的 Master,Slave 以及其他 Sentinel 实例发送一个 PING 命令。
- 如果一个实例距离最后一次有效回复 PING 命令的时间超过指定值,则该实例会被 Sentine 标记为主观下线。
- 如果一个 Master 被标记为主观下线,则正在监视这个 Master 的所有 Sentinel 要以每秒一次的频率确认 Master 是否真正进入主观下线状态。
- 当有足够数量的 Sentinel(大于等于配置文件指定值)在指定的时间范围内确认 Master 的确进入了主观下线状态,则 Master 会被标记为客观下线。若没有足够数量的 Sentinel 同意 Master 已经下线,Master 的客观下线状态就会被解除。若 Master 重新向 Sentinel 的 PING 命令返回有效回复,Master 的主观下线状态就会被移除。
- 哨兵节点会选举出哨兵 leader,负责故障转移的工作。
- 哨兵 leader 会推选出某个表现良好的从节点成为新的主节点,然后通知其他从节点更新主节点信息。
Redis cluster
哨兵模式解决了主从复制不能自动故障转移、达不到高可用的问题,但还是存在无法扩展主节点的写能力、存储容量受限于 master 节点能够承载的上限的问题。并且使用哨兵,redis 每个实例存储的内容都是全量、完整的数据,这样会造成内存的浪费。为了最大化利用内存与扩展写能力,可以采用 Redis cluster(集群)模式。
概述
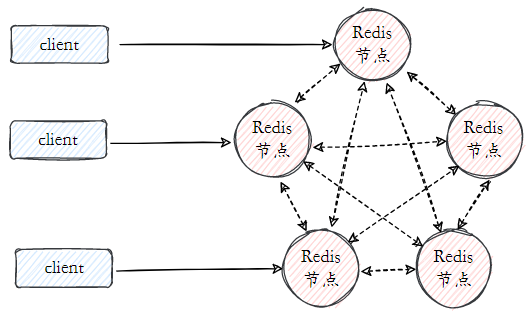
Redis cluster(集群)模式,实现在多个 Redis 节点之间的数据分片(分布式存储)和数据复制。『数据分片』即每台 redis 分别存储不同的内容,共有16384个 slot。每个 redis 分得一些 slot,通过算法hash_slot = crc16(key) mod 16384 找到对应 slot,从而知道数据是存在那个 redis 节点中。特点如下:
- 数据分片(或称数据分区) :集群将数据分散到多个节点,能够方便地对 Redis 集群进行横向扩展,以提高 Redis 集群的吞吐量,是集群最核心的功能。数据分片一方面突破了 Redis 单机内存大小的限制,存储容量大大增加;另一方面每个主节点都可以对外提供读服务和写服务,大大提高了集群的响应能力。
- 高可用:集群支持主从复制和主节点的自动故障转移(与哨兵类似),当任一节点发生故障或者无法进行通信时,集群仍然可以基于副本数据对外提供服务,这提高了集群的可用性。
Tips: Redis 集群目前无法做数据库选择,默认在 0 数据库。
搭建分片集群(待整理)
TODO: 待整理
常见的数据分区方案
节点取余分区
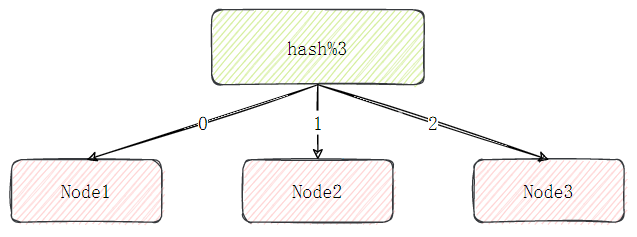
节点取余分区,使用特定的数据,比如 Redis 的键或者用户ID之类,计算相应的 hash 值后对节点数量取余:hash(key) % N,计算的结果来确定数据映射到哪一个节点上。
该方案优点是简单性。但最大的问题是,当节点数量变化时,如扩容或收缩节点,数据节点映射关系需要重新计算,会导致数据的重新迁移。因此扩容时通常采用翻倍扩容,避免数据映射全部被打乱导致全量迁移的情况。
一致性哈希分区
一致性哈希分区,为系统中每个节点分配一个 token(或者缓存节点的 IP 地址或者主机名的 Hash 取值),范围一般在0~232,将整个 token 值空间组织成一个虚拟的圆环(哈希环)。数据读写执行节点查找操作时,先根据 key 计算 hash 值,然后顺时针找到第一个大于等于该哈希值的 token 节点,就是要访问的节点。。
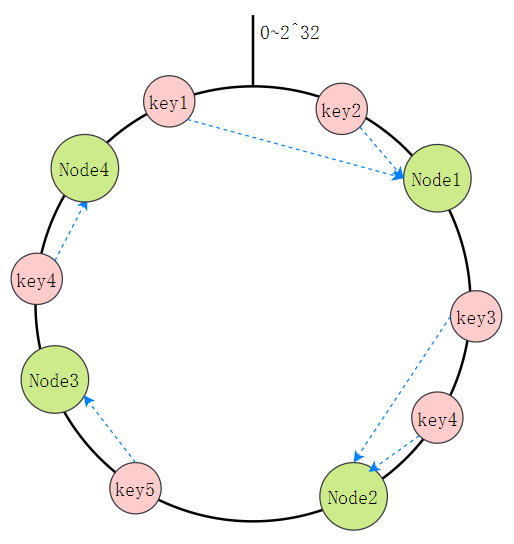
如上图,Key 1 和 Key 2 会落入到 Node 1 中,Key 3、Key 4 会落入到 Node 2 中,Key 5 落入到 Node 3 中,Key 6 落入到 Node 4 中。
这种方式相比节点取余最大的好处在于加入和删除节点只影响哈希环中相邻的节点,对其他节点无影响。但它还是存在以下问题:
- 缓存节点在圆环上分布不平均,会造成部分缓存节点的压力较大。
- 当某个节点故障时,这个节点所要承担的所有访问都会被顺移到另一个节点上,会对后面这个节点造成力。
虚拟槽分区
虚拟槽分区方案是在一致性哈希分区的基础上,引入了虚拟节点的概念。Redis Cluser 采用虚拟槽分区算法。其中的虚拟节点称为槽(slot),是介于数据和实际节点之间的虚拟概念。所有的键根据哈希函数映射到 0~16383 整数槽内,计算公式:slot=CRC16(key)&16383。每个实际节点负责维护一定数量的槽,每个槽包含哈希值在一定范围内的数据。
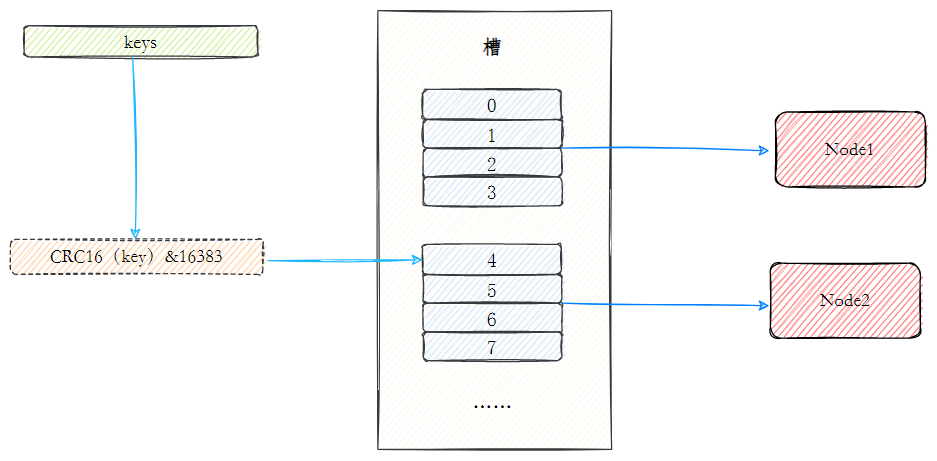
在使用了槽的一致性哈希分区中,槽是数据管理和迁移的基本单位。槽解耦了数据和实际节点 之间的关系,增加或删除节点对系统的影响很小。仍以上图为例,系统中有 4 个实际节点,假设为其分配 16 个槽(0-15);槽 0-3 位于 node1;4-7 位于 node2;以此类推...
如果此时删除 node2,只需要将槽 4-7 重新分配即可,例如槽 4-5 分配给 node1,槽 6 分配给 node3,槽 7 分配给 node4,数据在其他节点的分布仍然较为均衡。
Redis cluster 实现原理
Redis cluster 采用虚拟槽分区方式进行数据分区,实现数据的分布式存储,通过自动故障转移实现高可用。所有的键根据哈希函数映射到0~16383个整数槽内,每个节点负责维护一部分槽以及槽所映射的键值数据。
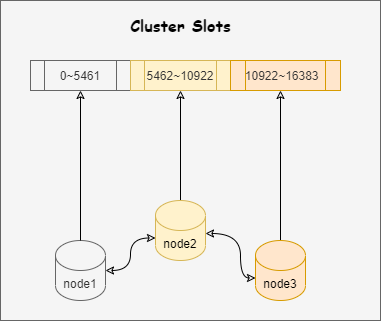
哈希槽是以过以下步骤,映射到 Redis 实例上:
- 对键值对的 key 使用
crc16算法计算一个结果 - 将结果对 16384 取余,得到的值表示 key 对应的哈希槽
- 根据该槽信息定位到对应的实例
集群创建
数据分区是在集群创建的时候完成的。
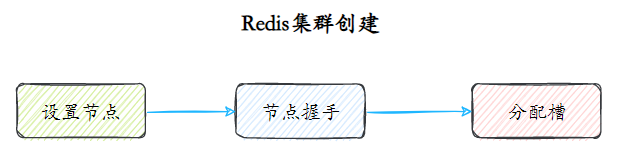
设置节点
Redis 集群一般由多个节点组成,节点数量至少为6个才能保证组成完整高可用的集群。每个节点需要开启配置 cluster-enabled yes,让 Redis 运行在集群模式下。
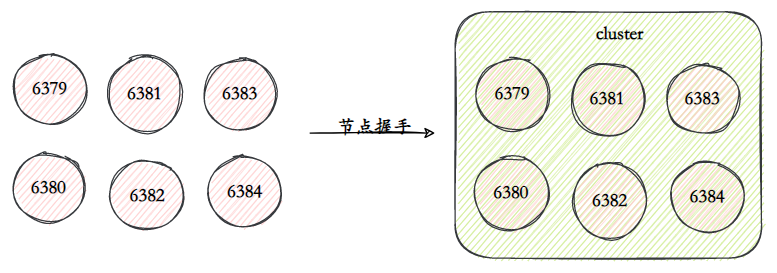
节点握手
节点握手是指一批运行在集群模式下的节点通过 Gossip 协议彼此通信,达到感知对方的过程。节点握手是集群彼此通信的第一步,由客户端发起命令:cluster meet{ip}{port}。完成节点握手之后,一个个的 Redis 节点就组成了一个多节点的集群。
分配槽(slot)
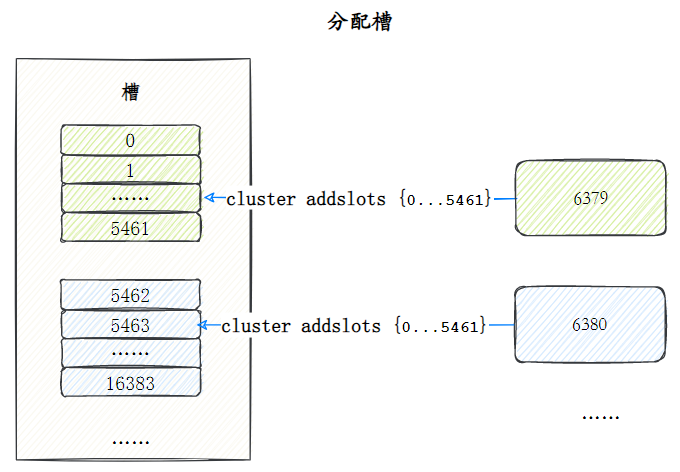
Redis 集群把所有的数据映射到 16384 个槽中。每个节点对应若干个槽,只有当节点分配了槽,才能响应和这些槽关联的键命令。通过 cluster addslots 命令为节点分配槽。
故障转移
Redis 集群的故障转移和哨兵的故障转移类似,但是 Redis 集群中所有的节点都要承担状态维护的任务。
故障发现
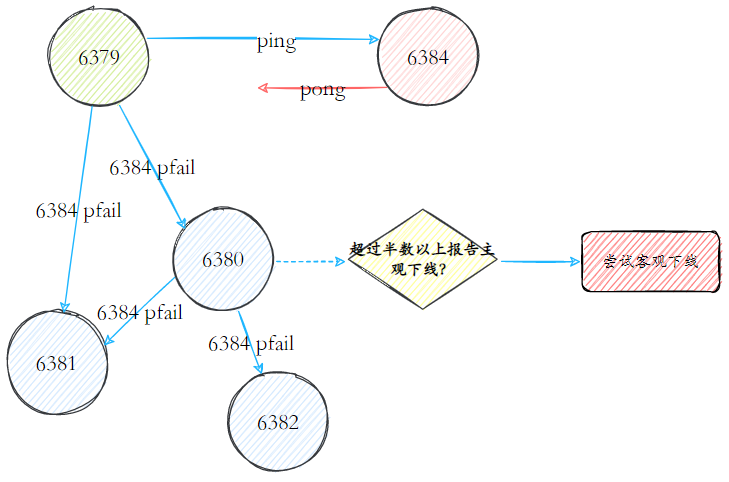
Redis 集群内节点通过 ping/pong 消息实现节点通信,集群中每个节点都会定期向其他节点发送 ping 消息,接收节点回复 pong 消息作为响应。如果在 cluster-node-timeout 时间内通信一直失败,则发送节点会认为接收节点存在故障,把接收节点标记为主观下线(pfail)状态。
当某个节点判断另一个节点主观下线后,相应的节点状态会跟随消息在集群内传播。通过 Gossip 消息传播,集群内节点不断收集到故障节点的下线报告。当半数以上持有槽的主节点都标记某个节点是主观下线时。触发客观下线流程。
故障恢复
故障节点变为客观下线后,如果下线节点是持有槽的主节点则需要在它的从节点中选出一个替换它,从而保证集群的高可用。
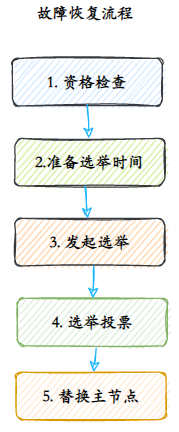
- 资格检查:每个从节点都要检查最后与主节点断线时间,判断是否有资格替换故障 的主节点。
- 准备选举时间:当从节点符合故障转移资格后,更新触发故障选举的时间,只有到达该 时间后才能执行后续流程。
- 发起选举:当从节点定时任务检测到达故障选举时间(
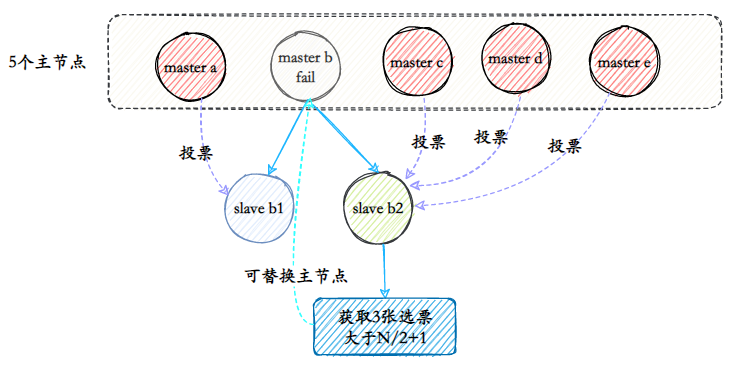
failover_auth_time)到达后,发起选举流程。 - 选举投票:持有槽的主节点处理故障选举消息。投票过程其实是一个领导者选举的过程,如集群内有 N 个持有槽的主节点代表有 N 张选票。由于在每个配置纪元内持有槽的主节点只能投票给一个从节点,因此只能有一个从节点获得
N/2+1的选票,保证能够找出唯一的从节点。
- 替换主节点:当从节点收集到足够的选票之后,触发替换主节点操作。
集群的伸缩
Redis 集群提供了灵活的节点扩容和收缩方案,可以在不影响集群对外服务的情况下,为集群添加节点进行扩容也可以下线部分节点进行缩容。
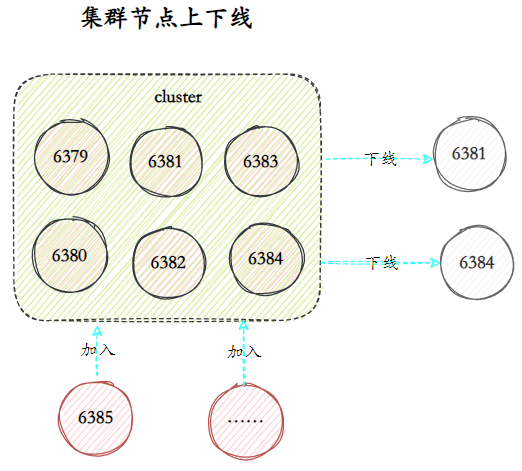
集群扩容和缩容的关键点,就在于槽和节点的对应关系,扩容和缩容就是将一部分槽和数据迁移给新节点。
例如下面一个集群,每个节点对应若干个槽,每个槽对应一定的数据,如果希望加入1个节点希望实现集群扩容时,需要通过相关命令把一部分槽和内容迁移给新节点。
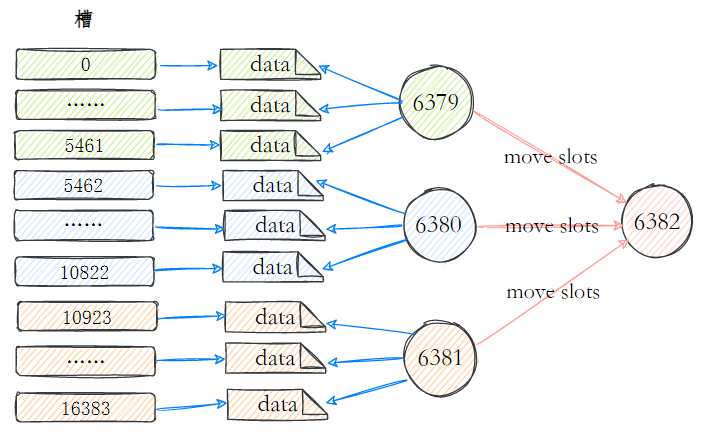
缩容也是类似,先把槽和数据迁移到其它节点,再把对应的节点下线。
Redis cluster 优劣分析
优点:
- 无中心架构,支持动态扩容。
- 数据按照 slot 存储分布在多个节点,节点间数据共享,可动态调整数据分布。
- 高可用性。部分节点不可用时,集群仍可用。集群模式能够实现自动故障转移(failover),节点之间通过 gossip 协议交换状态信息,用投票机制完成 Slave 到 Master 的角色转换。
缺点:
- 不支持批量操作(pipeline)。
- 数据通过异步复制,不保证数据的强一致性。
- 事务操作支持有限,只支持多 key 在同一节点上的事务操作,当多个 key 分布于不同的节点上时无法使用事务功能。
- key 作为数据分区的最小粒度,不能将一个很大的键值对象如 hash、list 等映射到不同的节点。
- 不支持多数据库空间,单机下的 Redis 可以支持到 16 个数据库,集群模式下只能使用 1 个数据库空间。
部署 Redis 集群需要物理节点的最少数量
在投票选举的环节,故障主节点也算在投票数内,假设集群内节点规模是3主3从,其中有 2 个主节点部署在一台机器上,当这台机器宕机时,由于从节点无法收集到 3/2+1 个主节点选票将导致故障转移失败。这个问题也适用于故障发现环节。因此部署集群时所有主节点最少需要部署在3台物理机上才能避免单点问题。
Redis 集群总结
Redis 的三种主流集群方案总结
Redis 有三种集群模式:主从模式、哨兵模式和集群模式。
Redis集群遵循如下原则:
- 所有 Redis 节点彼此都通过 PING-PONG 机制互联,内部使用二进制协议优化传输速度和带宽。
- 在集群中超过半数的节点检测到某个节点 Fail 后将该节点设置为 Fail 状态。
- 客户端与 Redis 节点直连,客户端连接集群中任何一个可用节点即可对集群进行操作。
- Redis-Cluster 把所有的物理节点都映射到 0~16383 的 slot(槽)上,Cluster 负责维护每个节点上数据槽的分配。Redis 的具体数据分配策略为:在 Redis 集群中内置了16384个散列槽;在需要在Redis集群中放置一个Key-Value时,Redis 会先对 Key 使用 CRC16 算法算出一个结果,然后把结果对 16384 求余数,这样每个Key都会对应一个编号为0~16383的散列槽;Redis 会根据节点的数量大致均等地将散列槽映射到不同的节点。
扩展:Redis 其他集群方案
- Twemproxy:它类似于一个代理方式,使用方法和普通 redis 无任何区别,设置好它下属的多个 redis 实例后,使用时在本需要连接 redis 的地方改为连接 twemproxy,它会以一个代理的身份接收请求并使用一致性 hash 算法,将请求转接到具体 redis,将结果再返回 twemproxy。使用方式简便(相对 redis 只需修改连接端口),对旧项目扩展的首选。但存在也有问题:twemproxy 自身单端口实例的压力,使用一致性 hash 后,对 redis 节点数量改变时候的计算值的改变,数据无法自动移动到新的节点。
- codis:目前用的最多的集群方案,基本和 twemproxy 一致的效果,但它支持在节点数量改变情况下,旧节点数据可恢复到新 hash 节点。
- 在业务代码层实现,对于几个毫无关联的 redis 实例,在代码层对 key 进行 hash 计算,然后去对应的 redis 实例操作数据。这种方式对 hash 层代码要求比较高,考虑部分包括,节点失效后的替代算法方案,数据震荡后的自动脚本恢复,实例的监控等等。
Twemproxy 概述
Twemproxy 是 Twitter 维护的(缓存)代理系统,代理 Memcached 的 ASCII 协议和 Redis 协议。它是单线程程序,使用 c 语言编写,运行起来非常快。它是采用 Apache 2.0 license 的开源软件。
Twemproxy 支持自动分区,如果其代理的其中一个 Redis 节点不可用时,会自动将该节点排除(这将改变原来的 keys-instances 的映射关系,所以应该仅在把 Redis 当缓存时使用 Twemproxy)。
Twemproxy 本身不存在单点问题,因为可以启动多个 Twemproxy 实例,然后让客户端去连接任意一个 Twemproxy 实例。Twemproxy 是 Redis 客户端和服务器端的一个中间层,由它来处理分区功能应该不算复杂,并且应该算比较可靠的。
Redis 图形化客户端
iredis 命令行工具
iredis,用 | 将 redis 通过 pipe 用 shell 的其他工具,比如 jq/fx/rg/sort/uniq/cut/sed/awk 等处理可以实现json格式化。还能自动补全,高亮显示,功能很多。
Redis Desktop Manager
Redis Desktop Manager,界面比较简洁,功能很全。key 的显示可以支持按冒号分割的键名空间,除了基本的五大数据类型之外,还支持 redis 5.0 新出的 Stream 数据类型。在 value 的显示方面。支持多达9种的数据显示方式。
最新官网(需要登陆):https://resp.app/
下载 redis-desktop-manager-0.9.2.806.exe,安装后启动redis客户端。【据说0.9.3(最后一个免费版本),待测试】
配置 redis 链接:选择连接到 Redis 服务器,配置主机地址与端口号
medis
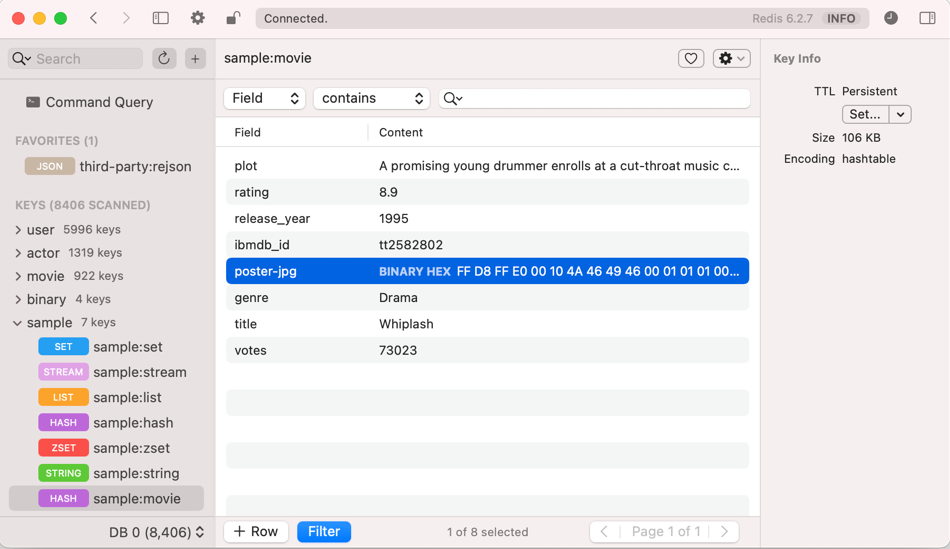
免费 redis 可视化工具,界面布局简洁,跨平台支持。对 key 有颜色鲜明的图标标识。在 key 的搜索上挺方便的,可以模糊搜索出匹配的 key,渐进式的 scan,无明显卡顿。在搜索的体验上还是比较出色的。
缺点是不支持 key 的命名空间展示,不支持 redis 5.0 的 stream 数据类型,命令行比较单一,不支持自动匹配和提示。支持的 value 的展现方式也只有3种
Another Redis Desktop Manager
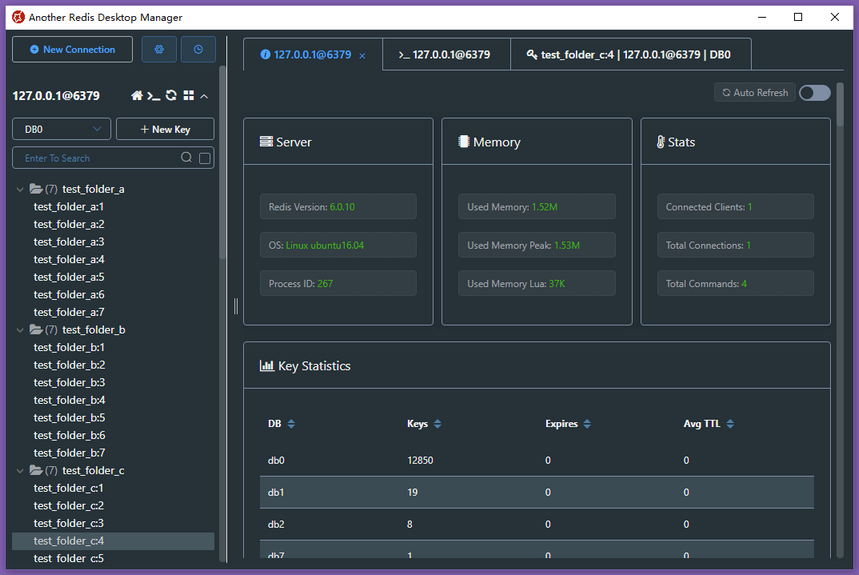
一款比较稳定简洁免费、更快、更好、更稳定的 Redis 桌面客户端工具,功能强大(个人认为是国产做的最好的 Redis 桌面客户端工具)。基于 Electron 实现,跨平台,界面美观。有监控统计,支持暗黑主题,还支持集群的添加。
缺点是没什么亮点,UI 很简单,不支持 stream 数据类型。命令行模式也比较单一。value 展示支持的类型也只有3种。
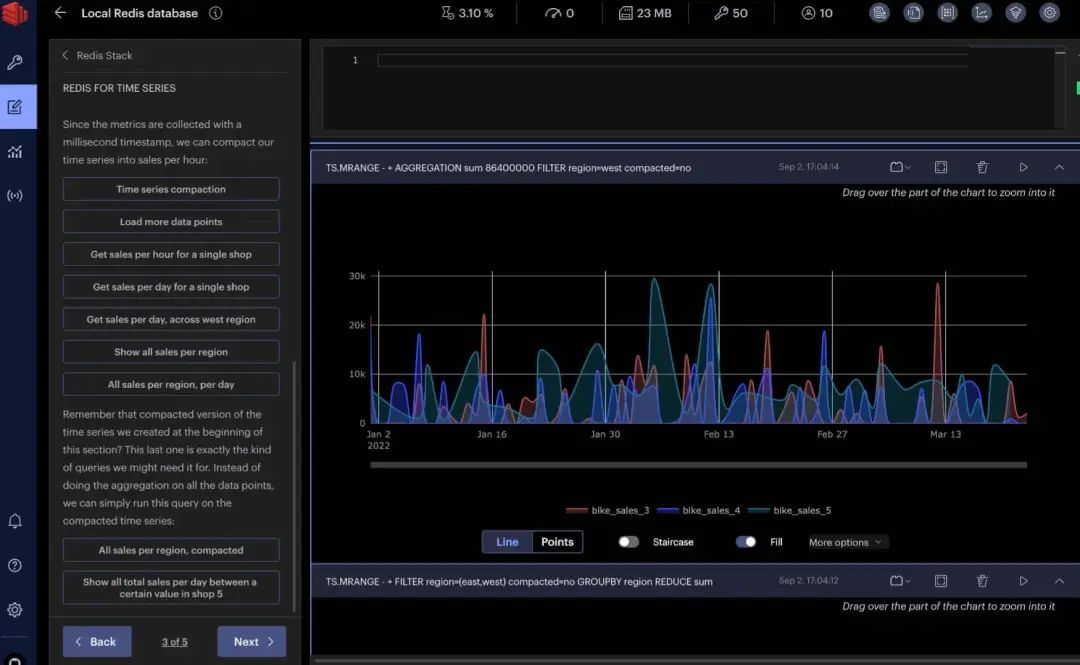
RedisInsight(官方)
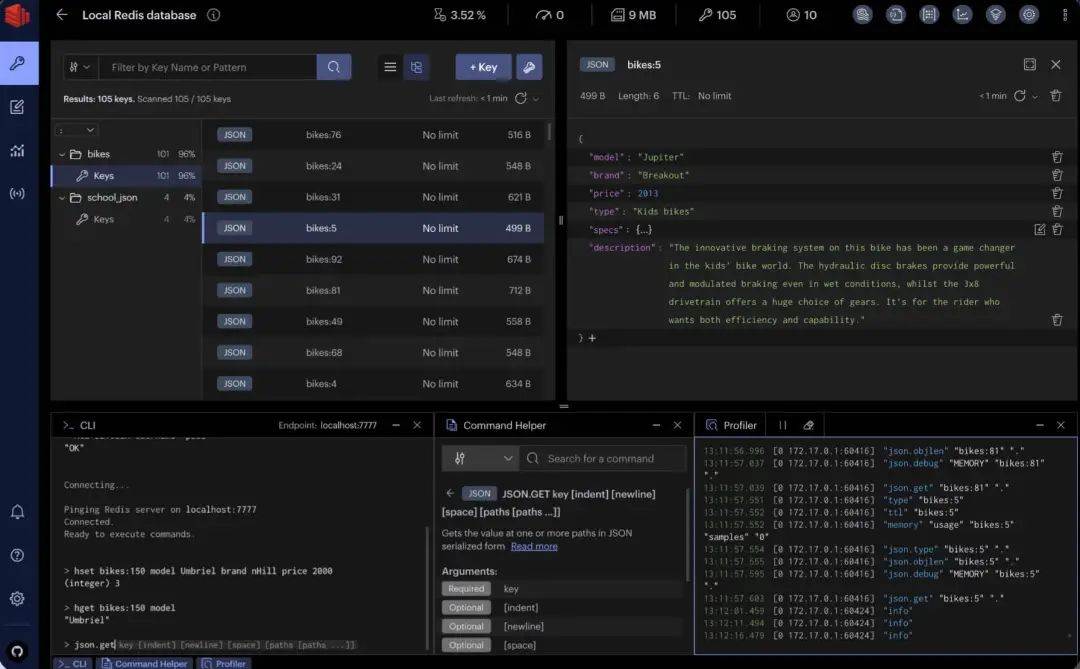
Redis 官方桌面客户端工具,根据官方介绍,RedisInsight 是 The best Redis GUI。可以对 Redis 的内存、连接数、命中率以及正常运行时间进行监控,并且可以在界面上使用 CLI 和连接的 Redis 进行交互(内置对 Redis 模块支持)。
基于 Electron 实现,跨平台,界面美观。唯一支持 Redis Cluster 的 GUI 工具。
效果预览:
相关地址:
- 项目地址:https://github.com/redisinsight/redisinsight
- 官网:https://redis.com/redis-enterprise/redis-insight/
- 官方文档:https://docs.redis.com/latest/ri/
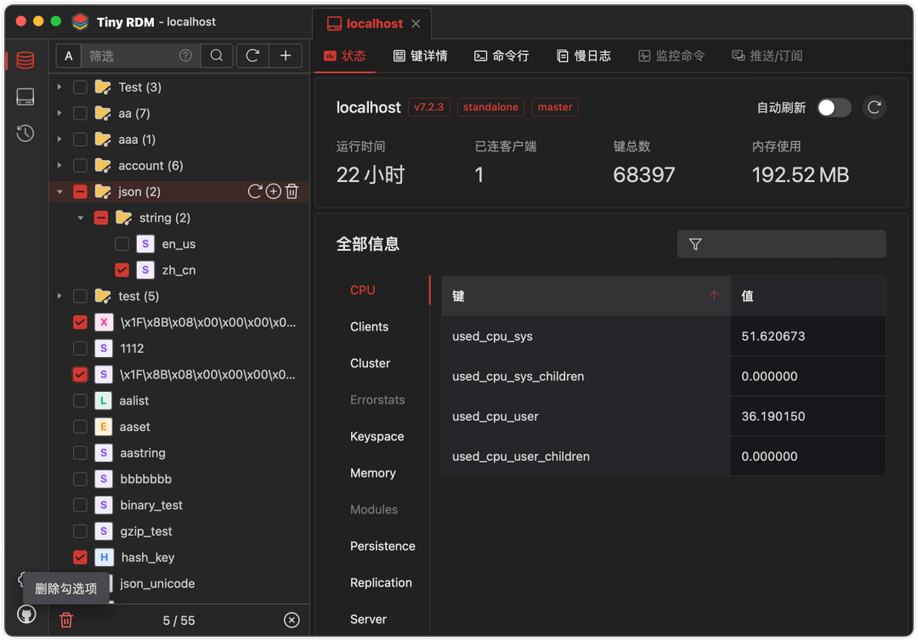
Tiny RDM
轻量级 Redis 桌面客户端工具,支持可视化键值操作、命令实时监控、数据导入导出等功能。基于 Webview2,无内嵌浏览器,跨平台,非常轻量,界面美观。
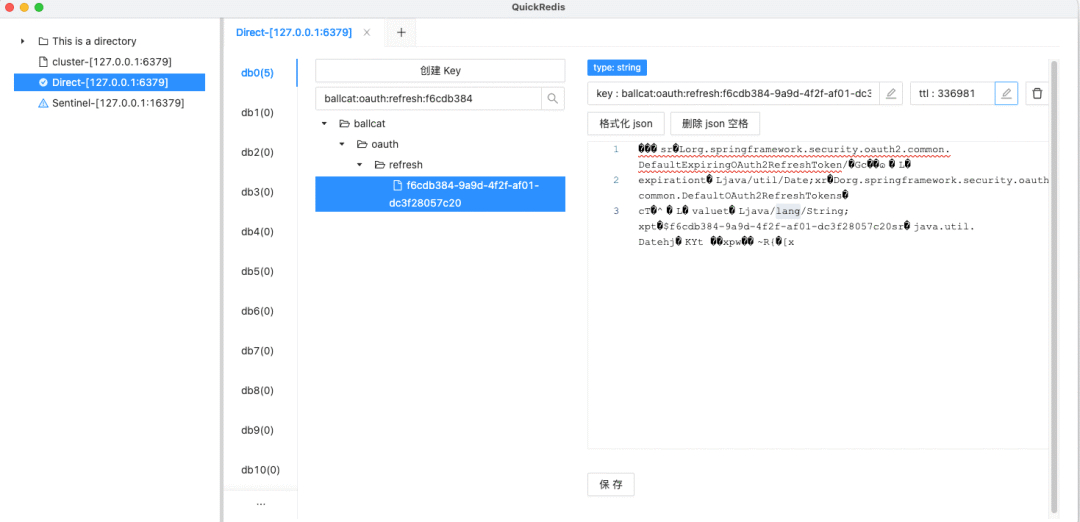
QuickRedis
基于 Electron 实现的 Redis 桌面客户端工具,跨平台,但内存占用较高。支持直连、哨兵、集群模式,支持亿万数量级的 key。
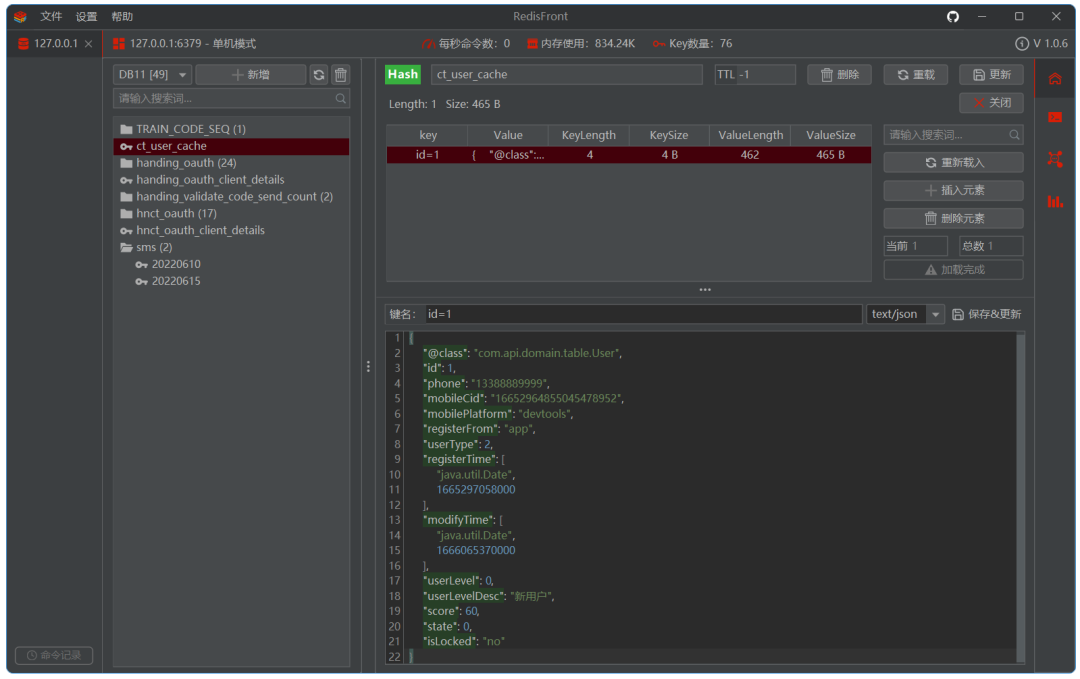
RedisFront
基于 Java Swing 开发的 Redis 桌面客户端工具,跨平台,但内存占用较高。支持单机模式,集群模式,哨兵模式以及 SSH 隧道连接。