Appearance
线程池简介
线程池的概念
线程池是 JDK 1.5 后的新特性,是用来创建和管理线程对象的容器。线程池做的工作主要是管理线程组,控制运行的线程的数量及其运行状态。
线程池主要特点是:线程复用、控制最大并发数、管理线程。
使用线程池的好处:
- 降低资源消耗:重用存在的线程的复用,避免频繁创建和销毁线程对象会带来过大的系统开销。
- 提高响应速度。可有效的控制最大并发线程数,提高系统资源的使用率,同时避免过多资源竞争,避免堵塞。当任务到达时,任务可以不需要的等到线程创建就能立即执行。
- 提高线程的可管理性。线程是稀缺资源,如果无限制的创建,不仅会消耗系统资源,还会降低系统的稳定性,使用线程池可以进行统一的分配,调优和监控。
- 附加功能:提供定时执行、定期执行、单线程、并发数控制等功能。
综上所述使用线程池框架 Executor 能更好的管理线程、提供系统资源使用率。
线程池的组成
一般的线程池主要分为以下 4 个组成部分:
- 线程池管理器:用于创建并管理线程池
- 工作线程:线程池中执行具体任务的线程
- 任务接口:每个任务必须实现的接口,用于工作线程调度和执行策略。注:只有线程实现了该接口,线程中的任务才能够被线程池调度。
- 任务队列:用于存放待处理的任务,提供一种缓冲机制。新的任务将会不断被加入队列中,执行完成的任务将被从队列中移除。
线程池的状态
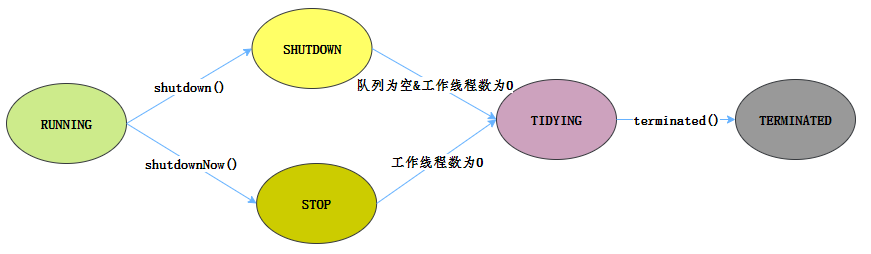
RUNNING:线程最正常的状态,接受新的任务,处理等待队列中的任务。SHUTDOWN:不接受新的任务提交,但是会继续处理等待队列中的任务。线程池处于 running 时调用shutdown方法,会进入该状态。STOP:不接受新的任务提交,不再处理等待队列中的任务,中断正在执行任务的线程。调用shutdownnow进入该状态。TIDYING:所有的任务都销毁了,workCount 为 0,线程池的状态在转换为TIDYING状态时,会执行钩子方法terminated()。ERMINATED:terminated()方法结束后,线程池的状态就会变成这个。
此状态定义在
ThreadPoolExecutor类中,详见后面《ThreadPoolExecutor》章节
Java 内置线程池体系
概述
JDK 中线程池框架主要涉及 Executor、ExecutorService、Callable 等接口和 Executors、ThreadPoolExecutor、Future、FutureTask 等类。
Executor框架是一个根据一组执行策略调用,调度,执行和控制的异步任务的框架Executors是一个工具类,提供不同方法按照相关的需求创建了不同的线程池ExecutorService接口继承了Executor接口并进行了扩展,提供了更多的方法能获得任务执行的状态并且可以获取任务的返回值。ThreadPoolExecutor创建自定义线程池的核心类Future表示异步计算的结果,他提供了检查计算是否完成的方法,以等待计算的完成,并可以使用get()方法获取计算的结果
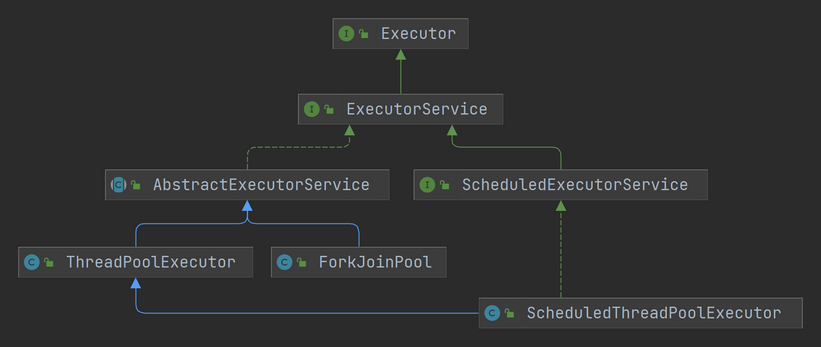
线程池相关类继承图
Executor 接口
Java 线程池的顶级接口是 java.util.concurrent.Executor,接口只定义了 execute 方法,主要目的是将 Runnable 任务与执行机制(线程,调度任务等)解耦,提供了执行 Runnable 任务的方法。从严格意义上讲 Executor 并不是一个线程池,而只是一个执行线程的框架,真正的线程池接口是 ExecutorService。
Executor 框架是根据一组执行策略调用,调度,执行和控制的异步任务的框架。无限制的创建线程会引起应用程序内存溢出,因此创建一个线程池来管理线程是个更好的的解决方案,因为可以限制线程的数量并且可以回收再利用这些线程。利用 Executors 框架可以非常方便的创建一个线程池。
java
/*
 * Executor接口的注释:
 * An object that executes submitted Runnable tasks. This interface provides a way of decoupling task submission from the mechanics of how each task will be run,
 * including details of thread use, scheduling, etc. An Executor is normally used instead of explicitly creating threads.
 */
public interface Executor {
    // 执行线程任务
    void execute(Runnable command);
}
ExecutorService 接口
java.util.concurrent.ExecutorService 接口是 java 内置的线程池接口(真正意义上),继承了 Executor 接口。
java
public interface ExecutorService extends Executor常用方法
java
void shutdown();- 启动一次顺序关闭,执行以前提交的任务,但不接受新任务。
java
List<Runnable> shutdownNow();- 停止所有正在执行的任务,暂停处理正在等待的任务,并返回等待执行的任务列表。
java
<T> Future<T> submit(Callable<T> task);- 执行带返回值的任务,返回一个
Future对象用于获取执行结果。
java
Future<?> submit(Runnable task);- 执行
Runnable任务,并返回一个表示该任务的Future。
java
<T> Future<T> submit(Runnable task, T result);- 执行
Runnable任务,并返回一个表示该任务的Future。
java
<T> List<Future<T>> invokeAll(Collection<? extends Callable<T>> tasks) throws InterruptedException;- 提交 tasks 中所有任务,并返回
Future对象集合
java
<T> List<Future<T>> invokeAll(Collection<? extends Callable<T>> tasks,
long timeout, TimeUnit unit) throws InterruptedException;- 提交 tasks 中所有任务,带超时时间
java
<T> T invokeAny(Collection<? extends Callable<T>> tasks)
throws InterruptedException, ExecutionException;- 提交 tasks 中所有任务,哪个任务先成功执行完毕,返回此任务执行结果,并取消其它任务
java
<T> T invokeAny(Collection<? extends Callable<T>> tasks,
                long timeout, TimeUnit unit)
throws InterruptedException, ExecutionException, TimeoutException;- 提交 tasks 中所有任务,哪个任务先成功执行完毕,返回此任务执行结果,并取消其它任务,带超时时间
java
boolean isShutdown();- 不在 RUNNING 状态的线程池,此方法就返回 true
java
boolean isTerminated();- 线程池状态是否为 TERMINATED
java
boolean awaitTermination(long timeout, TimeUnit unit) throws InterruptedException;- 调用
shutdown()方法后,由于调用线程并不会等待所有任务运行结束,因此如果它想在线程池 TERMINATED 状态后做些事情,可以利用此方法等待
常用方法使用示例
java
public class ExecutorServiceDemo {

    @Test
    public void shutdownTest() {
        // 使用工厂类获取线程池对象
        ExecutorService es = Executors.newSingleThreadExecutor();
        // 提交任务
        for (int i = 1; i <= 10; i++) {
            es.submit(new ExecutorServiceDemoRunnable(i));
        }
        // 关闭线程池,仅仅是不再接受新的任务,以前的任务还会继续执行
        es.shutdown();
        es.submit(new ExecutorServiceDemoRunnable(888)); // 不能再提交新的任务了
    }

    @Test
    public void shutdownNowTest() {
        // 使用工厂类获取线程池对象
        ExecutorService es = Executors.newSingleThreadExecutor();
        // 提交任务
        for (int i = 1; i <= 10; i++) {
            es.submit(new ExecutorServiceDemoRunnable(i));
        }
        // 立刻关闭线程池,如果线程池中还有缓存的任务,没有执行,则取消执行,并返回这些任务
        List<Runnable> runnables = es.shutdownNow();
        System.out.println(runnables);
    }
}

/**
 * 任务类,包含一个任务编号,在任务中,打印出是哪一个线程正在执行任务
 */
class ExecutorServiceDemoRunnable implements Runnable {
    private final int id;

    public ExecutorServiceDemoRunnable(int id) {
        this.id = id;
    }

    @Override
    public void run() {
        // 获取线程的名称并输出
        String name = Thread.currentThread().getName();
        System.out.println(name + "执行了任务..." + id);
    }

    @Override
    public String toString() {
        return "ExecutorServiceDemoRunnable{id=" + id + "}";
    }
}
java
@Slf4j
public class ExecutorServiceDemo {

    // submit 方法示例
    @Test
    public void submitTest() throws InterruptedException, ExecutionException {
        ExecutorService pool = Executors.newFixedThreadPool(1);
        Future<String> future = pool.submit(() -> {
            log.debug("running");
            Thread.sleep(1000);
            return "ok";
        });

        log.debug("{}", future.get());
    }

    // invokeAll 方法示例
    @Test
    public void invokeAllTest() throws InterruptedException {
        ExecutorService pool = Executors.newFixedThreadPool(1);
        List<Future<String>> futures = pool.invokeAll(Arrays.asList(
                () -> {
                    log.debug("begin");
                    Thread.sleep(1000);
                    return "1";
                },
                () -> {
                    log.debug("begin");
                    Thread.sleep(500);
                    return "2";
                },
                () -> {
                    log.debug("begin");
                    Thread.sleep(2000);
                    return "3";
                }
        ));

        futures.forEach(f -> {
            try {
                log.debug("{}", f.get());
            } catch (InterruptedException | ExecutionException e) {
                e.printStackTrace();
            }
        });
    }

    // invokeAny 方法示例
    @Test
    public void invokeAnyTest() throws InterruptedException, ExecutionException {
        ExecutorService pool = Executors.newFixedThreadPool(1);
        String result = pool.invokeAny(Arrays.asList(
                () -> {
                    log.debug("begin 1");
                    Thread.sleep(1000);
                    log.debug("end 1");
                    return "1";
                },
                () -> {
                    log.debug("begin 2");
                    Thread.sleep(500);
                    log.debug("end 2");
                    return "2";
                },
                () -> {
                    log.debug("begin 3");
                    Thread.sleep(2000);
                    log.debug("end 3");
                    return "3";
                }
        ));
        log.debug("{}", result);
    }

    // shutdown 方法示例
    @Test
    public void shutdownTest() throws InterruptedException {
        ExecutorService pool = Executors.newFixedThreadPool(2);

        Future<Integer> result1 = pool.submit(() -> {
            log.debug("task 1 running...");
            Thread.sleep(1000);
            log.debug("task 1 finish...");
            return 1;
        });

        Future<Integer> result2 = pool.submit(() -> {
            log.debug("task 2 running...");
            Thread.sleep(1000);
            log.debug("task 2 finish...");
            return 2;
        });

        Future<Integer> result3 = pool.submit(() -> {
            log.debug("task 3 running...");
            Thread.sleep(1000);
            log.debug("task 3 finish...");
            return 3;
        });

        log.debug("shutdown");
        pool.shutdown(); // 关闭后线程还能继续执行
        pool.awaitTermination(3, TimeUnit.SECONDS);
    }

    // shutdownNow 方法示例
    @Test
    public void shutdownNowTest() {
        ExecutorService pool = Executors.newFixedThreadPool(2);

        Future<Integer> result1 = pool.submit(() -> {
            log.debug("task 1 running...");
            Thread.sleep(1000);
            log.debug("task 1 finish...");
            return 1;
        });

        Future<Integer> result2 = pool.submit(() -> {
            log.debug("task 2 running...");
            Thread.sleep(1000);
            log.debug("task 2 finish...");
            return 2;
        });

        Future<Integer> result3 = pool.submit(() -> {
            log.debug("task 3 running...");
            Thread.sleep(1000);
            log.debug("task 3 finish...");
            return 3;
        });

        log.debug("shutdownNow");
        // 停止所有正在执行的任务,暂停处理正在等待的任务,并返回等待执行的任务列表。
        List<Runnable> runnables = pool.shutdownNow();
        log.debug("other.... {}", runnables);
    }
}
ScheduledExecutorService 接口
概述
java
public interface ScheduledExecutorService extends ExecutorServicejava.util.concurrent.ScheduledExecutorService 接口继承了 ExecutorService 接口,具备了延迟运行或定期执行任务的能力
常用方法
java
public <V> ScheduledFuture<V> schedule(Callable<V> callable, long delay, TimeUnit unit);- 延迟时间单位是 unit,数量是 delay 的时间后执行 Callable 接口的逻辑。
java
public ScheduledFuture<?> schedule(Runnable command, long delay, TimeUnit unit);- 延迟时间单位是 unit,数量是 delay 的时间后执行 Runnable 接口的逻辑。
java
public ScheduledFuture<?> scheduleAtFixedRate(Runnable command, long initialDelay, long period, TimeUnit unit);- 延迟时间单位是 unit,数量是 initialDelay 的时间后,每间隔 period 时间重复执行一次 Runnable 接口的逻辑。
java
public ScheduledFuture<?> scheduleWithFixedDelay(Runnable command, long initialDelay, long delay, TimeUnit unit);- 创建并执行一个在给定初始延迟后首次启用的定期操作,随后,在每一次执行终止和下一次执行开始之间都存在给定的延迟(delay)。
ThreadPoolExecutor
java
public class ThreadPoolExecutor extends AbstractExecutorServicejava.util.concurrent.ThreadPoolExecutor 是 JDK 提供的 ExecutorService 接口实现,继承了 AbstractExecutorService 抽象类。
构造方法与参数说明
ThreadPoolExecutor 类的构造方法及参数说明
java
public ThreadPoolExecutor(int corePoolSize, // 核心线程数(最多保留的线程数)
                          int maximumPoolSize, // 最大线程池大小,也就是线程池中线程的最大数量
                          long keepAliveTime, // 线程最大空闲(生存)时间,针对救急线程
                          TimeUnit unit, // 时间单位
                          BlockingQueue<Runnable> workQueue, // 线程等待(阻塞)队列
                          ThreadFactory threadFactory, // 线程创建工厂,主要用于线程创建时定义名称
                          RejectedExecutionHandler handler // 拒绝策略
                        )
可以通过配置不同的参数,创建出行为不同的线程池,以下是 ThreadPoolExecutor 构造函数的重要参数的详细说明:
int corePoolSize:线程池的核心线程数,线程数定义了最小可以同时运行的线程数量。当有新任务时,线程池中线程数没有达到此核心线程数的大小,则会创建新的线程来执行任务,否则会将任务放入阻塞队列。int maximumPoolSize:线程池允许存在的最大工作线程数。其中当线程数超过核心线程数之后,会创建数量为maximumPoolSize - corePoolSize的“救急线程”。这些非核心线程类似于临时借来的资源,在空闲时间超过 keepAliveTime 之后回收销毁,避免资源浪费。如果任务队列数超过此配置值,则根据拒绝策略处理新任务。long keepAliveTime:超过核心线程数时闲置线程的存活时间。即当线程池中的线程数量大于corePoolSize的时候,如果这时没有新的任务提交,核心线程外的线程(即“救急线程”)不会立即销毁,而是会等待,直到等待的时间超过了keepAliveTime配置的时间才会被回收销毁。若设置为0,表示多余的空闲线程会被立即终止。注意,此参数只对非核心线程有效。TimeUnit unit:keepAliveTime参数的时间单位TimeUnit.DAYSTimeUnit.HOURSTimeUnit.MINUTESTimeUnit.SECONDSTimeUnit.MILLISECONDSTimeUnit.MICROSECONDSTimeUnit.NANOSECONDS
BlockingQueue<Runnable> workQueue:任务执行前保存任务的队列,保存由execute方法提交的Runnable任务。当新任务来的时候会先判断当前运行的线程数量是否达到核心线程数,如果达到的话,任务就会被存放在队列中。ThreadFactory threadFactory:为线程池提供创建新线程的线程工厂。每当线程池创建一个新的线程时,都是通过线程工厂方法来完成的。RejectedExecutionHandler handler:线程池任务队列超过maximumPoolSize并且阻塞队列也满之后的拒绝策略。(拒绝策略详见下个章节)
拒绝(饱和)策略
如果当前同时运行的线程数量达到线程池中最大线程数量,并且阻塞队列也已经被放满了线程时,则说明线程池的线程资源已耗尽,线程池将没有足够的线程资源执行新的任务。ThreadPoolExecutor 定义一些拒绝策略来处理新添加的线程任务:
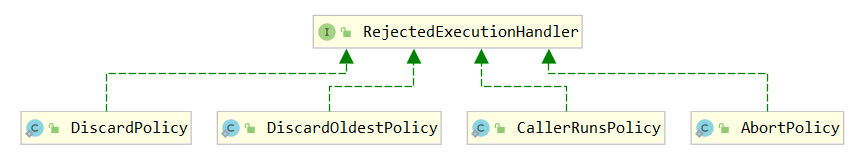
ThreadPoolExecutor.AbortPolicy:抛出RejectedExecutionException来拒绝新任务的处理,默认的策略。ThreadPoolExecutor.CallerRunsPolicy:调用执行自己的线程来运行任务,不会丢弃任务请求。但是这种策略会降低对于新任务提交速度,影响程序的整体性能。另外,此策略会增加队列容量。如果应用程序可以承受此延迟并且不能丢弃任何一个任务请求的话,可以选择这个策略。ThreadPoolExecutor.DiscardPolicy:不处理当前新任务,直接丢弃掉。ThreadPoolExecutor.DiscardOldestPolicy:此策略将丢弃线程队列中最早的未处理的任务请求,并尝试提交当前任务。
例如:Spring 通过 ThreadPoolTaskExecutor 或者直接通过 ThreadPoolExecutor 的构造函数创建线程池的时候,当不指定 RejectedExecutionHandler 饱和策略的话来配置线程池的时候默认使用的是 ThreadPoolExecutor.AbortPolicy。在默认情况下,ThreadPoolExecutor 将抛出 RejectedExecutionException 来拒绝新来的任务,这代表将丢失对这个任务的处理。对于可伸缩的应用程序,建议使用 ThreadPoolExecutor.CallerRunsPolicy。当最大池被填满时,此策略可以提供可伸缩队列。
自定义拒绝策略
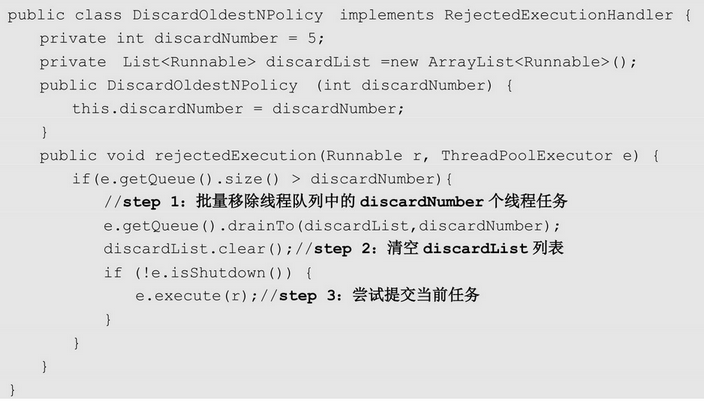
上面默认的拒绝策略均实现了 RejectedExecutionHandler 接口,若无法满足实际需要,可以自行扩展 RejectedExecutionHandler 接口来实现拒绝策略,并捕获异常来实现自定义拒绝策略。
以下示例实现一个自定义拒绝策略 DiscardOldestNPolicy,该策略根据传入的参数丢弃最老的 N 个线程,以便在出现异常时释放更多的资源。具体参考代码如下:
线程池大小设置最佳实践
如果设置线程池线程数量太小,当有大量请求需要处理,系统响应比较慢,会影响用户体验,甚至会出现任务队列大量堆积任务导致 OOM;如果设置线程池线程数量过大,大量线程可能会同时抢占 CPU 资源,这样会导致大量的上下文切换,从而增加线程的执行时间,影响了执行效率。一般根据不同情况进行不同设置:
- 高并发、任务执行时间短的业务:这类情况,线程池线程数可以设置为
CPU核数+1,减少线程上下文的切换。 - 并发不高、任务执行时间长的业务,这类需要区分不同的情况:
- CPU 密集型任务(N+1):这种任务消耗的主要是 CPU 资源,可以将线程数设置为
CPU核心数+1,多出来的一个线程是为了防止某些原因导致的线程阻塞(如 IO 操作,线程 sleep,等待锁)而带来的影响。一旦某个线程被阻塞,释放了 CPU 资源,而在这种情况下多出来的一个线程就可以充分利用 CPU 的空闲时间。 - I/O 密集型任务(2N):系统的大部分时间都在处理 IO 操作,此时线程可能会被阻塞,释放 CPU 资源,这时就可以将 CPU 交出给其它线程使用。因此在 IO 密集型任务的应用中,可以多配置一些线程,让 CPU 处理更多的业务。具体的计算方法如下,一般也可设置为 2N。
最佳线程数 = CPU核心数 * (1/CPU利用率) = CPU核心数 * (1 + (IO耗时/CPU耗时))- 并发高、业务执行时间长的情况:解决这种类型任务的关键不在于线程池而在于整体架构的设计,评估一下业务中涉及的某些数据是否可以缓存使用、是否需要增加服务器、是否需要使用中间件来进行异步解耦等等。
线程池状态的定义
源码
在 ThreadPoolExecutor 类中定义了线程池的几个状态:RUNNING, SHUTDOWN, STOP, TIDYING, TERMINATED。
java
private static final int RUNNING    = -1 << COUNT_BITS;
private static final int SHUTDOWN   =  0 << COUNT_BITS;
private static final int STOP       =  1 << COUNT_BITS;
private static final int TIDYING    =  2 << COUNT_BITS;
private static final int TERMINATED =  3 << COUNT_BITS;
源码使用 int 的高 3 位来表示线程池状态,低 29 位表示线程数量。
| 状态名 | 高 3 位 | 接收新任务 | 处理阻塞队列任务 | 说明 |
|---|---|---|---|---|
| RUNNING | 111 | Y | Y | |
| SHUTDOWN | 000 | N | Y | 不会接收新任务,但会处理阻塞队列剩余任务 |
| STOP | 001 | N | N | 会中断正在执行的任务,并抛弃阻塞队列任务 |
| TIDYING | 010 | - | - | 任务全执行完毕,活动线程为 0 即将进入终结 |
| TERMINATED | 011 | - | - | 终结状态 |
从数字上比较,TERMINATED > TIDYING > STOP > SHUTDOWN > RUNNING。这些信息存储在一个原子变量 ctl 中,目的是将线程池状态与线程个数合二为一,这样就可以用一次 cas 原子操作进行赋值
java
// rs 为高 3 位代表线程池状态, wc 为低 29 位代表线程个数,ctl 是合并它们
private static int ctlOf(int rs, int wc) { return rs | wc; }

private void advanceRunState(int targetState) {
    for (;;) {
        int c = ctl.get();
        if (runStateAtLeast(c, targetState) ||
            // c 为旧值, ctlOf 返回结果为新值
            ctl.compareAndSet(c, ctlOf(targetState, workerCountOf(c))))
            break;
    }
}
线程池各个状态切换图
RUNNING
- 该状态的线程池会接收新任务,并处理阻塞队列中的任务。
- 调用线程池的 shutdown() 方法,可以切换到 SHUTDOWN 状态。
- 调用线程池的 shutdownNow() 方法,可以切换到 STOP 状态。
SHUTDOWN
- 该状态的线程池不会接收新任务,但会处理阻塞队列中的任务。
- 队列为空,并且线程池中执行的任务也为空,进入 TIDYING 状态。
STOP
- 该状态的线程不会接收新任务,也不会处理阻塞队列中的任务,而且会中断正在运行的任务。
- 线程池中执行的任务为空,进入 TIDYING 状态。
TIDYING
- 该状态表明所有的任务已经运行终止,记录的任务数量为0。
- terminated() 执行完毕,进入 TERMINATED 状态。
TERMINATED
- 该状态表示线程池彻底终止
ScheduledThreadPoolExecutor
概述
ScheduledThreadPoolExecutor 继承自 ThreadPoolExecutor,为任务提供延迟或周期执行,属于线程池的一种。
java
public class ScheduledThreadPoolExecutor extends ThreadPoolExecutor implements ScheduledExecutorService {
    // 省略...
    private class ScheduledFutureTask<V>
            extends FutureTask<V> implements RunnableScheduledFuture<V> {
        // 省略...
    }
    static class DelayedWorkQueue extends AbstractQueue<Runnable> implements BlockingQueue<Runnable> {
        // 省略...
    }
}
ScheduledThreadPoolExecutor 内部构造了两个内部类:
ScheduledFutureTask:继承了FutureTask,是一个异步运算任务。最上层分别实现了Runnable、Future、Delayed接口,说明它是一个可以延迟执行的异步运算任务。DelayedworkQueue:是ScheduledThreadPoolExecutor为存储周期或延迟任务专门定义的一个延迟队列,继承了AbstractQueue,为了契合ThreadPoolExecutor也实现了BlockingQueue接口。与DelayQueue的不同之处就是,它内部只允许存储RunnableScheduledFuture类型的任务对象,并且自己实现了二叉堆(DelayQueue是利用了PriorityQueue的二叉堆结构)。
和 ThreadPoolExecutor 相比,它具有以下几种特性:
- 使用专门的任务类型
ScheduledFutureTask来执行周期任务,也可以接收不需要时间调度的任务(这些任务通过ExecutorService来执行)。 - 使用专门的存储队列
DelayedWorkQueue(是无界延迟队列DelayQueue的一种)来存储任务。相比ThreadPoolExecutor也简化了执行机制(delayedExecute方法)。 - 支持可选的
run-after-shutdown参数,在池被关闭(shutdown)之后支持可选的逻辑来决定是否继续运行周期或延迟任务,且当任务(重新)提交操作与 shutdown 操作重叠时,复查逻辑也不相同。
类继承图
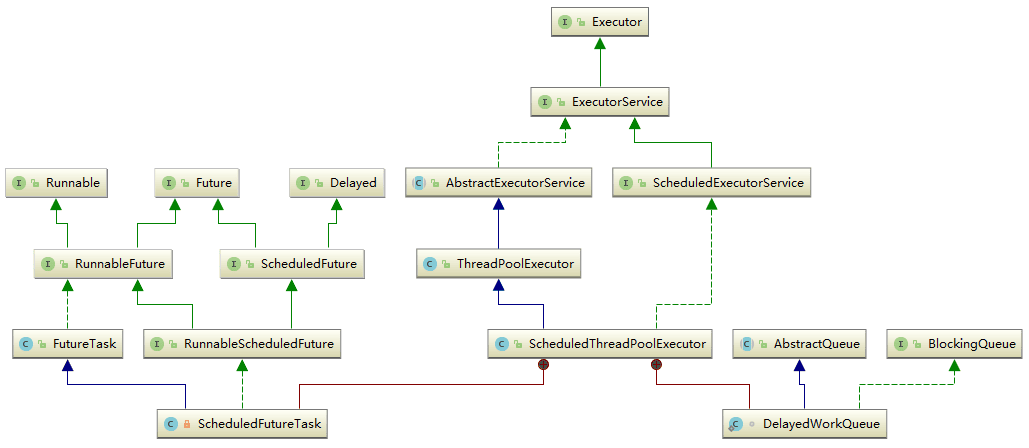
为什么 ThreadPoolExecutor 的调整策略不适用于 ScheduledThreadPoolExecutor
由于 ScheduledThreadPoolExecutor 是一个固定核心线程数大小的线程池,并且使用了一个无界队列,所以调整 maximumPoolSize 对其没有任何影响(因为 ScheduledThreadPoolExecutor 没有提供可以调整最大线程数的构造函数,默认最大线程数固定为 Integer.MAX_VALUE)。此外设置 corePoolSize 为 0 或者设置核心线程空闲后清除(allowCoreThreadTimeOut)同样也不是一个好的策略,因为一旦周期任务到达某一次运行周期时,可能导致线程池内没有线程去处理这些任务。
ForkJoinPool
java
public class ForkJoinPool extends AbstractExecutorServicejava.util.concurrent.ForkJoinPool 继承 AbstractExecutorService,Fork 将大任务分叉为多个小任务,然后让小任务执行,Join 是获得小任务的结果,类似于 map reduce。
线程池小结
提交任务的 execute 与 submit 方法的区别
execute() 方法是定义在 Executor 接口中,方法接收一个 Runnable 实例,它用来执行一个任务
java
public void execute(Runnable runnable);而 submit() 方法是定义在 ExecutorService 接口中,该方法返回的是 Future 对象。可以用 isDone() 来查询 Future 是否已经完成,当任务完成时,它具有一个结果,可以调用 get() 来获取结果。也可以不用 isDone() 进行检查就直接调用 get(),在这种情况下,get() 将阻塞,直至结果准备就绪。
java
public Future<?> submit(Runnable task);
public <T> Future<T> submit(Runnable task, T result);
public <T> Future<T> submit(Callable<T> task);
submit() 和 execute() 两个方法都可以向线程池提交任务。主要区别如下:
- 方法返回值不同:
execute()方法的返回类型是 void;而submit()方法的返回类型是持有计算结果的Future对象。 - 方法定义的位置不同:
execute()方法的是定义在Executor接口中;而submit()方法是定义在ExecutorService接口中(它扩展了Executor接口)。
关闭线程池的 shutdown 与 shutdownNow 方法的区别
在 ExecutorService 接口提供了两个关闭线程池的方法,其区别如下:
shutdown():将线程池状态变为 SHUTDOWN,不会接收新任务,但会将已提交的任务执行完成。此方法不会阻塞调用线程的执行。shutdownNow():将线程池状态变为 STOP,不会接收新任务,会将队列中的任务返回,并用interrupt的方式中断正在执行的任务
ThreadPoolExecutor 源码实现分析:
java
/**
 * 线程池状态变为 SHUTDOWN
 * 不会接收新任务,但已提交任务会执行完,此方法不会阻塞调用线程的执行
 */
public void shutdown() {
    final ReentrantLock mainLock = this.mainLock;
    mainLock.lock();
    try {
        checkShutdownAccess();
        // 修改线程池状态
        advanceRunState(SHUTDOWN);
        // 仅会打断空闲线程
        interruptIdleWorkers();
        onShutdown(); // hook for ScheduledThreadPoolExecutor (扩展点)
    } finally {
        mainLock.unlock();
    }
    // 尝试终结(没有运行的线程可以立刻终结,如果还有运行的线程也不会等)
    tryTerminate();
}

/**
 * 线程池状态变为 STOP
 * 不会接收新任务,会将队列中的任务返回,并用 interrupt 的方式中断正在执行的任务
 */
public List<Runnable> shutdownNow() {
    List<Runnable> tasks;
    final ReentrantLock mainLock = this.mainLock;
    mainLock.lock();
    try {
        checkShutdownAccess();
        // 修改线程池状态
        advanceRunState(STOP);
        // 打断所有线程
        interruptWorkers();
        // 获取队列中剩余任务
        tasks = drainQueue();
    } finally {
        mainLock.unlock();
    }
    // 尝试终结
    tryTerminate();
    return tasks;
}
Executors 工具类创建各种类型的线程池
JDK 提供了用于创建线程池的工具类 Executors,类中提供了一系列静态工厂方法,用来创建各种不同类型的线程池(本质是使用 ThreadPoolExecutor 构造方法创建 ExecutorService 实现对象,区别只是设置不同的参数)。
引用《阿里巴巴 Java 开发手册》中关于线程池的内容:
【强制】线程池不允许使用
Executors去创建,而是通过ThreadPoolExecutor的方式,这样的处理方式让写的同学更加明确线程池的运行规则,规避资源耗尽的风险。说明:Executors返回的线程池对象的弊端如下:
FixedThreadPool和SingleThreadPool:允许的请求队列长度为Integer.MAX_VALUE,可能会堆积大量的请求,从而导致 OOMCachedThreadPool:允许的创建线程数量为Integer.MAX_VALUE,可能会创建大量的线程,从而导致 OOM
newCachedThreadPool
java
public class Executors {
    // 创建一个默认的线程池对象,里面的线程可重用,且在第一次使用时才创建
    public static ExecutorService newCachedThreadPool() {
        return new ThreadPoolExecutor(0, Integer.MAX_VALUE,
                                      60L, TimeUnit.SECONDS,
                                      new SynchronousQueue<Runnable>());
    }

    // 线程池中的所有线程都使用 ThreadFactory 来创建,这样的线程无需手动启动,自动执行
    public static ExecutorService newCachedThreadPool(ThreadFactory threadFactory) {
        return new ThreadPoolExecutor(0, Integer.MAX_VALUE,
                                      60L, TimeUnit.SECONDS,
                                      new SynchronousQueue<Runnable>(),
                                      threadFactory);
    }
    // ...省略
}
newCachedThreadPool 用于创建一个缓存线程池,使用没有容量的 SynchronousQueue 作为线程池工作队列。核心线程数是 0,最大线程数是 Integer.MAX_VALUE,空闲生存时间默认是 60s,意味着线程池全部的线程都是“救急线程”,可以无限被创建。因此极端情况下,这样会导致耗尽 cpu 和内存资源。
调用 execute 创建新线程时,如果有可用线程,则重用以前构造的线程;如果现有线程没有可用的,则创建一个新线程并添加到池中,终止并从缓存中移除那些(keepAliveTime)超过默认的 60 秒未被使用的线程。因此长时间保持空闲的线程池不会占用任何资源。
CachedThreadPool 执行流程:
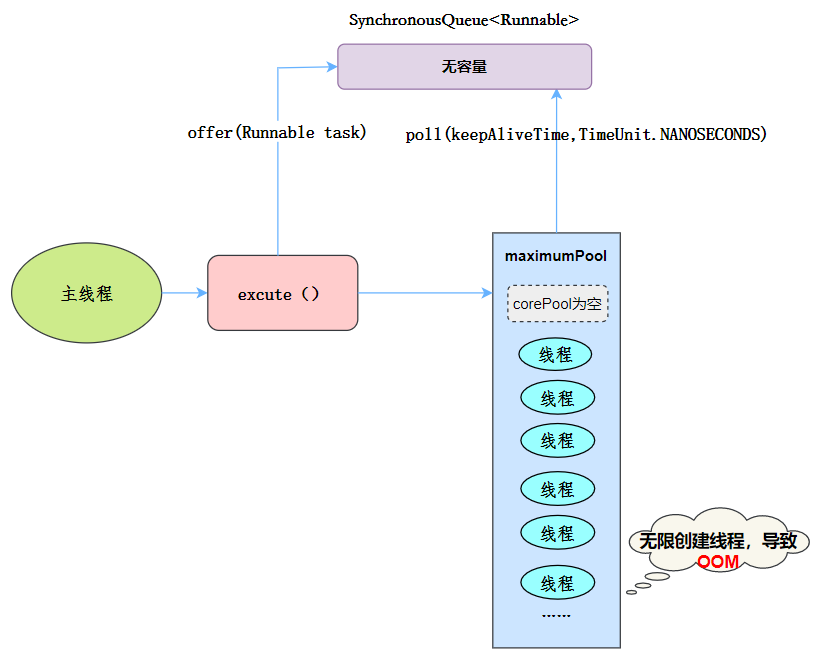
一般在创建线程时需要执行申请 CPU 和内存、记录线程状态、控制阻塞等多项工作,复杂且耗时。对于执行很多短期异步任务的程序而言,这种线程池很大程度地重用线程,从而提高程序性能。
适用场景:整个线程池表现为线程数会根据任务量不断增长,没有上限,当任务执行完毕,空闲1分钟后释放线程。适合并发执行任务数比较密集,但每个任务执行时间较短的情况。
newFixedThreadPool
java
public class Executors {
    // 创建一个可重用固定线程数的线程池
    public static ExecutorService newFixedThreadPool(int nThreads) {
        return new ThreadPoolExecutor(nThreads, nThreads,
                                      0L, TimeUnit.MILLISECONDS,
                                      new LinkedBlockingQueue<Runnable>());
    }

    // 创建一个可重用固定线程数的线程池且线程池中的所有线程都使用 ThreadFactory 来创建
    public static ExecutorService newFixedThreadPool(int nThreads, ThreadFactory threadFactory) {
        return new ThreadPoolExecutor(nThreads, nThreads,
                                      0L, TimeUnit.MILLISECONDS,
                                      new LinkedBlockingQueue<Runnable>(),
                                      threadFactory);
    }
    // ...省略
}
newFixedThreadPool 用于创建一个可重用固定线程数量的线程池,并将线程资源存放在共享的无界队列(LinkedBlockingQueue,队列容量为 Integer.MAX_VALUE)中循环使用。运行中的线程池不会拒绝任务,即不会调用 RejectedExecutionHandler.rejectedExecution() 方法。需要注意的是,FixedThreadPool 不会拒绝任务,在任务比较多的时候会导致 OOM。使用 ThreadPoolExecutor 构造函数参数说明如下:
maxThreadPoolSize是无效参数,故将它的值设置为与coreThreadPoolSize一致。keepAliveTime也是无效参数,用于设置多余的空闲线程等待新任务的最大时间,超过此时间后多余的线程将被终止。设置为0L,表示多余的空闲线程会立即终止。因为此线程池里所有线程都是核心线程,核心线程不会被回收(除非设置了executor.allowCoreThreadTimeOut(true))。
FixedThreadPool 执行流程:
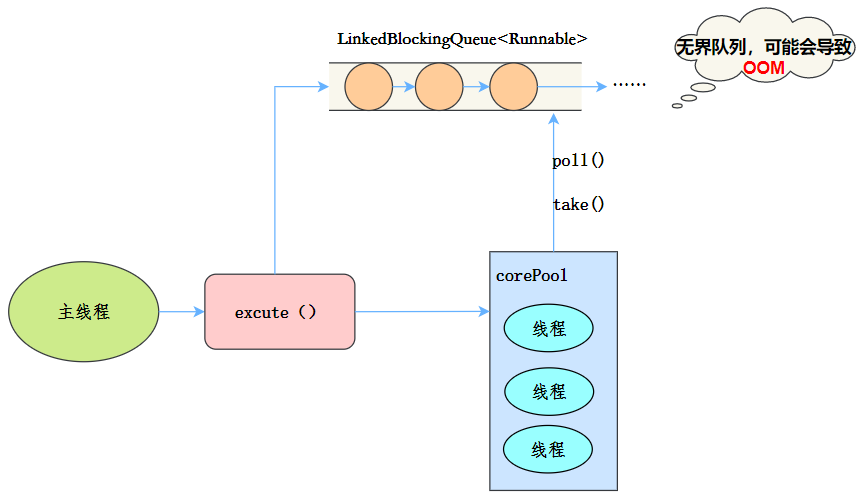
在任意点,在大多数 nThreads 线程会处于处理任务的活动状态。如果在所有线程处于活动状态时提交新任务,则在有可用线程之前,新任务将在队列中等待,直到有可用的线程资源;如果在关闭前的执行期间由于失败而导致任何线程终止,那么一个新线程将代替它执行后续的任务(如果需要)。在某个线程被显式地关闭之前,池中的线程将一直存在。
java
@Test
public void testNewFixedThreadPool() throws InterruptedException {
    ExecutorService pool = Executors.newFixedThreadPool(2, new ThreadFactory() {
        private AtomicInteger t = new AtomicInteger(1);

        @Override
        public Thread newThread(Runnable r) {
            return new Thread(r, "mypool_t" + t.getAndIncrement());
        }
    });

    pool.execute(() -> log.debug("1"));
    pool.execute(() -> log.debug("2"));
    pool.execute(() -> log.debug("3"));
    Thread.sleep(2000);
}
适用场景:适用于处理 CPU 密集型相对耗时的任务,任务数量已知,确保 CPU 在长期被工作线程使用的情况下,尽可能的少的分配线程,即适用执行长期的任务。
newSingleThreadExecutor
java
public class Executors {
    // 创建一个使用单个 worker 线程的 Executor,以无界队列方式来运行该线程
    public static ExecutorService newSingleThreadExecutor() {
        return new FinalizableDelegatedExecutorService
            (new ThreadPoolExecutor(1, 1,
                                    0L, TimeUnit.MILLISECONDS,
                                    new LinkedBlockingQueue<Runnable>()));
    }

    // 创建一个使用单个 worker 线程的 Executor,且线程池中的所有线程都使用 ThreadFactory 来创建
    public static ExecutorService newSingleThreadExecutor(ThreadFactory threadFactory) {
        return new FinalizableDelegatedExecutorService
            (new ThreadPoolExecutor(1, 1,
                                    0L, TimeUnit.MILLISECONDS,
                                    new LinkedBlockingQueue<Runnable>(),
                                    threadFactory));
    }
    // ...省略
}
newSingleThreadExecutor 创建一个保证永远有且只有一个可用线程的线程池(使用无界队列 LinkedBlockingQueue),此线程池保证所有任务的执行顺序按照任务的提交顺序执行。相比于手动创建的线程,会由于任务的失败或异常而终止;而这个线程池可以在线程死后(或发生异常时)重新启动一个线程来替代原来的线程继续执行下去!值得注意的是:在任务比较多的时候也是会导致 OOM。
SingleThreadExecutor 运行流程:
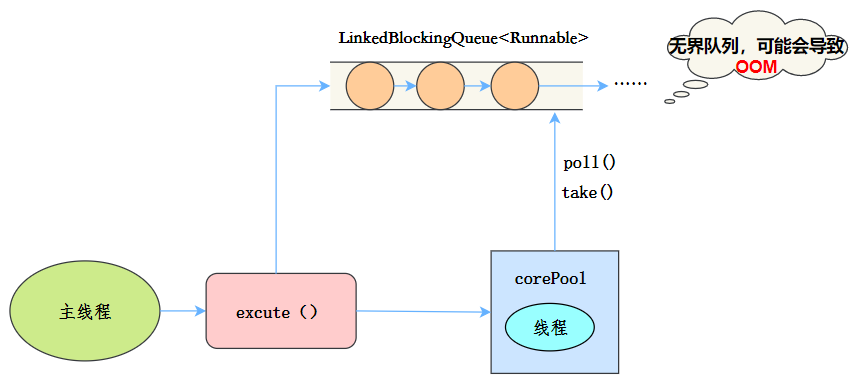
newSingleThreadExecutor 与 newFixedThreadPool 的区别:
Executors.newSingleThreadExecutor()线程个数始终为1,不能修改。其中FinalizableDelegatedExecutorService应用的是装饰器模式,只对外暴露了ExecutorService接口,因此不能调用ThreadPoolExecutor类中特有的方法Executors.newFixedThreadPool(1)初始时为1,后续可以进行修改,对外暴露的是ThreadPoolExecutor对象,可以强转后调用setCorePoolSize等方法进行修改。
java
@Test
public void testNewSingleThreadExecutor() throws InterruptedException {
    ExecutorService pool = Executors.newSingleThreadExecutor();
    pool.execute(() -> {
        log.debug("1");
        int i = 1 / 0; // 模拟异常导致线程终止,线程池会创建新线程,保证池的正常工作
    });

    pool.execute(() -> log.debug("2"));
    pool.execute(() -> log.debug("3"));
    Thread.sleep(2000);
}适用场景:适用于串行执行多个任务的场景。
newScheduledThreadPool
概述
java
public class Executors {
    // 创建一个可重用固定线程数的线程池且允许延迟运行或定期执行任务
    public static ScheduledExecutorService newScheduledThreadPool(int corePoolSize) {
        return new ScheduledThreadPoolExecutor(corePoolSize);
    }

    // 创建一个可重用固定线程数的线程池且线程池中的所有线程都使用 ThreadFactory 来创建,且允许延迟运行或定期执行
    public static ScheduledExecutorService newScheduledThreadPool(
            int corePoolSize, ThreadFactory threadFactory) {
        return new ScheduledThreadPoolExecutor(corePoolSize, threadFactory);
    }

    // 创建一个单线程执行程序,它允许在给定延迟后运行命令或者定期地执行
    public static ScheduledExecutorService newSingleThreadScheduledExecutor() {
        return new DelegatedScheduledExecutorService
            (new ScheduledThreadPoolExecutor(1));
    }

    // 创建一个单线程执行程序,它可安排在给定延迟后运行命令或者定期地执行
    public static ScheduledExecutorService newSingleThreadScheduledExecutor(ThreadFactory threadFactory) {
        return new DelegatedScheduledExecutorService
            (new ScheduledThreadPoolExecutor(1, threadFactory));
    }
    // ...省略
}
newScheduledThreadPool 创建了一个可定时调度,核心线程池固定,大小无限的线程池实现:ScheduledExecutorService。此线程池支持设置在给定的延迟时间后执行或者周期性执行某个线程任务。如果闲置,非核心线程池会在 DEFAULT_KEEPALIVEMILLIS 时间内回收。
ScheduledThreadPool 执行流程:
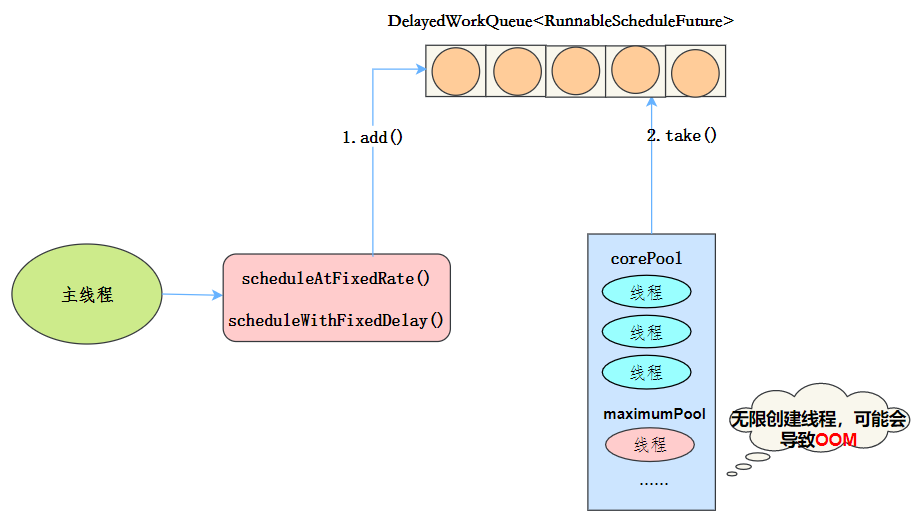
适用场景:此类型线程池的特点是线程数固定,任务数多于线程数时,会放入无界队列排队;任务执行完毕,这些线程也不会被释放。用于执行延迟或周期性执行,并且限制线程数量的场景。在实际项目中基本不会被用到,因为有更好的其他方案选择,比如 quartz。
基础示例
java
ScheduledExecutorService scheduledThreadPool= Executors.newScheduledThreadPool(3);

scheduledThreadPool.schedule(newRunnable(){
    @Override
    public void run() {
        System.out.println("延迟三秒");
    }
}, 3, TimeUnit.SECONDS);

scheduledThreadPool.scheduleAtFixedRate(newRunnable(){
    @Override
    public void run() {
        System.out.println("延迟 1 秒后每三秒执行一次");
    }
}, 1, 3, TimeUnit.SECONDS);
Timer 实现任务调度线程池
在『任务调度线程池』功能加入之前,可以使用 java.util.Timer 来实现定时功能,Timer 的优点在于简单易用,但由于所有任务都是由同一个线程来调度,因此所有任务都是串行执行的,同一时间只能有一个任务在执行,前一个任务的延迟或异常都将会影响到之后的任务。示例代码如下:
java
// 使用 timer 添加两个任务,希望它们都在 1s 后执行
@Test
public void timerTest() {
    Timer timer = new Timer();
    TimerTask task1 = new TimerTask() {
        @Override
        public void run() {
            log.debug("task 1");
            try {
                Thread.sleep(2000);
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
        }
    };
    TimerTask task2 = new TimerTask() {
        @Override
        public void run() {
            log.debug("task 2");
        }
    };

    log.debug("start...");
    // 但由于 timer 内只有一个线程来顺序执行队列中的任务,因此『任务1』的延时,影响了『任务2』的执行
    timer.schedule(task1, 1000);
    timer.schedule(task2, 1000);
}
输出结果:
java
2023-03-01 23:07:37.376 [main] DEBUG c.m.c.pool.TimerForScheduleTest - start...
2023-03-01 23:07:38.380 [Timer-0] DEBUG c.m.c.pool.TimerForScheduleTest - task 1
2023-03-01 23:07:40.384 [Timer-0] DEBUG c.m.c.pool.TimerForScheduleTest - task 2
使用 ScheduledExecutorService 改写:
java
@Test
public void newScheduledThreadPoolTest() throws InterruptedException {
    ScheduledExecutorService pool = Executors.newScheduledThreadPool(1);
    log.debug("start...");
    pool.schedule(() -> {
        log.debug("task1");
    }, 1, TimeUnit.SECONDS);

    pool.schedule(() -> {
        log.debug("task2");
    }, 1, TimeUnit.SECONDS);
    Thread.sleep(3000);
}
输出结果:
java
2023-03-01 23:10:53.164 [main] DEBUG c.m.c.pool.TimerForScheduleTest - start...
2023-03-01 23:10:54.202 [pool-1-thread-1] DEBUG c.m.c.pool.TimerForScheduleTest - task1
2023-03-01 23:10:54.202 [pool-1-thread-1] DEBUG c.m.c.pool.TimerForScheduleTest - task2
实现原理概述
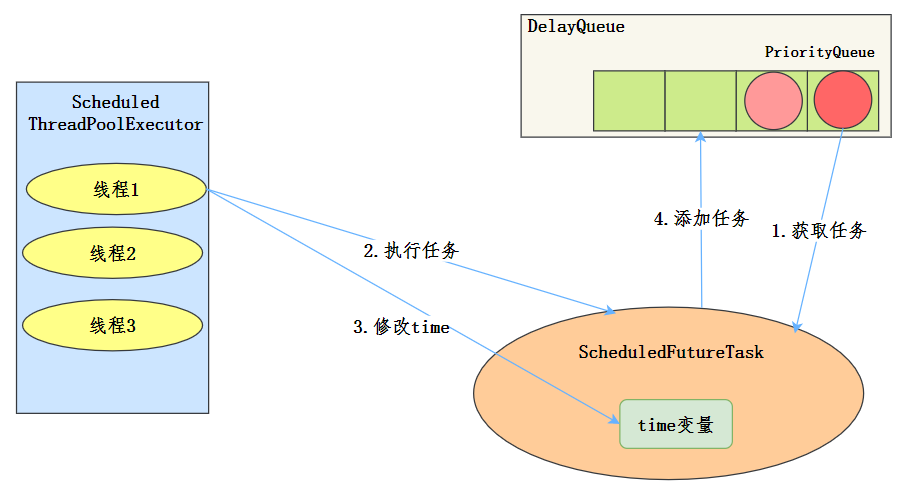
使用的任务队列 DelayQueue 封装了一个 PriorityQueue,会对队列中的任务进行排序,时间早的任务先被执行(即 ScheduledFutureTask 的 time 变量小的先执行),如果 time 相同则先提交的任务会被先执行( ScheduledFutureTask 的 squenceNumber 变量小的先执行)。
执行周期任务步骤:
- 线程从 DelayQueue 中获取已到期的
ScheduledFutureTask(DelayQueue.take())。到期任务是指ScheduledFutureTask的time大于等于当前系统的时间; - 执行这个
ScheduledFutureTask; - 修改
ScheduledFutureTask的time变量为下次将要被执行的时间; - 把这个修改
time之后的ScheduledFutureTask放回DelayQueue中DelayQueue.add()。
newSingleThreadScheduledExecutor
java
public static ScheduledExecutorService newSingleThreadScheduledExecutor() {
    return new DelegatedScheduledExecutorService(new ScheduledThreadPoolExecutor(1));
}

public static ScheduledExecutorService newSingleThreadScheduledExecutor(ThreadFactory threadFactory) {
    return new DelegatedScheduledExecutorService(new ScheduledThreadPoolExecutor(1, threadFactory));
}
newSingleThreadScheduledExecutor 创建只有一个工作线程的可定时调度线程池。如果内部工作线程由于执行周期任务异常而被终止,则会新建一个线程替代它的位置。注意与 newScheduledThreadPool 的区别是:
- 通过
newSingleThreadScheduledExecutor创建的线程池保证内部只有一个线程执行任务,并且线程数不可扩展。 - 通过
newScheduledThreadPool(1, threadFactory)创建的线程池可以通过setCorePoolSize方法来修改核心线程数。
newWorkStealingPool(JDK 1.8 新增)
java
public class Executors {
    public static ExecutorService newWorkStealingPool(int parallelism) {
        return new ForkJoinPool
            (parallelism,
             ForkJoinPool.defaultForkJoinWorkerThreadFactory,
             null, true);
    }

    public static ExecutorService newWorkStealingPool() {
        return new ForkJoinPool
            (Runtime.getRuntime().availableProcessors(),
             ForkJoinPool.defaultForkJoinWorkerThreadFactory,
             null, true);
    }
    // ...省略
}
newWorkStealingPool 是 JDK 1.8 新增的线程池类型,创建一个持有足够线程的线程池,达到快速运算的目的,在内部通过使用多个队列来减少各个线程调度产生的竞争。
足够的线程指 JDK 根据当前线程的运行需求向操作系统申请足够的线程,以保障线程的快速执行,并很大程度地使用系统资源,提高并发计算的效率,省去用户根据 CPU 资源估算并行度的过程。开发者也可以通过带参数的重载方法指定线程的并发数。
Executors 综合示例
java
@Slf4j
public class ExecutorsDemo {

    // newCachedThreadPool 方法获取线程池测试
    @Test
    public void newCachedThreadPoolTest1() {
        // 1.使用工厂类获取线程池对象
        ExecutorService es = Executors.newCachedThreadPool();
        // 2.提交任务
        for (int i = 1; i <= 10; i++) {
            es.submit(new MyRunnable(i));
        }
    }

    // newCachedThreadPool 方法获取线程池测试
    @Test
    public void newCachedThreadPoolTest2() {
        // 1.使用工厂类获取线程池对象
        ExecutorService es = Executors.newCachedThreadPool(new ThreadFactory() {
            int n = 1;

            @Override
            public Thread newThread(Runnable r) {
                return new Thread(r, "自定义的线程名称" + n++);
            }
        });
        // 2.提交任务
        for (int i = 1; i <= 10; i++) {
            es.submit(new MyRunnable(i));
        }
    }

    // newFixedThreadPool 方法获取线程池测试
    @Test
    public void newFixedThreadPoolTest1() {
        // 1.使用工厂类获取线程池对象
        ExecutorService es = Executors.newFixedThreadPool(3);
        // 2.提交任务
        for (int i = 1; i <= 10; i++) {
            es.submit(new MyRunnable(i));
        }
    }

    // newFixedThreadPool 方法获取线程池测试
    @Test
    public void newFixedThreadPoolTest2() {
        // 1.使用工厂类获取线程池对象
        ExecutorService es = Executors.newFixedThreadPool(3, new ThreadFactory() {
            // int n = 1;
            private AtomicInteger t = new AtomicInteger(1);

            @Override
            public Thread newThread(Runnable r) {
                // return new Thread(r, "自定义的线程名称" + n++);
                return new Thread(r, "自定义的线程名称" + t.getAndIncrement());
            }
        });
        // 2.提交任务
        for (int i = 1; i <= 10; i++) {
            es.submit(new MyRunnable(i));
        }
    }

    // newSingleThreadExecutor 方法获取线程池测试
    @Test
    public void newSingleThreadExecutorTest1() {
        // 1.使用工厂类获取线程池对象
        ExecutorService es = Executors.newSingleThreadExecutor();
        // 2.提交任务
        for (int i = 1; i <= 10; i++) {
            es.submit(new MyRunnable(i));
        }
    }

    // newSingleThreadExecutor 方法获取线程池测试
    @Test
    public void newSingleThreadExecutorTest2() {
        // 1.使用工厂类获取线程池对象
        ExecutorService es = Executors.newSingleThreadExecutor(new ThreadFactory() {
            int n = 1;

            @Override
            public Thread newThread(Runnable r) {
                return new Thread(r, "自定义的线程名称" + n++);
            }
        });
        // 2.提交任务
        for (int i = 1; i <= 10; i++) {
            es.submit(new MyRunnable(i));
        }
    }

    // newSingleThreadExecutor 方法模拟异常处理
    @Test
    public void NewSingleThreadExecutorTest3() throws InterruptedException {
        ExecutorService pool = Executors.newSingleThreadExecutor();
        pool.execute(() -> {
            log.debug("1");
            int i = 1 / 0; // 模拟异常导致线程终止,线程池会创建新线程,保证池的正常工作
        });

        pool.execute(() -> log.debug("2"));
        pool.execute(() -> log.debug("3"));
        Thread.sleep(2000);
    }

    // newScheduledThreadPool 方法获取定时任务线程池,schedule 方法功能测试
    @Test
    public void newScheduledThreadPoolScheduleTest() throws InterruptedException {
        // 1.获取一个具备延迟执行任务的线程池对象
        ScheduledExecutorService es = Executors.newScheduledThreadPool(3);
        // 2.创建多个任务对象,提交任务,每个任务延迟2秒执行
        for (int i = 1; i <= 10; i++) {
            es.schedule(new MyRunnable(i), 2, TimeUnit.SECONDS);
        }
        System.out.println("main thread is over");
        Thread.sleep(4000);
    }

    // newScheduledThreadPool 方法获取定时任务线程池,scheduleAtFixedRate 方法功能测试
    @Test
    public void newScheduledThreadPoolScheduleAtFixedRateTest() throws InterruptedException {
        // 1.获取一个具备延迟执行任务的线程池对象
        ScheduledExecutorService es = Executors.newScheduledThreadPool(1, new ThreadFactory() {
            int n = 1;

            @Override
            public Thread newThread(Runnable r) {
                return new Thread(r, "自定义线程名:" + n++);
            }
        });
        // 2.创建多个任务对象,延迟1秒开始,每间隔2秒执行一个任务(不包含任务实际运行的时间,即任务完成后再算间隔)
        for (int i = 1; i <= 10; i++) {
            es.scheduleAtFixedRate(new MyRunnable2(i), 1, 2, TimeUnit.SECONDS);
        }
        System.out.println("main thread is over");
        Thread.sleep(20000);
    }

    // newScheduledThreadPool 方法获取定时任务线程池,schedule 方法功能测试
    @Test
    public void newSingleThreadScheduledExecutorScheduleWithFixedDelayTest() throws InterruptedException {
        // 1.获取一个具备延迟执行任务的线程池对象
        // 注:这里想更容易看出效果,使用只有一个线程的定时任务线程池
        ScheduledExecutorService es = Executors.newSingleThreadScheduledExecutor(new ThreadFactory() {
            int n = 1;

            @Override
            public Thread newThread(Runnable r) {
                return new Thread(r, "自定义线程名:" + n++);
            }
        });
        // 2.创建多个任务对象,延迟1秒开始,每间隔2秒执行一个任务(包含任务实际运行的时间)
        for (int i = 1; i <= 10; i++) {
            es.scheduleWithFixedDelay(new MyRunnable2(i), 1, 2, TimeUnit.SECONDS);
        }
        System.out.println("main thread is over");
        Thread.sleep(20000);
    }

}

// 用于测试的任务类,包含一个任务编号属性。在任务中,打印出是哪一个线程正在执行任务
class MyRunnable implements Runnable {
    private final int id;

    public MyRunnable(int id) {
        this.id = id;
    }

    @Override
    public void run() {
        // 获取线程的名称输出
        String name = Thread.currentThread().getName();
        System.out.println(name + "执行了任务..." + id);
    }
}

class MyRunnable2 implements Runnable {
    private final int id;

    public MyRunnable2(int id) {
        this.id = id;
    }

    @Override
    public void run() {
        String name = Thread.currentThread().getName();
        try {
            Thread.sleep(1500);
        } catch (InterruptedException e) {
            e.printStackTrace();
        }
        System.out.println(name + "执行了任务:" + id);
    }
}
线程池基础使用
线程池使用 Runnable 接口
步骤
- 通过 Executors 工厂类的静态方法来创建线程池对象:
newFixedThreadPool(int size)
java
// 创建线程池对象
ExecutorService tp = Executors.newFixedThreadPool(线程数量);- 定义Runnable的实现类
- 重写run方法
- 创建Rannable实现类对象
java
MyRunnable mr = new MyRunnable();- 调用
submit(Runnable task)提交任务,每次调用该方法就使用线程池中的一条线程,线程完毕后再放回线程池。
java
tp.submit(mr);
//或者使用匿名内部类的方法传入Runnable对象,调用submit方法
tp.submit(new Runnable(){
    @Override
    public void run(){
        //重写run方法
    }
});- 销毁线程池
shutdown():销毁线程池,要等待线程池中的所有任务执行完成后才销毁。shutdownNow():立即销毁线程池,不管线程池中的任务是否执行完成。(一般比较少用)
线程池的执行任务过程
- 刚开始创建好线程池,没有任务要执行,线程池的线程会等待任务
- 往线程池中提交任务,线程池会派线程执行任务,有些线程没有任务接着等待
- 如果线程池中的任务比线程多,线程池中个的线程执行任务,后面的任务等待,等到线程执行完任务,空闲的时候,就执行后面的任务
- 如果所有任务都执行完,线程就等待任务,直到线程池被销毁,这些线程也就销毁
线程池使用 Callable 接口
Callable 接口作用
定义子线程需要执行的代码,是有返回结果并且可以抛出异常的任务。
更多 Callable 接口内容详见《并发编程 - 多线程》笔记相关章节。
Callable 使用线程池的步骤
- 获取线程池
java
// 使用Executors的静态方法,定义创建的线程池的线程数量
public static ExecutorService newFixedThreadPool(int nThreads);

// 例如:
ExecutorService tp = Executors.newFixedThreadPool(线程数量);- 定义 Callable 的实现类
- 重写 call 方法
- 创建 Callable 实现类对象
java
MyCallable mc = new MyCallable();- 往线程池中调用
submit(Callable<T> task)提交任务
java
tp.submit(mc);
// 或者使用匿名内部类的方法传入Callable对象,调用submit方法
tp.submit(new Callable(){
    @Override
    public void call(){
        // 重写run方法
    }
});- 销毁线程池
shutdown()
注意:可以同时往线程池中提交 Runnable 和 Callable 任务
处理线程池执行任务异常
方式1:主动捉异常
java
@Test
public void catchThreadExceptionTest() {
    ExecutorService pool = Executors.newFixedThreadPool(1);
    pool.submit(() -> {
        try {
            log.debug("task1");
            int i = 1 / 0;
        } catch (Exception e) {
            log.error("error:", e);
        }
    });
}
方式2:使用 Future
java
@Test
public void futureExceptionTest() throws ExecutionException, InterruptedException {
    ExecutorService pool = Executors.newFixedThreadPool(1);
    Future<Boolean> f = pool.submit(() -> {
        log.debug("task1");
        int i = 1 / 0;
        return true;
    });
    log.debug("result:{}", f.get());
}
线程池的工作原理
Java 线程池的工作原理为:JVM 先根据用户的参数创建一定数量的可运行的线程任务,并将线程任务放入队列,然后在线程创建后启动这些任务,如果线程数量超过了最大数量(由用户设置),则超出数量的线程排队等候,等其它线程执行完毕,线程池调度器发现队列中有可用的线程时,再从队列中取出任务来执行。
线程池工作流程
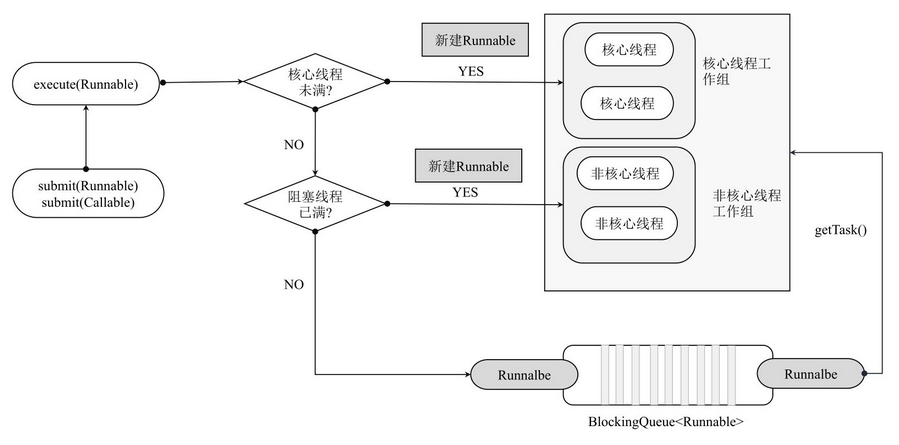
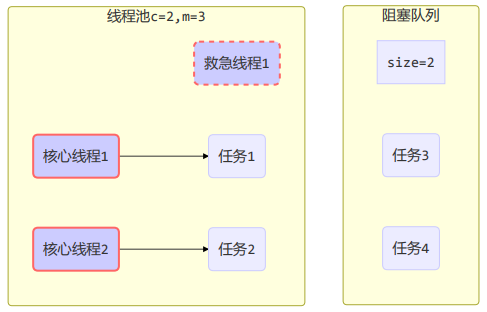
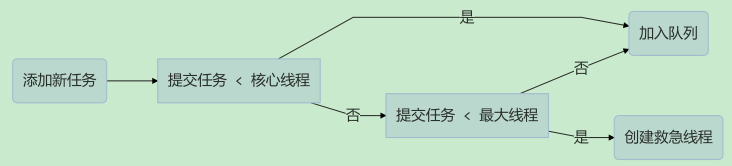
- Java 线程池刚被创建时,只是向系统申请一个用于执行线程队列和管理线程池的线程资源,池中没有线程。在调用
execute()方法添加一个任务时,线程池会按照以下判断执行任务:- 如果正在运行的线程数量少于核心线程数
corePoolSize(用户定义的),线程池就会立刻创建线程并执行该线程任务。 - 如果正在运行的线程数量大于等于核心线程数
corePoolSize,线程池里面的线程会一直存活着,就算空闲时间超过了keepAliveTime,线程也不会被销毁,而是一直阻塞在那里一直等待任务队列的任务来执行。 - 如果正在运行的线程数量等于核心线程数
corePoolSize(没有空闲的线程),此时对于一个新提交的任务,线程池会将该任务放入阻塞的任务队列workQueue排队等待执行,直到有空闲的线程。 - 在阻塞队列已满且正在运行的线程数量少于
maximumPoolSize时(假设maximumPoolSize > corePoolSize),线程池会创建非核心线程(救急线程)立刻执行该线程任务,直到线程数达到maximumPoolSize,就不会再创建了。 - 在阻塞队列已满且正在运行的线程数量大于等于
maximumPoolSize时,如果还有新的任务过来,线程池直接采用拒绝策略进行处理。默认是拒绝执行该线程任务并抛出RejectExecutionException异常。jdk 提供了 4 种拒绝策略实现(其它框架也提供了实现):AbortPolicy:让调用者抛出RejectedExecutionException异常(默认策略)CallerRunsPolicy:让调用者运行任务DiscardPolicy:放弃本次任务DiscardOldestPolicy:放弃队列中最早的任务,本任务取而代之- Dubbo 的实现:在抛出 RejectedExecutionException 异常之前会记录日志,并 dump 线程栈信息,方便定位问题
- Netty 的实现:是创建一个新线程来执行任务
- ActiveMQ 的实现:带超时等待(60s)尝试放入队列,类似我们之前自定义的拒绝策略
- PinPoint 的实现:它使用了一个拒绝策略链,会逐一尝试策略链中每种拒绝策略
- 如果正在运行的线程数量少于核心线程数
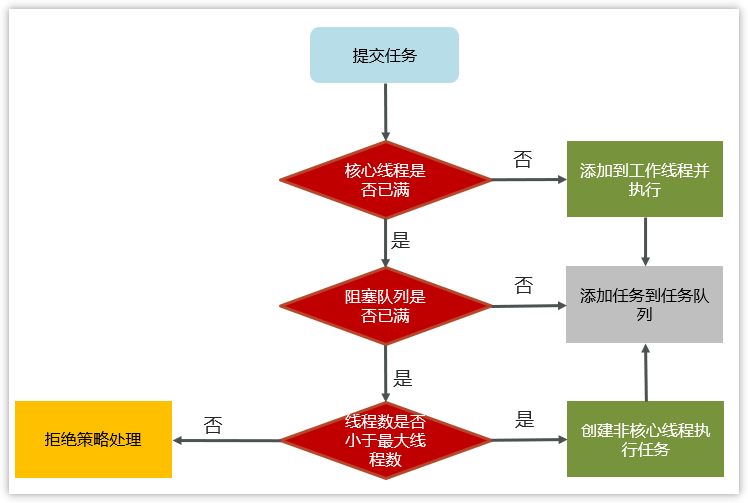
- 在线程任务执行完毕后,该任务将从线程池队列中移除,线程池将从队列中取下一个线程任务继续执行。(即上图中的工作线程与非核心线程到任务队列中取下一个任务)
- 在线程处于空闲状态的时间超过
keepAliveTime时间(unit参数用于指定keepAliveTime参数的单位)时,正在运行的线程数量超过corePoolSize,该线程将会停止被认定为空闲的线程。因此在线程池中所有线程任务都执行完毕后,线程池会收缩到corePoolSize大小。
线程池与阻塞队列示例
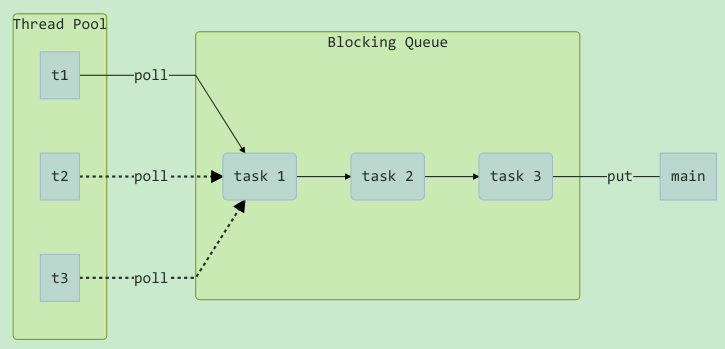
线程复用原理(待整理代码)
在 Java 中,每个 Thread 类都有一个 start 方法。在程序调用 start 方法启动线程时,Java 虚拟机会调用该类的 run 方法。Thread 类的 run 方法中其实调用了 Runnable 对象的 run 方法,例如定义继承 Thread 类,在循环中不断传递进来的 Runnable 对象来创建线程,再调用 start 方法开启线程,就相当于不断执行 run 方法中的代码。因此可以将在循环方法中不断获取的 Runnable 对象存放在 Queue 中,当前线程在获取下一个 Runnable 对象之前可以是阻塞的,这样既能有效控制正在执行的线程个数,也能保证系统中正在等待执行的其他线程有序执行。
以下就是简单实现了一个线程池,达到了线程复用的效果。
TODO: 待整理代码实现
扩展内容
自定义线程池实战
此部分根据线程池涉及的相关元素,自定义一个线程池实现示例
自定义线程池整体架构设计图
实现示例
自定义拒绝策略接口
java
@FunctionalInterface // 拒绝策略
interface RejectPolicy<T> {
    void reject(BlockingQueue<T> queue, T task);
}
自定义任务队列
java
@Slf4j
class BlockingQueue<T> {
    // 1. 任务队列
    private Deque<T> queue = new ArrayDeque<>();

    // 2. 锁
    private ReentrantLock lock = new ReentrantLock();

    // 3. 生产者条件变量
    private Condition fullWaitSet = lock.newCondition();

    // 4. 消费者条件变量
    private Condition emptyWaitSet = lock.newCondition();

    // 5. 容量
    private int capcity;

    public BlockingQueue(int capcity) {
        this.capcity = capcity;
    }

    // 带超时阻塞获取
    public T poll(long timeout, TimeUnit unit) {
        lock.lock();
        try {
            // 将 timeout 统一转换为 纳秒
            long nanos = unit.toNanos(timeout);
            while (queue.isEmpty()) {
                try {
                    // 返回值是剩余时间
                    if (nanos <= 0) {
                        return null;
                    }
                    nanos = emptyWaitSet.awaitNanos(nanos);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
            T t = queue.removeFirst();
            fullWaitSet.signal();
            return t;
        } finally {
            lock.unlock();
        }
    }

    // 阻塞获取
    public T take() {
        lock.lock();
        try {
            while (queue.isEmpty()) {
                try {
                    emptyWaitSet.await();
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
            T t = queue.removeFirst();
            fullWaitSet.signal();
            return t;
        } finally {
            lock.unlock();
        }
    }

    // 阻塞添加
    public void put(T task) {
        lock.lock();
        try {
            while (queue.size() == capcity) {
                try {
                    log.debug("等待加入任务队列 {} ...", task);
                    fullWaitSet.await();
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
            log.debug("加入任务队列 {}", task);
            queue.addLast(task);
            emptyWaitSet.signal();
        } finally {
            lock.unlock();
        }
    }

    // 带超时时间阻塞添加
    public boolean offer(T task, long timeout, TimeUnit timeUnit) {
        lock.lock();
        try {
            long nanos = timeUnit.toNanos(timeout);
            while (queue.size() == capcity) {
                try {
                    if (nanos <= 0) {
                        return false;
                    }
                    log.debug("等待加入任务队列 {} ...", task);
                    nanos = fullWaitSet.awaitNanos(nanos);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
            log.debug("加入任务队列 {}", task);
            queue.addLast(task);
            emptyWaitSet.signal();
            return true;
        } finally {
            lock.unlock();
        }
    }

    public int size() {
        lock.lock();
        try {
            return queue.size();
        } finally {
            lock.unlock();
        }
    }

    public void tryPut(RejectPolicy<T> rejectPolicy, T task) {
        lock.lock();
        try {
            // 判断队列是否满
            if (queue.size() == capcity) {
                rejectPolicy.reject(this, task);
            } else {  // 有空闲
                log.debug("加入任务队列 {}", task);
                queue.addLast(task);
                emptyWaitSet.signal();
            }
        } finally {
            lock.unlock();
        }
    }
}
自定义线程池
java
// 自定义线程池
@Slf4j
class ThreadPool {
    // 任务队列
    private BlockingQueue<Runnable> taskQueue;

    // 线程集合
    private HashSet<Worker> workers = new HashSet<>();

    // 核心线程数
    private int coreSize;

    // 获取任务时的超时时间
    private long timeout;

    private TimeUnit timeUnit;

    private RejectPolicy<Runnable> rejectPolicy;

    // 执行任务
    public void execute(Runnable task) {
        // 当任务数没有超过 coreSize 时,直接交给 worker 对象执行
        // 如果任务数超过 coreSize 时,加入任务队列暂存
        synchronized (workers) {
            if (workers.size() < coreSize) {
                Worker worker = new Worker(task);
                log.debug("新增 worker{}, {}", worker, task);
                workers.add(worker);
                worker.start();
            } else {
                // taskQueue.put(task);
                // 1) 死等
                // 2) 带超时等待
                // 3) 让调用者放弃任务执行
                // 4) 让调用者抛出异常
                // 5) 让调用者自己执行任务
                taskQueue.tryPut(rejectPolicy, task);
            }
        }
    }

    public ThreadPool(int coreSize, long timeout, TimeUnit timeUnit, int queueCapcity, RejectPolicy<Runnable> rejectPolicy) {
        this.coreSize = coreSize;
        this.timeout = timeout;
        this.timeUnit = timeUnit;
        this.taskQueue = new BlockingQueue<>(queueCapcity);
        this.rejectPolicy = rejectPolicy;
    }

    class Worker extends Thread {
        private Runnable task;

        public Worker(Runnable task) {
            this.task = task;
        }

        @Override
        public void run() {
            // 执行任务
            // 1) 当 task 不为空,执行任务
            // 2) 当 task 执行完毕,再接着从任务队列获取任务并执行
            // while(task != null || (task = taskQueue.take()) != null) {
            while (task != null || (task = taskQueue.poll(timeout, timeUnit)) != null) {
                try {
                    log.debug("正在执行...{}", task);
                    task.run();
                } catch (Exception e) {
                    e.printStackTrace();
                } finally {
                    task = null;
                }
            }
            synchronized (workers) {
                log.debug("worker 被移除{}", this);
                workers.remove(this);
            }
        }
    }
}
测试
java
public static void main(String[] args) {
    ThreadPool threadPool = new ThreadPool(1, 1000, TimeUnit.MILLISECONDS,
                        1, (queue, task) -> {
        // 1. 死等
        // queue.put(task);
        // 2) 带超时等待
        // queue.offer(task, 1500, TimeUnit.MILLISECONDS);
        // 3) 让调用者放弃任务执行
        // log.debug("放弃{}", task);
        // 4) 让调用者抛出异常
        // throw new RuntimeException("任务执行失败 " + task);
        // 5) 让调用者自己执行任务
        task.run();
    });
    for (int i = 0; i < 4; i++) {
        int j = i;
        threadPool.execute(() -> {
            try {
                Thread.sleep(1000L);
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
            log.debug("{}", j);
        });
    }
}
Tomcat 线程池
Tomcat 的线程池主要体现在以下几点:
- LimitLatch 用来限流,可以控制最大连接个数,类似 J.U.C 中的 Semaphore
- Acceptor 只负责【接收新的 socket 连接】
- Poller 只负责监听 socket channel 是否有【可读的 I/O 事件】
- 一旦可读,封装一个任务对象(socketProcessor),提交给 Executor 线程池处理
- Executor 线程池中的工作线程最终负责【处理请求】
Tomcat 线程池扩展了 ThreadPoolExecutor,具体实现有所不同:如果总线程数达到 maximumPoolSize,这时不会立刻抛 RejectedExecutionException 异常,而是再次尝试将任务放入队列,如果还失败,才抛出 RejectedExecutionException 异常
tomcat-7.0.42 源码节选
java
public void execute(Runnable command, long timeout, TimeUnit unit) {
    submittedCount.incrementAndGet();
    try {
        super.execute(command);
    } catch (RejectedExecutionException rx) {
        if (super.getQueue() instanceof TaskQueue) {
            final TaskQueue queue = (TaskQueue) super.getQueue();
            try {
                if (!queue.force(command, timeout, unit)) {
                    submittedCount.decrementAndGet();
                    throw new RejectedExecutionException("Queue capacity is full.");
                }
            } catch (InterruptedException x) {
                submittedCount.decrementAndGet();
                Thread.interrupted();
                throw new RejectedExecutionException(x);
            }
        } else {
            submittedCount.decrementAndGet();
            throw rx;
        }
    }
}
TaskQueue.java
java
public boolean force(Runnable o, long timeout, TimeUnit unit) throws InterruptedException {
    if (parent.isShutdown())
        throw new RejectedExecutionException(
                "Executor not running, can't force a command into the queue"
        );
    return super.offer(o, timeout, unit); //forces the item onto the queue, to be used if the task is rejected
}
相关配置项
Connector 配置
| 配置项 | 默认值 | 说明 |
|---|---|---|
acceptorThreadCount | 1 | acceptor 线程数量 |
pollerThreadCount | 1 | poller 线程数量 |
minSpareThreads | 10 | 核心线程数,即 corePoolSize |
maxThreads | 200 | 最大线程数,即 maximumPoolSize |
executor | - | Executor 名称,用来引用下面的 Executor |
Executor 线程配置
| 配置项 | 默认值 | 说明 |
|---|---|---|
threadPriority | 5 | 线程优先级 |
daemon | true | 是否守护线程 |
minSpareThreads | 25 | 核心线程数,即 corePoolSize |
maxThreads | 200 | 最大线程数,即 maximumPoolSize |
maxIdleTime | 60000 | 线程生存时间,单位是毫秒,默认值即 1 分钟 |
maxQueueSize | Integer.MAX_VALUE | 队列长度 |
prestartminSpareThreads | false | 核心线程是否在服务器启动时启动 |